
AI 内容创作 / 系统课时
测试集与主观评审设计
测试集与主观评审设计
数字人质量评测不能只依赖少量演示片段。本课将把真实业务拆成可覆盖、可复现的测试样本,并建立盲测、评分、问题标签和复测闭环,使评审结果能够指导模型、驱动与渲染链路的改进。
学习目标
- 能够按场景、人物、语言和异常条件构建代表性测试集。
- 能够设计盲测流程、评分量表与评审一致性检查。
- 能够把低分样本归因到可执行的问题标签和修复责任域。
测试集设计原则
测试集的基本单位应是一条可复现的交互样本,而不是一段无法追踪来源的视频。每条样本至少记录输入文本或音频、角色版本、模型版本、渲染配置、期望行为和验收维度。这样发现问题后,团队才能在相同条件下重放并验证修复效果。
代表性来自分层覆盖。业务场景可按客服问答、营销播报、教学讲解和开放对话分组;人物表现可覆盖不同音色、语速、情绪和动作强度;技术边界还要包含长文本、数字与英文混读、弱网、插话和连续会话。核心测试集保持稳定,探索集则用于吸收新故障和新需求。
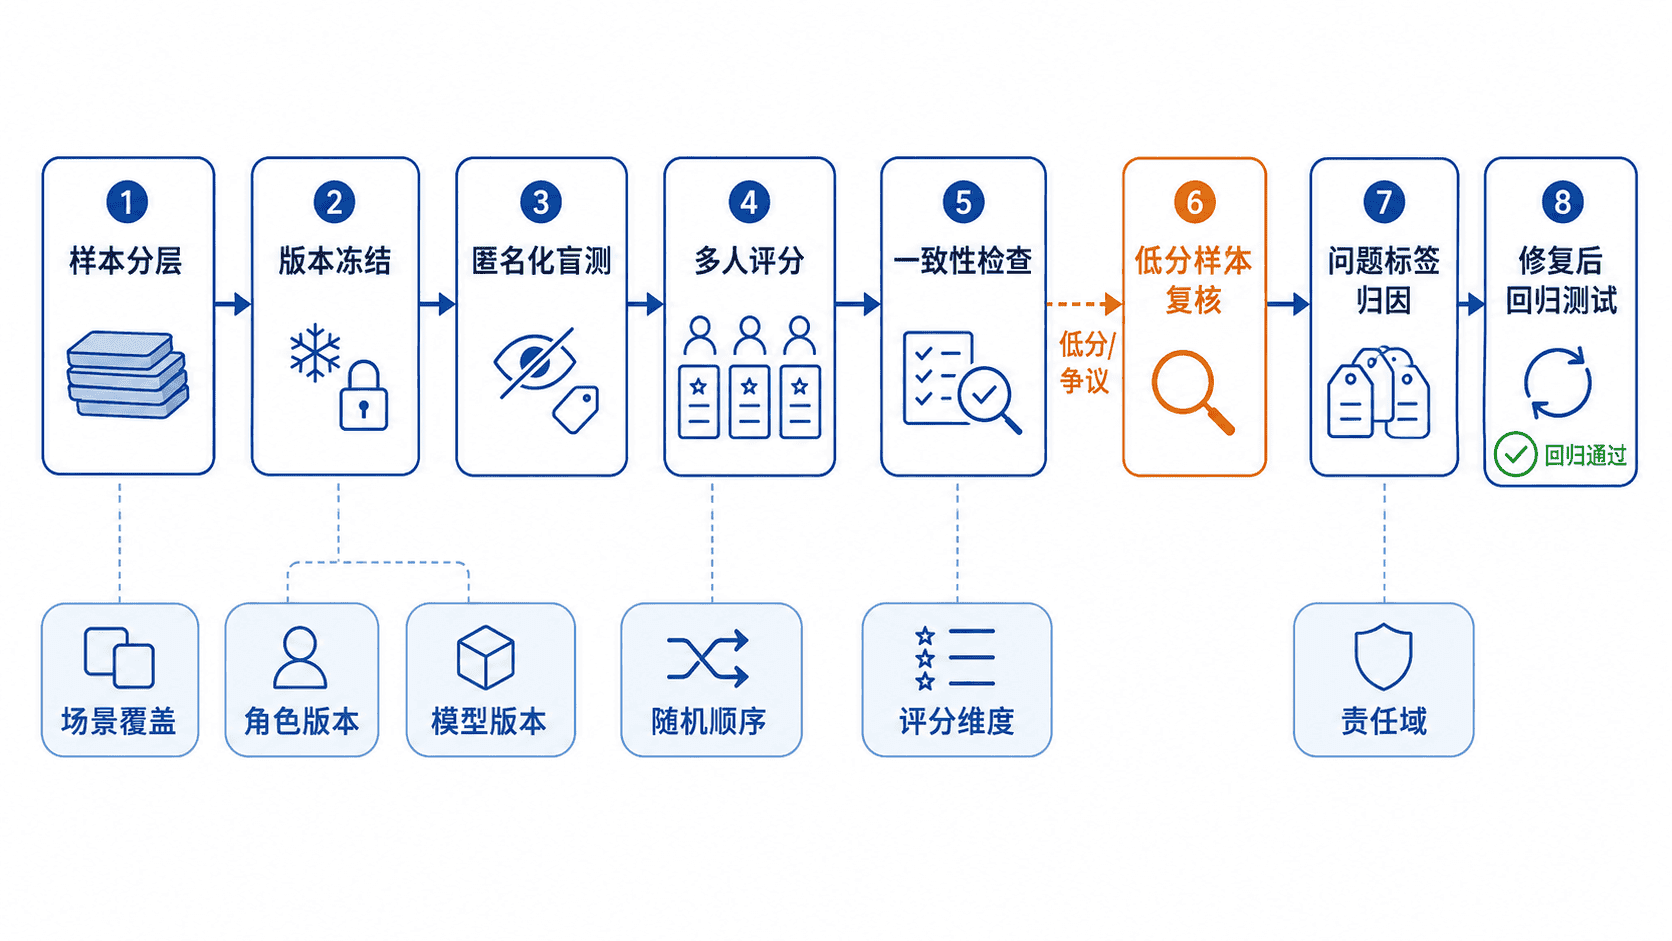
按共享人物、音频来源、脚本族或完整会话分组切分,避免同源改写、切片或同次会话跨入调参和验收集。划分前先说明泛化对象。例如要测未见人物,就按人物切分;只测固定签约角色的新脚本,则按脚本族切分并如实报告限制。线上回放先验证授权和最小化要求。冻结验收集版本,故障回放可单独更新。
盲测、量表与一致性
盲测隐藏候选模型与供应商,让评审者看到必要任务背景及参考事实。成对比较时平衡 A/B、B/A 顺序,防止试听顺序偏差;记录随机种子或分配表。上线要求的合成提示可在候选间一致呈现,控制评测条件时应继续保护评审者的知情权。独立打分后再讨论,有争议则由第三人按同一锚点复核。语音主观评测可借鉴 ITU-T 的听评方法,课程的多模态量表使用下方业务锚点。ITU-T P.800
| 评分维度 | 1 分锚点 | 3 分锚点 | 5 分锚点 |
|---|---|---|---|
| 自然度 | 明显机械或停顿异常 | 基本连贯但仍有合成感 | 连贯自然且节奏稳定 |
| 口型同步 | 持续错位或音素不匹配 | 偶有偏差但不影响理解 | 关键音素与开合时序一致 |
| 信息准确性 | 存在关键事实错误 | 核心意思正确但有小偏差 | 内容完整且事实、数字准确 |
| 角色一致性 | 音色、形象或动作明显漂移 | 少量漂移但身份可识别 | 全程保持设定与风格一致 |
权重在评测前冻结。每条结果同时保留各维度原始分、平均分、评分差和问题标签。严重事实错误可设硬门槛。某一维度两名评审者相差至少 2 分时进入复核,先保留原始分,再记录第三人的依据及结论。这个分差是复核规则,一致性统计还需要足够多的样本和评审记录。
完整可运行示例
将代码保存为 review_report.py。示例使用四维量表,标记总分低于 3.5、任一评审给准确性 2 分或更低、任一维度评分差至少 2 分。标记分别保留,即使一条样本的加权分通过。用整数权重表示百分比,比较阈值时保留整数精度。
from collections import Counter

WEIGHTS = {"naturalness": 25, "lip_sync": 25, "accuracy": 35, "identity": 15}
records = [
    ("S01", [(4, 5, 5, 5), (5, 4, 5, 5)], ()),
    ("S02", [(3, 2, 4, 4), (3, 3, 4, 4)], ("sync_delay",)),
    ("S03", [(5, 5, 2, 5), (5, 5, 4, 5)], ("factual_error",)),
]


def assess(reviews):
    dimensions = len(WEIGHTS)
    if len(reviews) < 2 or any(
        len(review) != dimensions
        or any(type(value) is not int or not 1 <= value <= 5 for value in review)
        for review in reviews
    ):
        raise ValueError("require at least two complete 1–5 reviews")

    points = sum(
        sum(value * weight for value, weight in zip(review, WEIGHTS.values()))
        for review in reviews
    )
    flags = []
    if points < 350 * len(reviews):
        flags.append("low_total")
    if any(review[2] <= 2 for review in reviews):
        flags.append("accuracy_review")
    for name, scores in zip(WEIGHTS, zip(*reviews)):
        if max(scores) - min(scores) >= 2:
            flags.append(f"disagreement:{name}")
    return points / (100 * len(reviews)), flags


if __name__ == "__main__":
    tags = Counter()
    for sample_id, reviews, issues in records:
        score, flags = assess(reviews)
        print(f"{sample_id} weighted={score:.2f} {' '.join(flags) or 'PASS'}")
        tags.update(set(issues))
print("issues:", dict(sorted(tags.items())))python review_report.pyS01 weighted=4.75 PASS
S02 weighted=3.38 low_total
S03 weighted=4.30 accuracy_review disagreement:accuracy
issues: {'factual_error': 1, 'sync_delay': 1}S03 总分为 4.30,但准确性有一票 2 分且评审间相差 2 分,应回查参考事实后再作发布决定。按候选版本在同一批样本上比较维度差异,记录缺评和分歧;需要估计不确定性时,按实际抽样单元重采样,例如让同一次会话的片段作为一组。
问题归因与验收闭环
问题标签应描述可观察现象,例如 sync_delay、factual_error、voice_drift、gesture_conflict,不要直接写成“模型不好”。随后再把现象映射到可能责任域:内容错误可能来自检索或对话模型,口型延迟可能来自时间戳、缓冲或渲染,音色漂移可能来自切片、采样率或声学模型版本。
修复验收至少包含三步:先在失败样本上复现,再运行同标签的相邻样本检查是否普遍改善,最后执行稳定核心集确认没有引入回归。通过条件应在修复前写清,例如低分样本加权分不低于 4.0、关键维度无 2 分以下结果、核心集总体分下降不超过 0.1。
常见失误包括只挑“好看”的样本、评审者知道模型来源、评分锚点含糊、把平均分掩盖掉单个严重缺陷,以及修复后只重测一个片段。有效评测必须同时保留样本版本、匿名结果、原始评分、争议处理记录和最终归因。
本课总结
- 代表性测试集需要稳定核心集、边界样本和持续更新的故障回放集共同组成。
- 主观评审要通过匿名化、固定量表、多人独立评分和争议复核降低偏差。
- 分数用于判断质量,问题标签和复现证据用于驱动修复与回归验收。
下一课预告
下一课将学习“肖像、声音与数据授权”,把人物形象、声音样本、训练数据和生成结果的使用边界转化为可核验、可撤回、可审计的授权记录。