
AI 内容创作 / 系统课时
离线数字人视频生成
离线数字人视频生成
离线生成不要求边播边出帧,但必须保证输入可追踪、阶段可重跑、结果可复现。本课把文本、语音、口型、表情、逐帧渲染和音视频编码串成一条任务管线,并用清单与产物校验控制失败范围。
学习目标
- 能够划分离线数字人任务的输入、阶段产物和验收点。
- 能够使用任务清单、内容哈希与阶段缓存提升可重复执行能力。
- 能够运行一个生成合成音频、动画帧并封装为 MP4 的最小示例。
任务管线与阶段产物
离线任务应从不可变输入开始,包括脚本文本、角色资源版本、声音配置、输出分辨率、帧率和编码参数。每个阶段只读取明确输入并写出独立产物,后续阶段通过文件路径、元数据和哈希引用前一阶段,避免在内存中形成无法恢复的长链路。
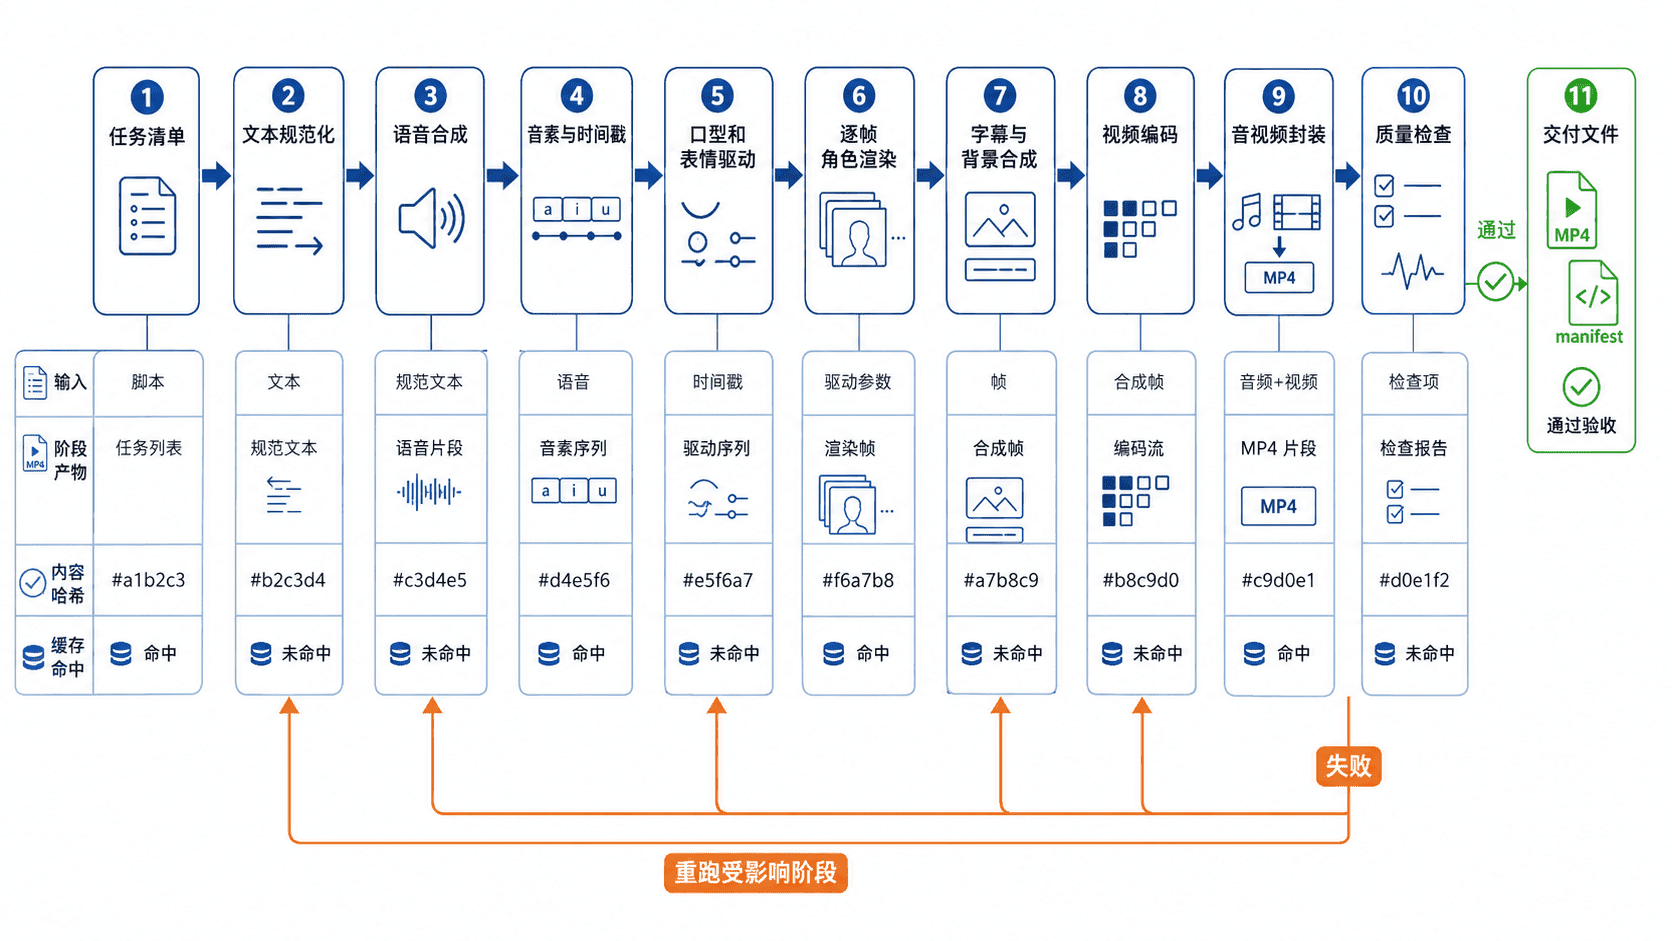
推荐的最小阶段划分是:文本规范化生成稳定脚本;语音模块输出音频与时间戳;驱动模块生成逐帧口型、表情和动作参数;渲染模块输出编号连续的帧;编码模块生成视频流;封装模块把音频、视频与字幕组合为交付文件;质检模块核对时长、帧数、分辨率、编码和音画同步。
阶段之间应保存机器可读的 manifest.json。其中记录输入摘要、工具版本、随机种子、阶段状态、产物哈希和错误信息。任务失败时,从最近一个校验通过的阶段继续,而不是重新合成全部内容。角色模型、字体、声音和提示词发生变化时,应让对应内容哈希失效,防止错误复用旧缓存。
可重复执行与失败恢复
离线生产需要区分“可重试错误”和“确定性错误”。网络超时、临时限流和显存不足可在调整资源后重试;缺失角色文件、时间戳长度不一致和非法编码参数属于确定性错误,应立即停止并返回明确原因。每个阶段只有在文件写入完成且校验通过后,才能把状态改为 SUCCEEDED。同一文件系统内重命名可控制可见性;断电持久化还依赖文件、父目录同步和文件系统契约,不能仅靠重命名保证。
为了保证复现,应固定随机种子、排序输入文件、显式记录帧率与时间基准,并把动态目录写入任务清单。中间文件建议先写入临时名称,再使用原子重命名发布正式产物,避免进程中断后留下看似完整的损坏文件。批量任务还应限制并发,分别控制语音、渲染和编码资源池。
最小可运行生成示例
下面的 Python 程序使用标准库生成 2 秒单声道 WAV 音频和 50 张 PPM 动画帧,再调用 FFmpeg 编码为 H.264/AAC 的 MP4。画面中的嘴部开合与音频包络使用同一时间函数,演示统一时间轴如何驱动离线渲染。运行前需确保 ffmpeg 与 ffprobe 已加入 PATH,FFmpeg 含 libx264 和 AAC 编码器。每次在新运行目录中生成,失败不会覆盖已交付任务。
import json
import math
import shutil
import struct
import subprocess
import wave
from hashlib import sha256
from pathlib import Path
from tempfile import TemporaryDirectory
from uuid import uuid4

WIDTH = 320
HEIGHT = 180
FPS = 25
DURATION_SECONDS = 2
SAMPLE_RATE = 48000
BUILD_DIR = Path("build/offline-demo")

def set_pixel(canvas: bytearray, x: int, y: int, rgb: tuple[int, int, int]) -> None:
    if 0 <= x < WIDTH and 0 <= y < HEIGHT:
        offset = (y * WIDTH + x) * 3
        canvas[offset:offset + 3] = bytes(rgb)

def draw_circle(
    canvas: bytearray,
    cx: int,
    cy: int,
    radius: int,
    rgb: tuple[int, int, int],
) -> None:
    radius_squared = radius * radius
    for y in range(cy - radius, cy + radius + 1):
        for x in range(cx - radius, cx + radius + 1):
            if (x - cx) ** 2 + (y - cy) ** 2 <= radius_squared:
                set_pixel(canvas, x, y, rgb)

def draw_rectangle(
    canvas: bytearray,
    left: int,
    top: int,
    right: int,
    bottom: int,
    rgb: tuple[int, int, int],
) -> None:
    for y in range(top, bottom):
        for x in range(left, right):
            set_pixel(canvas, x, y, rgb)

def envelope(time_seconds: float) -> float:
    # 同一包络同时控制音量和嘴部开合,保持离线驱动一致。
    return 0.25 + 0.75 * abs(math.sin(2.0 * math.pi * 2.0 * time_seconds))

def generate_frames(run_dir: Path) -> int:
    frames_dir = run_dir / "frames"
    frames_dir.mkdir()
    frame_count = FPS * DURATION_SECONDS

    for frame_index in range(frame_count):
        time_seconds = frame_index / FPS
        canvas = bytearray((245, 247, 250)) * (WIDTH * HEIGHT)

        draw_circle(canvas, WIDTH // 2, HEIGHT // 2, 58, (238, 198, 168))
        draw_circle(canvas, WIDTH // 2 - 20, HEIGHT // 2 - 15, 4, (30, 35, 45))
        draw_circle(canvas, WIDTH // 2 + 20, HEIGHT // 2 - 15, 4, (30, 35, 45))

        mouth_height = 4 + int(18 * envelope(time_seconds))
        draw_rectangle(
            canvas,
            WIDTH // 2 - 22,
            HEIGHT // 2 + 22 - mouth_height // 2,
            WIDTH // 2 + 22,
            HEIGHT // 2 + 22 + mouth_height // 2,
            (120, 35, 45),
        )

        frame_path = frames_dir / f"frame-{frame_index:04d}.ppm"
        with frame_path.open("wb") as file:
            file.write(f"P6\n{WIDTH} {HEIGHT}\n255\n".encode("ascii"))
            file.write(canvas)

    return frame_count

def generate_audio(run_dir: Path) -> Path:
    audio_path = run_dir / "audio.wav"
    sample_count = SAMPLE_RATE * DURATION_SECONDS

    with wave.open(str(audio_path), "wb") as audio_file:
        audio_file.setnchannels(1)
        audio_file.setsampwidth(2)
        audio_file.setframerate(SAMPLE_RATE)

        for sample_index in range(sample_count):
            time_seconds = sample_index / SAMPLE_RATE
            amplitude = 0.22 * envelope(time_seconds)
            value = int(32767 * amplitude * math.sin(2.0 * math.pi * 220.0 * time_seconds))
            audio_file.writeframesraw(struct.pack("<h", value))

    return audio_path

def encode_video(run_dir: Path, audio_path: Path) -> Path:
    output_path = run_dir / "offline-digital-human.mp4"
    command = [
        "ffmpeg",
        "-loglevel",
        "error",
        "-y",
        "-framerate",
        str(FPS),
        "-i",
        str(run_dir / "frames" / "frame-%04d.ppm"),
        "-i",
        str(audio_path),
        "-c:v",
        "libx264",
        "-preset",
        "veryfast",
        "-crf",
        "23",
        "-pix_fmt",
        "yuv420p",
        "-c:a",
        "aac",
        "-b:a",
        "128k",
        "-shortest",
        str(output_path),
    ]
    subprocess.run(command, check=True)
    return output_path

def verify_video(video_path: Path, frame_count: int) -> None:
    probe = subprocess.run([
        "ffprobe", "-v", "error", "-count_frames", "-show_streams", "-of", "json", str(video_path),
    ], check=True, capture_output=True, text=True)
    streams = json.loads(probe.stdout)["streams"]
    video = [item for item in streams if item["codec_type"] == "video"]
    audio = [item for item in streams if item["codec_type"] == "audio"]
    if len(video) != 1 or len(audio) != 1:
        raise ValueError("预期各一条音轨和视频轨")
    v, a = video[0], audio[0]
    if (v["codec_name"], v["width"], v["height"], v["pix_fmt"], v["avg_frame_rate"], int(v["nb_read_frames"])) != (
        "h264", WIDTH, HEIGHT, "yuv420p", f"{FPS}/1", frame_count
    ) or (a["codec_name"], a["sample_rate"]) != ("aac", str(SAMPLE_RATE)):
        raise ValueError("编码、帧数或媒体格式与任务不符")
    for stream in (v, a):
        if abs(float(stream["start_time"])) > 1 / FPS or abs(float(stream["duration"]) - DURATION_SECONDS) > 1 / FPS:
            raise ValueError("媒体时间与任务不符")

def write_manifest(run_dir: Path, frame_count: int, audio_path: Path, video_path: Path) -> None:
    manifest_path = run_dir / "manifest.json"
    manifest = {
        "status": "SUCCEEDED",
        "fps": FPS,
        "durationSeconds": DURATION_SECONDS,
        "frameCount": frame_count,
        "audio": {"path": audio_path.name, "sha256": sha256(audio_path.read_bytes()).hexdigest()},
        "video": {"path": video_path.name, "sha256": sha256(video_path.read_bytes()).hexdigest()},
    }
    manifest_path.write_text(
        json.dumps(manifest, ensure_ascii=False, indent=2),
        encoding="utf-8",
    )

def main() -> None:
    if any(shutil.which(tool) is None for tool in ("ffmpeg", "ffprobe")):
        raise RuntimeError("ffmpeg and ffprobe must be on PATH")
    BUILD_DIR.mkdir(parents=True, exist_ok=True)
    final_dir = BUILD_DIR / f"run-{uuid4().hex}"
    with TemporaryDirectory(dir=BUILD_DIR, prefix=".staging-") as folder:
        run_dir = Path(folder)
        frame_count = generate_frames(run_dir)
        audio_path = generate_audio(run_dir)
        video_path = encode_video(run_dir, audio_path)
        verify_video(video_path, frame_count)
        write_manifest(run_dir, frame_count, audio_path, video_path)
        run_dir.rename(final_dir)

    print(f"generated frames: {frame_count}")
    print(f"generated audio: {(final_dir / audio_path.name).as_posix()}")
    print(f"generated video: {(final_dir / video_path.name).as_posix()}")
    print(f"manifest: {(final_dir / 'manifest.json').as_posix()}")

if __name__ == "__main__":
    main()
将代码保存为 offline_digital_human.py。程序会主动检查 FFmpeg 是否存在,使用 Python 3.10 或更高版本运行:
python offline_digital_human.py预期输出:
generated frames: 50
generated audio: build/offline-demo/run-<ID>/audio.wav
generated video: build/offline-demo/run-<ID>/offline-digital-human.mp4
manifest: build/offline-demo/run-<ID>/manifest.json
生成后可使用 ffprobe 验证封装结果:
ffprobe -v error -select_streams v:0 -show_entries stream=codec_name,width,height,r_frame_rate -of default=noprint_wrappers=1 "<实际生成的视频路径>"把命令里的占位符替换为程序输出的视频路径。字段可能以不同顺序出现,编码格式应为 H.264:
codec_name=h264
width=320
height=180
r_frame_rate=25/1
真实项目中,可把 generate_audio() 替换为 TTS 适配器,把 envelope() 替换为音素到视素驱动,把 PPM 绘制替换为角色渲染器;任务入口、统一时间轴、编号帧、编码和清单结构仍可保留。
验收、排错与练习
交付前应检查脚本版本、音频时长、视频帧数、帧率、分辨率、像素格式、音频采样率、字幕边界和最终时长。若理论帧数为 duration × fps,实际帧数明显不符,应先排查时间戳取整、尾帧规则和编码器是否提前结束,而不是直接在封装阶段补时长。
常见故障包括帧文件编号不连续、音频与驱动使用不同时间基准、缓存键遗漏角色版本,以及阶段失败后仍发布最终文件。修复后应删除受影响阶段的缓存并重跑,再用清单和 ffprobe 同时验证产物;只检查文件存在不能证明文件可播放或参数正确。
练习一:为程序增加任务输入哈希。输入包含文本、FPS、时长和角色版本,验收条件是输入不变时哈希一致,任一字段变化时哈希改变。
练习二:增加阶段缓存。先让缓存键包含角色版本、生成参数和工具版本。只有 50 帧逐一验哈希、音频匹配且任务键一致,才跳过生成并在新运行目录中编码;验收时需输出每个阶段的 RUN 或 CACHE_HIT 状态。
本课总结
- 离线数字人生成应拆成可验证、可缓存、可重跑的阶段,而不是一个不可恢复的长函数。
- 统一时间轴、连续帧编号和明确编码参数共同决定最终音画一致性。
- 任务清单与产物校验能够限制失败范围,并为复现和审计提供依据。
下一课预告
后续将继续进入数字人视频的质量验收、批量任务调度与交付自动化,重点关注失败重试、资源并发和结果一致性。