
AI 内容创作 / 系统课时
工程复盘与扩展方向
工程复盘与扩展方向
综合项目交付后,真正决定系统能否持续演进的不是功能数量,而是能否用数据识别瓶颈、解释成本、暴露维护风险,并把扩展需求拆成可验证的阶段。本课将建立一套工程复盘闭环,并据此规划多语言、多角色、端侧运行和业务系统集成路线。
学习目标
- 从性能、模型、成本和维护四个维度组织工程复盘证据。
- 使用统一评分方法确定优化优先级,而不是凭直觉修改系统。
- 为多语言、多角色、端侧运行和业务集成制定分阶段扩展方案。
复盘维度与决策闭环
工程复盘应从真实会话数据出发,把“现象、证据、根因、行动、验证”串成闭环。单看平均延迟容易掩盖长尾问题,单看 GPU 利用率也无法说明用户体验,因此需要同时观察 p50、p95、成功率、资源单价、人工维护时长和故障恢复时间。
| 复盘维度 | 关键问题 | 建议证据 | 典型行动 |
|---|---|---|---|
| 系统瓶颈 | 哪个阶段决定首包和首帧时延 | 分阶段 trace、队列等待、GPU 利用率 | 并行化、缓存、限流或降级 |
| 模型选择 | 质量收益是否覆盖新增时延与成本 | 离线评测、在线 A/B、错误样本 | 切换模型、量化或路由 |
| 成本结构 | 每千次会话的主要成本来自哪里 | GPU、模型 API、存储、带宽账单 | 批处理、复用、冷热分层 |
| 维护风险 | 哪些组件最难诊断和恢复 | 告警噪声、变更记录、MTTR | 标准化接口、回滚和演练 |
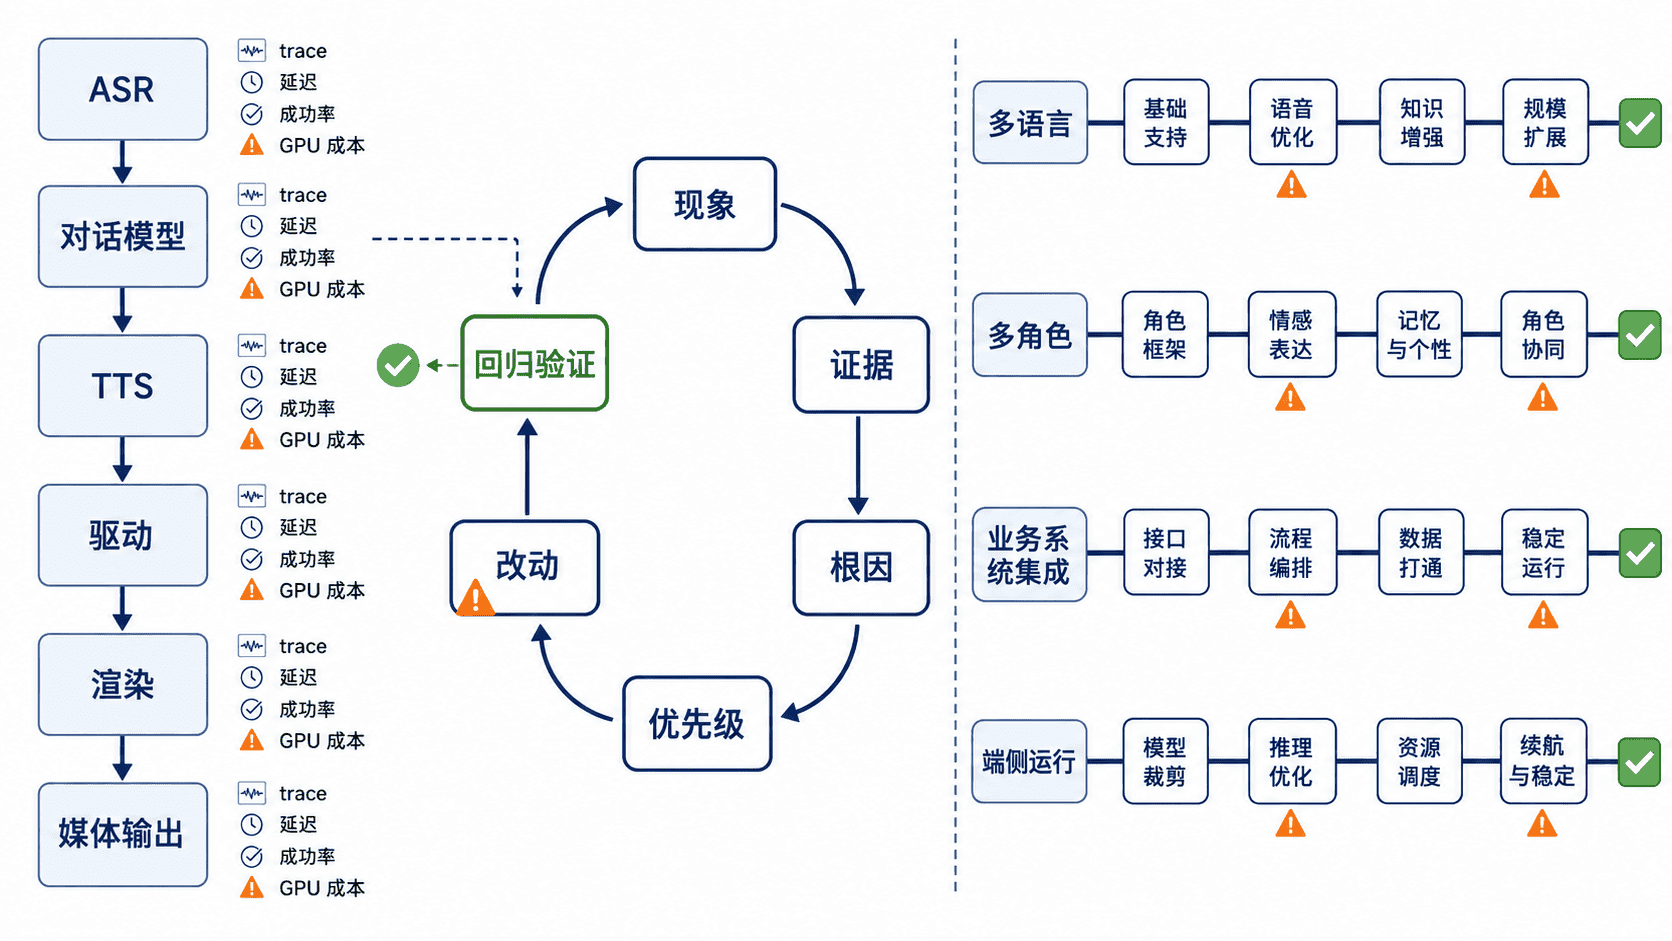
复盘会议必须以可验证结论收尾。例如“模型太慢”不是结论,而“在端到端最慢的 5% 会话中,按同一 trace 的串行关键路径计算,TTS 所占时间的中位比例为 34%;TTS 自身首包 p95 为 620 ms,换流式声码器后目标为 420 ms”才是可执行项。每个行动都应绑定负责人、目标值、回归数据集和回滚条件。
可量化的优化优先级
下面的 Python 程序把各项指标与目标值的偏差转成统一分数,再乘以业务权重。分数越高,表示当前差距越大且影响越重要。示例只使用标准库,可直接保存为 retrospective_priority.py 运行。
from dataclasses import dataclass
from math import isfinite

@dataclass(frozen=True)
class Metric:
    name: str
    current: float
    target: float
    weight: float
    higher_is_better: bool
    action: str

def gap_ratio(metric: Metric) -> float:
    if not all(isfinite(x) for x in (metric.current, metric.target, metric.weight)):
        raise ValueError("评分参数必须有限")
    if metric.target <= 0 or not 0 <= metric.weight <= 1:
        raise ValueError("相对评分要求正目标和 0~1 的权重")
    # 将不同量纲的指标转换为相对目标差距。
    if metric.higher_is_better:
        return max(0.0, (metric.target - metric.current) / metric.target)
    return max(0.0, (metric.current - metric.target) / metric.target)

# 权重应在复盘前确定,避免按结果反向调节。
metrics = [
    Metric("p95_latency_ms", 1850, 1200, 0.30, False, "拆分关键路径并压缩排队时间"),
    Metric("gpu_cost_per_1k", 42, 30, 0.25, False, "启用缓存、批处理和冷热模型分层"),
    Metric("session_success_rate", 0.972, 0.995, 0.25, True, "补齐超时、重试与降级策略"),
    Metric("maintenance_hours_week", 18, 10, 0.20, False, "统一配置、日志字段和回滚流程"),
]

ranked = sorted(
    ((gap_ratio(item) * item.weight, item) for item in metrics),
    key=lambda pair: pair[0],
    reverse=True,
)

for index, (score, item) in enumerate(ranked, start=1):
    print(f"{index}. {item.name}: {score:.3f} -> {item.action}")
运行命令:
python retrospective_priority.py预期输出如下:
1. p95_latency_ms: 0.162 -> 拆分关键路径并压缩排队时间
2. maintenance_hours_week: 0.160 -> 统一配置、日志字段和回滚流程
3. gpu_cost_per_1k: 0.100 -> 启用缓存、批处理和冷热模型分层
4. session_success_rate: 0.006 -> 补齐超时、重试与降级策略
这个排序不是替代工程判断,而是让判断过程可追溯。权重在评审前确定,若要求跨轮可比,应沿用同一口径并核对归一化。零目标适合单独的通过/失败门槛,例如严重缺陷必须为 0,无法套用以目标为分母的公式。对于安全、隐私或合规问题,不应仅按分数排队,而应设置强制阻断条件。
扩展路线与风险控制
多语言扩展不能只替换 ASR 和 TTS 模型,还要统一语言识别、文本规范化、数字读法、字幕断句和质量数据集。多角色扩展则需要把人物资产、声音、动作库、权限和模型缓存从代码中解耦为版本化配置,并限制同机加载数量,防止显存被低频角色长期占用。
业务系统集成应优先定义稳定的会话、事件和回调契约,再连接 CRM、工单、知识库或直播系统。所有写操作都要有幂等键、权限校验和审计记录。若首版不要求离线,端侧运行可单独规划;若隐私、离线或时延是硬约束,则应在立项阶段验证,因为它同时受模型体积、算力、功耗、发热、离线资源和升级机制约束,往往需要量化、模型裁剪或云端与端侧协同。
| 扩展方向 | 首个可验证里程碑 | 主要风险 | 发布门槛 |
|---|---|---|---|
| 多语言 | 新增一种语言完成 100 条核心场景回归 | 读音、断句和文化表达不一致 | 关键指标不低于基线阈值 |
| 多角色 | 运行时切换两个角色且会话状态不丢失 | 资产版本错配、显存峰值 | 切换成功率与资源峰值达标 |
| 业务集成 | 完成只读查询和带审计的写入闭环 | 重复提交、越权和脏数据 | 幂等、权限、回滚测试通过 |
| 端侧运行 | 目标设备离线完成最小对话闭环 | 模型过大、热降频、升级失败 | 时延、功耗和崩溃率达标 |
每条路线都应先建立最小闭环,再扩大范围。一次同时改模型、协议、渲染器和部署方式,会让回归失败难以定位。更稳妥的做法是每个阶段只引入少量变量,并保留旧版本旁路和可观测性。
本课总结
- 工程复盘必须把用户体验、资源成本和维护风险放在同一套证据链中。
- 优化优先级应由目标差距、业务权重和强制门槛共同决定。
- 扩展功能应从最小可验证闭环开始,并为配置、回滚、审计和质量门禁预留接口。
下一课预告
下一课将进入“多模态质量指标体系”,把识别、语音、口型、画面、交互时延和稳定性统一为可采集、可比较、可阻断发布的质量指标。