
AI 内容创作 / 系统课时
AI 数字人的定义与应用边界
AI 数字人的定义与应用边界
本课先建立统一分类标准,帮助你区分虚拟形象、数字分身、虚拟主播与交互式数字人,并从输入方式、实时性、智能程度和风险责任四个维度判断产品边界。
学习目标
- 说清四类数字人产品形态的核心差异
- 根据交互深度与身份绑定程度判断适用场景
- 识别授权、隐私、事实准确性与高风险决策边界
四种产品形态与能力边界
在本教程中,AI 数字人指以可见或可听的数字形象承载表达,并由自动化系统生成、驱动或交互处理至少一部分内容的产品。它不是单一技术名称,外观建模、内容生成、语音能力和实时交互可以按需求组合。
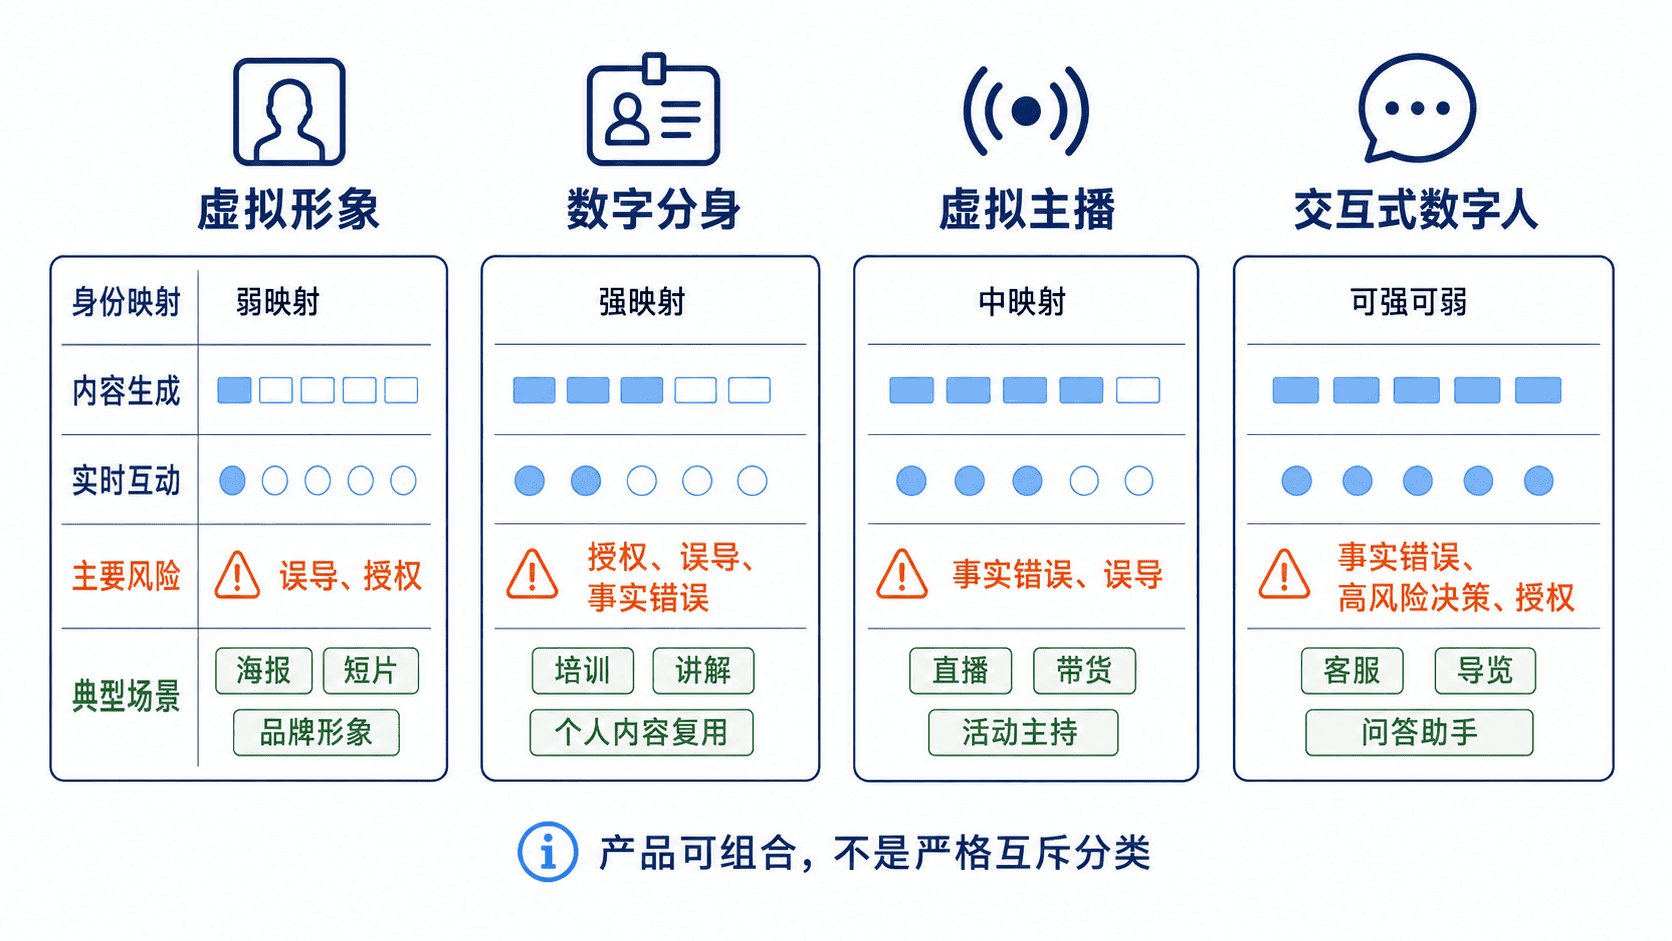
| 产品形态 | 核心特征 | 典型用途 | 关键边界 |
|---|---|---|---|
| 虚拟形象 | 提供可识别的视觉角色,可能完全由人工脚本驱动 | 品牌吉祥物、游戏角色、静态讲解员 | 只有外观不等于具备 AI 或交互能力 |
| 数字分身 | 映射特定个人的外貌、声音或表达风格 | 授权播报、个人知识助手、培训内容 | 必须处理肖像、声音、数据来源与用途授权 |
| 虚拟主播 | 按脚本或生成内容持续播报,可自动切换话术 | 直播讲解、资讯播报、营销展示 | 自动播报不代表能够理解观众或处理复杂追问 |
| 交互式数字人 | 接收用户输入并实时生成回应,同时驱动语音和形象 | 导览、客服、陪练、业务咨询 | 回答可能出错,必须限制知识范围并设置转人工机制 |
判断产品边界
首先判断系统是否需要理解用户输入。只播放预制内容的产品通常属于虚拟形象或虚拟主播;能够根据用户的语音、文字或动作实时作出回应,就具备交互性。按键触发固定分支与理解上下文的开放式问答属于不同的交互深度,可在选型时分别记录。实时说话和口型同步只是表现能力,不能替代语义理解。
其次判断是否绑定真实人物身份。若合成的外貌、声音等能够识别出特定自然人,应把身份映射纳入风险评估,核对采集、训练、生成、公开传播等环节的权利依据。在中国,民法典第一千零一十九条和第一千零二十三条涉及肖像与自然人声音保护。公开可见的资料不会自动产生训练、声音克隆或商用许可。
最后评估错误后果。娱乐、导览和内部培训可以通过提示、知识库和人工复核控制风险;医疗诊断、法律结论、金融交易或身份核验等高风险任务,不应让数字人独立作出最终决定。
场景选择方法
选择产品形态时,先写清用户要完成的任务,再确定需要的自动化程度。若目标只是统一品牌形象,可优先使用虚拟形象;若要批量播报固定内容,可使用虚拟主播;若要代表特定人员表达,需按数字分身治理;若要实时问答,则需要完整的交互链路。
| 场景 | 推荐形态 | 上线前必须具备 |
|---|---|---|
| 展馆循环讲解 | 虚拟形象或虚拟主播 | 固定脚本、字幕校对、播放兜底 |
| 创始人授权课程 | 数字分身 | 明确授权范围、内容审核、撤回机制 |
| 产品咨询与导购 | 交互式数字人 | 知识边界、拒答规则、转人工入口 |
| 娱乐直播互动 | 虚拟主播与交互能力组合 | 延迟控制、敏感内容过滤、异常中断 |
用组合案例检查授权和交互
例如展馆用创始人的授权声音播报,同时由卡通角色回答开放式问题。产品同时具有数字分身和交互式数字人的特点。验收时分别核对训练素材、限定场景与渠道、使用期限、可停用的衍生资产、生成内容标识和超出知识范围时的转接。若授权不允许实时问答,就只用该声音播放批准的稿件,开放式问答可换成已授权的通用声音。面向中国境内提供互联网服务时,另按具体角色和适用范围核对《人工智能生成合成内容标识办法》的界面和文件标识要求。
本课总结
- 数字人分类应同时观察身份映射、内容生成和实时交互,而不能只看外观
- 数字分身的核心风险是身份与授权,交互式数字人的核心风险是回答与决策后果
- 产品形态可以组合,但每增加一项自动化能力,都要补充相应的验证与兜底机制
下一课预告
下一课将学习“数字人系统的核心模块”,沿着用户输入到语音、形象和视频输出的链路,理解各模块如何协作。