
AI 内容创作 / 系统课时
真人素材采集流程
真人素材采集流程
真人素材质量会直接限制数字人的清晰度、口型稳定性和动作自然度。本课将建立从拍摄准备、现场执行到即时验收的标准流程,重点控制机位、光照、背景、录音、发音和头部姿态,并用覆盖矩阵判断素材是否完整。
学习目标
- 能够根据目标模型和交付画幅制定真人素材采集计划。
- 能够在现场稳定控制画面、声音、发音和姿态变量。
- 能够使用即时验收与返工条件,避免把不可用素材带入训练阶段。
采集流程为什么必须标准化
真人素材采集不是普通宣传片拍摄。模型需要在连续帧之间学习稳定的人脸结构、口部变化和姿态关系,因此曝光跳变、自动对焦、光源频闪、背景运动、音频削波或头部越界都会降低可用性。标准流程应把“拍到了什么”与“是否覆盖模型需要的状态”同时记录,而不是只追求单个镜头好看。
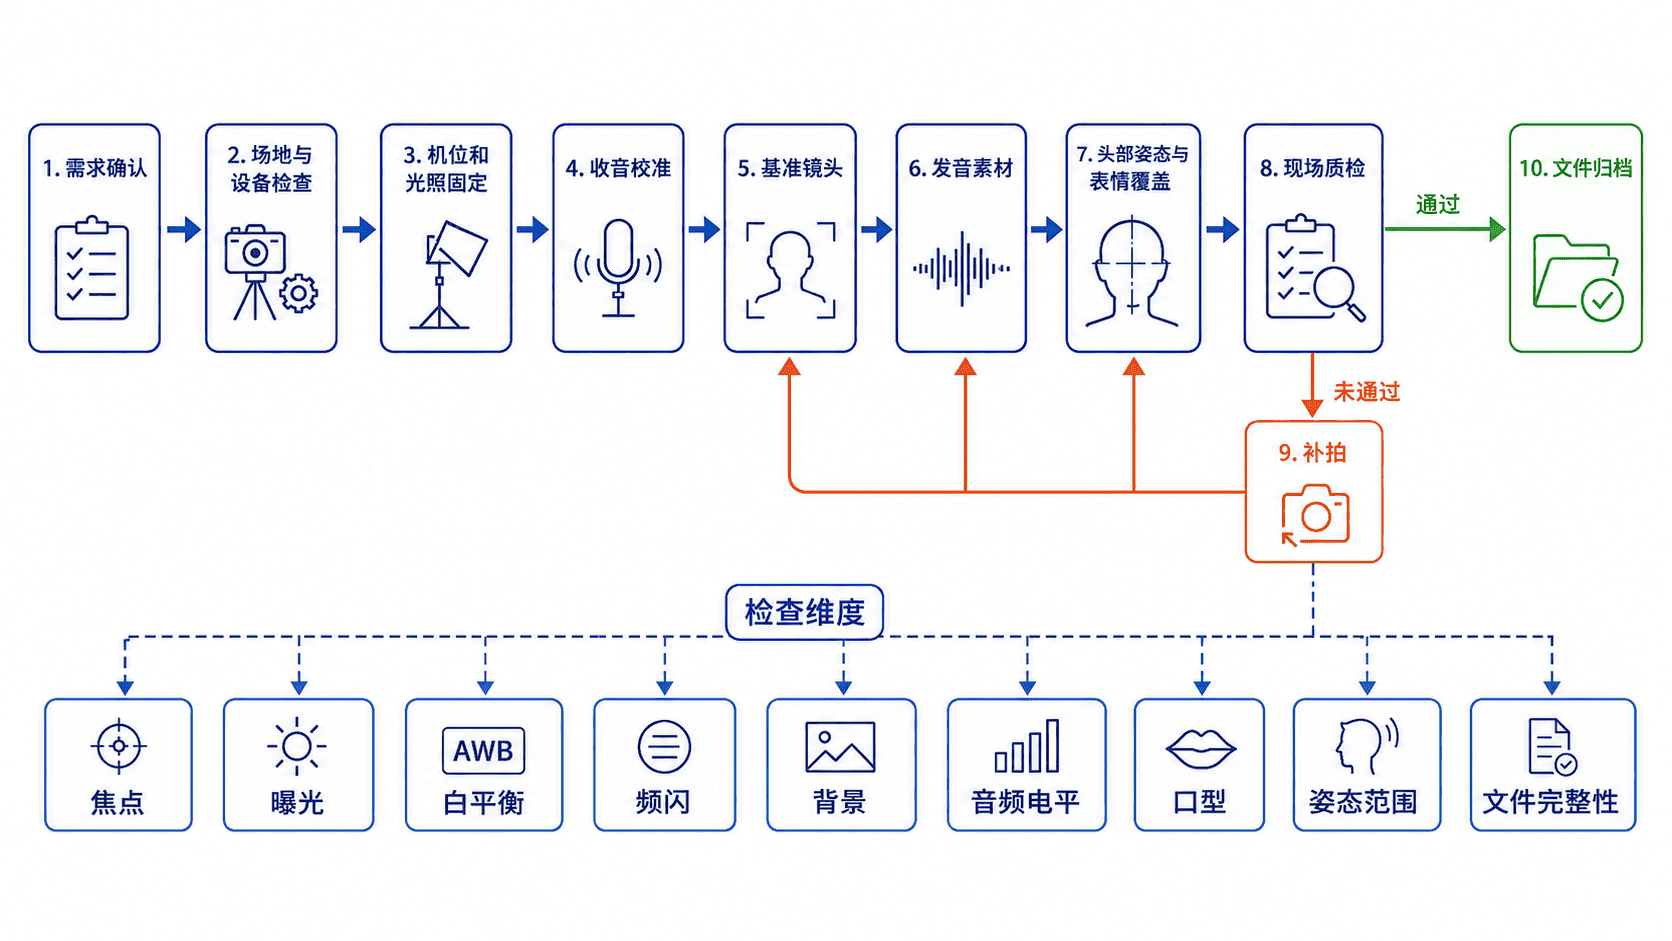
拍摄控制与覆盖矩阵
| 采集维度 | 现场控制要点 | 不合格信号 |
|---|---|---|
| 机位与镜头 | 使用稳定支撑,固定焦距、曝光、白平衡和帧率;机位尽量接近眼平 | 自动对焦来回搜索、画面抖动、景别变化或透视不一致 |
| 光照 | 使用稳定、无明显频闪的主光与补光,保持面部左右亮度可控 | 额头过曝、眼窝过暗、肤色漂移或背景阴影持续变化 |
| 背景 | 选择低纹理、无动态干扰的背景,并保证人物轮廓有足够分离度 | 头发与背景同色、反光物体闪烁、人员走动或屏幕滚动 |
| 声音 | 话筒位置固定,先录环境底噪与房间音;设备和目标流程允许时录制 48 kHz、24 位 PCM,保留原轨,训练副本再按模型需要重采样 | 削波、爆破音、混响过重、底噪突变或口型与声音不同步 |
| 发音 | 语速稳定、停顿自然,覆盖常用音素、数字、日期和项目术语 | 吞音、连续含混、过度表演或关键读音没有覆盖 |
| 姿态与表情 | 先录中性正面,再覆盖小幅左右转头、俯仰、眨眼和指定表情 | 面部被头发或手遮挡、动作越界、快速甩头或表情失控 |
覆盖矩阵应按实际用途建立。基础口播至少包含中性静止、连续自然说话、短句与长句、不同停顿长度,以及项目中高频词汇。若产品会出现英文、数字或专有名词,应在采集脚本中明确加入,而不是期待模型从普通中文句子中自动获得这些口型。
姿态采集遵循“先小后大、先稳定后变化”。先完成正面中性基准,再逐步增加偏航、俯仰和表情强度。每次只改变一个主要变量,便于判断失败来自光照、动作还是发音。若目标系统只支持小范围头动,就不应为了素材丰富而加入大幅侧脸,因为超出部署能力的样本可能增加训练噪声。
现场验收与返工条件
每完成一个素材组,应立即回看原始文件,而不是等拍摄结束后统一检查。画面至少核对焦点、曝光、白平衡、频闪、遮挡和帧连续性;声音至少核对峰值、底噪、爆破音、混响和同步。可随机抽取开头、中段和结尾三个位置,避免只检查第一句。
出现以下情况应当场补拍:人物面部持续失焦,音频出现不可恢复的削波,光照或白平衡在同一条素材中明显变化,背景有人或物体移动,关键音素与术语缺失,头部动作越出规范边界,或文件损坏、时长不完整。可修复的小噪点不等于可忽略的问题,是否保留应以最终训练和驱动测试为准。
录制前确认采集对象允许的使用目的、角色范围、保留期限和可接触人员。分机录音时在同一镜次开头和结尾打板,依据清晰的声音峰与可见接触帧对齐;若开头对齐后结尾仍偏移,需查时钟漂移或录制中断,不能只统一挪一个固定时间量。
归档时要保持视频、音频、脚本和采集记录一一对应。文件名可包含角色、镜次、姿态和状态,例如 actor-a_take-03_front-neutral;同时记录设备参数、日期、异常说明和是否补拍。完成归档后再抽检一次文件数量与校验结果,确保现场“看起来正常”的素材在复制后仍然完整。
用 ffprobe 做初筛
从一个镜次读取容器里的首个视频流字段;字段缺失时应记录未知。媒体结构检查还需配合抽样回看与音画对齐。
ffprobe -v error -select_streams v:0 -show_entries stream=width,height,avg_frame_rate,r_frame_rate,time_base -of json take.mp4平均帧率与标称帧率只供初筛。要确认是否变帧率或是否有掉帧,抽查解码帧的显示时间戳间隔;不要根据这两个帧率字段相等就认定时间轴均匀。
本课总结
- 真人素材采集要同时控制画面稳定性、声音质量和状态覆盖,单纯追求画面美观并不足够。
- 覆盖矩阵应围绕目标数字人的真实使用场景设计,并坚持一次只改变一个主要变量。
- 现场即时验收和明确的补拍条件,是降低训练返工成本最有效的措施之一。
下一课预告
下一阶段将继续把合格素材整理为可训练、可驱动的形象资产,并重点处理数据清洗、标注一致性与质量验证。