
AI 内容创作 / 系统课时
多模态质量指标体系
多模态质量指标体系
数字人质量不是一个总分可以概括的单一属性。识别正确但声音生硬、口型准确但首帧过慢,都会让用户感到系统不可用。本课将建立覆盖识别、语音、口型、画面、交互时延和稳定性的统一指标体系,并用质量门禁示例完成自动判定。
学习目标
- 为六类质量维度选择方向明确、可重复采集的核心指标。
- 统一样本、聚合方式、分位数和阈值口径,避免指标不可比。
- 编写自动质量门禁,定位阻断发布的具体维度。
指标分层与统一口径
指标体系应分为单阶段质量、跨模态一致性、端到端体验和工程稳定性四层。单阶段指标帮助定位模型问题,跨模态指标检查音画关系,端到端指标反映用户等待,稳定性指标则决定系统能否持续提供服务。任何一层失败,都不应被其他维度的高分掩盖。
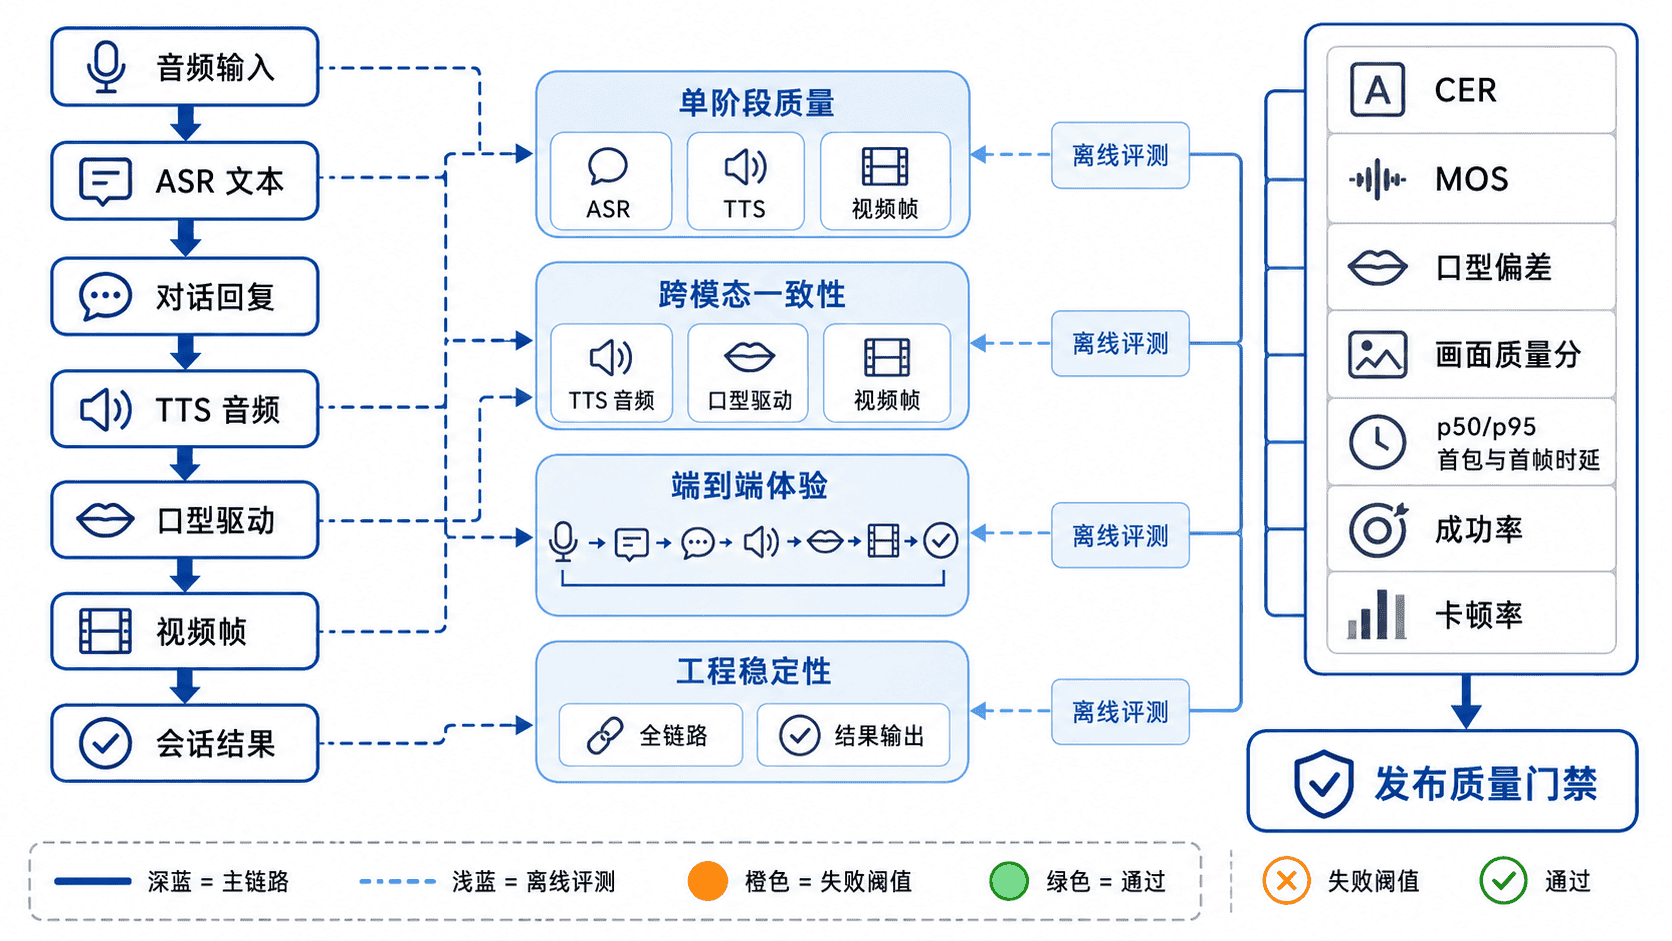
| 维度 | 核心指标 | 方向 | 采集口径 |
|---|---|---|---|
| 识别 | 字错率 CER 或词错率 WER |
越低越好 | 固定文本规范化规则和标注集 |
| 语音 | 主观自然度 MOS、可懂度 |
越高越好 | 盲测、随机顺序、足够样本 |
| 口型 | 音画时间偏差、关键音素命中率 | 偏差越低越好 | 使用同一时钟和时间戳基准 |
| 画面 | 清晰度、结构稳定性、闪烁率 | 质量越高越好 | 固定分辨率、码率和场景集 |
| 交互 | 首字、首音频、首帧和端到端 p95 |
越低越好 | 从用户动作到可感知反馈 |
| 稳定性 | 会话成功率、崩溃率、卡顿率 | 成功率越高越好 | 明确定义分母和失败分类 |
CER 是替换、删除、插入数之和除以参考字符数。汇总时先加总编辑数和参考字符数,再相除,这样长短句按参考字符数贡献。固定标点、大小写、数字和混合语言规范化。插入足够多时 CER 可能超过 100%。无参考字符的静音样本单列误触发,避免零分母。
对齐音视频的媒体时间轴后,可把某个匹配事件的有符号偏差定义为“画面事件 PTS 减音频事件 PTS”。正值是画面晚。用绝对偏差的 p95 做门禁,同时保留有符号偏差用于排查。音频、画面均有效才有配对偏差,缺配对要报告。主观语音分数应记录方法、语言、设备、听评人数与估计不确定性,注明是听评结果还是算法预测。不同流程得分的可比性需通过评测设计确认。NIST 语音识别评测方案 · ITU-T P.800.1
阈值、分桶与质量门禁
统一指标首先要统一样本。测试集应按语言、角色、设备、网络、文本长度、情绪和噪声等级分桶,既保留总体结果,也保留最差分桶。只看总体均值可能掩盖少数语言或低端设备上的严重退化。
阈值应来自基线版本、用户容忍度和业务风险,而不是随意选择整数。建议同时设置三类规则:硬门槛负责阻断明显不可用版本,退化门槛限制相对基线下降,观察线用于触发人工复核。发布时先检查每个维度,再生成汇总看板,不要用加权总分抵消单项失败。
本课把一次发起的交互记为一个尝试。成功端到端时延从客户端动作计至规定的可感知完成事件,使用同一客户端单调时钟。失败按成功率和原因另计,超时另有截止时间和观察耗时。成功时延的 p95 需一同报告覆盖数,不能从该分位数推断失败请求的完成时间。最近秩法取有序样本第 ceil(0.95 × n) 项,五条样本的 p95 就是最大值。
可运行的质量门禁示例
将下列代码保存为 quality_gate.py。每行包含设备分桶、参考字符数与编辑数、盲测自然度、口型有符号偏差、画面分、成功完成耗时和失败原因。失败会话仍可留下已生成的部分测量。演示门槛由代码固定,真实门禁应按业务风险冻结阈值、最低样本量及必须覆盖的分桶。
from math import ceil
from statistics import mean

samples = [
    ("desktop", 100, 2, 4.2, 52, 91, 980, None),
    ("mobile", 100, 4, 4.0, -68, 89, 1120, None),
    ("desktop", 100, 3, 4.1, 61, 90, 1040, None),
    ("mobile", 120, 6, 3.8, 94, 86, 1480, None),
    ("mobile", 80, 4, None, None, None, None, "timeout"),
]


def p95(values):
    if not values:
        return None
    return sorted(values)[ceil(0.95 * len(values)) - 1]


def gate(rows, minimum):
    count = len(rows)
    if count < minimum:
        return ["insufficient_samples"]

    reference = sum(row[1] for row in rows)
    edits = sum(row[2] for row in rows)
    mos = [row[3] for row in rows if row[3] is not None]
    lip = [abs(row[4]) for row in rows if row[4] is not None]
    visual = [row[5] for row in rows if row[5] is not None]
    completed = [row for row in rows if row[7] is None]
    latency = [row[6] for row in completed if row[6] is not None]
    metrics = {
        "CER": (edits / reference if reference else None, 0.05, True),
        "MOS": (mean(mos) if mos else None, 4.0, False),
        "lip_p95": (p95(lip), 80, True),
        "visual": (mean(visual) if visual else None, 88, False),
        "completed_p95": (p95(latency), 1200, True),
        "success": (len(completed) / count, 0.99, False),
    }
    print(f"n={count} lip={len(lip)}/{count} complete={len(latency)}/{count}")
    failures = []
    if len(latency) != len(completed) or any(len(values) < minimum for values in (mos, lip, visual, latency)):
        failures.append("coverage")
    for name, (value, limit, lower_is_better) in metrics.items():
        if value is None or (value > limit if lower_is_better else value < limit):
            failures.append(name)
    return failures


if __name__ == "__main__":
    blocked = False
    groups = {"all": samples}
    for device in ("desktop", "mobile"):
        groups[device] = [row for row in samples if row[0] == device]
    for name, rows in groups.items():
        failures = gate(rows, minimum=2)
        blocked = blocked or bool(failures)
        print(f"{name}: {', '.join(failures) or 'PASS'}")
    print("RELEASE:", "BLOCKED" if blocked else "PASSED")
raise SystemExit(1 if blocked else 0)python quality_gate.pyn=5 lip=4/5 complete=4/5
all: lip_p95, completed_p95, success
n=2 lip=2/2 complete=2/2
desktop: PASS
n=3 lip=2/3 complete=2/3
mobile: MOS, lip_p95, visual, completed_p95, success
RELEASE: BLOCKED本次演示以退出码 1 阻断流水线。总体 CER 为 19 / 500 = 0.038,成功完成的四条样本 p95 是 1480 ms,超时的第五条在成功率分母中。桌面分桶通过,而移动分桶的自然度均值和画面均值也未达标。排查时用样本 ID 连接输入、设备、时轴和失败阶段,先区分音画配对缺失、真实延迟和超时。
本课总结
- 多模态质量必须分维度评价,并保留跨模态、端到端和稳定性指标。
- 统一样本分桶、时间窗口、分位数算法和失败定义,指标才具有可比性。
- 发布门禁应逐项阻断关键退化,总分只能用于观察,不能掩盖单项失败。
下一课预告
下一课将设计测试集、盲测顺序和评分锚点,把各维度的分数和低分片段变成可复测的修复任务。