
AI 内容创作 / 系统课时
端到端模块集成
端到端模块集成
本课把已经独立验证的语音识别、对话、语音合成、口型表情、渲染和传输模块接成一条可追踪、可取消、可验收的链路。完成后,你将掌握统一事件契约、模块边界、代次隔离和最小集成程序的实现方法。
学习目标
- 使用统一事件信封连接不同输入输出格式的模块。
- 按正确顺序传递
trace_id、sequence和generation_id。 - 运行一个完整示例并验证各阶段输出与最终媒体事件。
先统一模块契约
端到端集成的难点不是调用函数,而是让每个模块对“输入是什么、输出何时有效、失败如何传播”达成一致。建议把供应商 SDK 包在适配器后面,业务链路只依赖稳定接口。
| 模块 | 标准输入 | 标准输出 | 关键失败 |
|---|---|---|---|
| ASR | 音频块与会话信息 | 最终文本 | 空文本、超时 |
| 对话 | 用户文本与知识上下文 | 回复文本 | 越界、流被取消 |
| TTS | 回复文本 | 带时间戳的音频块 | 首包超时 |
| 驱动 | 音频或音素时间戳 | 口型与表情帧 | 时间轴不一致 |
| 渲染 | 驱动帧与角色资源 | 视频帧 | GPU 超时、丢帧 |
| 传输 | 音频块、视频帧、状态事件 | 客户端可消费消息 | 断线、背压 |
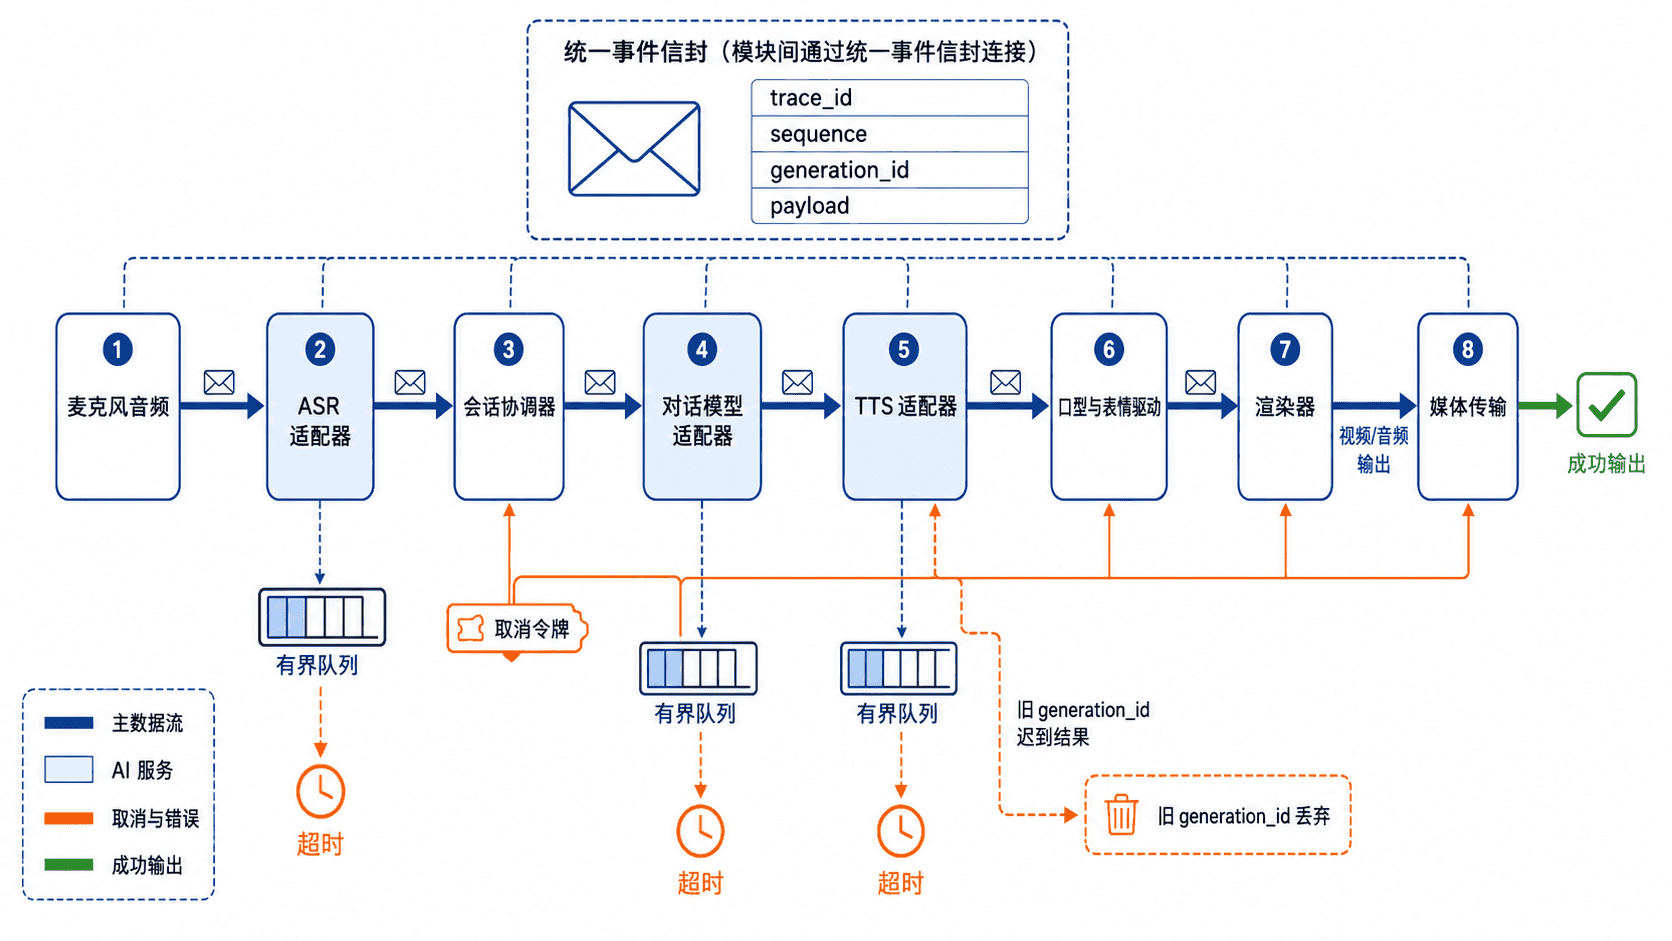
统一事件信封至少包含 trace_id、sequence、generation_id、事件类型和载荷。trace_id 串联一次交互,sequence 提供同一流内的排序依据,generation_id 用于识别用户打断后到达的旧结果。
设计协调器与执行顺序
协调器负责启动一次生成、推进阶段、记录耗时和处理失败。基本顺序是 ASR 产出文本,对话生成回复,TTS 产出音频,驱动模块生成口型表情,渲染器生成视频帧,传输层按序发送状态、音频和视频。
真正的实时系统会让 TTS、驱动、渲染和发送部分重叠执行,但首个集成版本应先保证顺序正确和错误可见。确认契约稳定后,再把阶段改成异步流和有界队列,避免一开始同时调试并发、背压与业务逻辑。
运行最小端到端程序
下面的 Python 程序通过同步模拟适配器展示数据契约。所谓音频是占位字符串,输入 UTF-8 字节也只是夹具。网络、知识库与取消处理需按后续生产设计实现。每个模块接收同一个事件信封并生成新的事件,协调器负责递增序号并完整传递 generation_id。将代码保存为 pipeline_demo.py。
from dataclasses import dataclass, replace
from typing import Any
from uuid import uuid4

@dataclass(frozen=True)
class Event:
    trace_id: str
    sequence: int
    generation_id: int
    event_type: str
    payload: Any

class AsrAdapter:
    def recognize(self, event: Event) -> Event:
        text = event.payload.decode("utf-8").strip()
        if not text:
            raise ValueError("识别结果为空")
        return replace(event, event_type="asr.final", payload=text)

class DialogAdapter:
    def reply(self, event: Event) -> Event:
        answer = f"已查询知识库:{event.payload}"
        return replace(event, event_type="dialog.reply", payload=answer)

class TtsAdapter:
    def synthesize(self, event: Event) -> Event:
        audio = f"AUDIO<{event.payload}>"
        return replace(event, event_type="tts.audio", payload=audio)

class DriverAdapter:
    def drive(self, event: Event) -> Event:
        if event.event_type != "tts.audio" or not event.payload.startswith("AUDIO<"):
            raise ValueError("驱动必须接收 TTS 音频")
        frames = {"lip_frames": 48, "expression": "friendly"}
        return replace(event, event_type="driver.frames", payload=frames)

class RendererAdapter:
    def render(self, event: Event) -> Event:
        video = f"VIDEO<{event.payload['lip_frames']} frames>"
        return replace(event, event_type="render.video", payload=video)

class TransportAdapter:
    def send(self, event: Event) -> Event:
        if not all(event.payload.get(track) for track in ("audio", "video")):
            raise ValueError("两条媒体均须有效")
        return replace(event, event_type="transport.sent", payload="audio+video")

class Coordinator:
    def __init__(self) -> None:
        self.asr = AsrAdapter()
        self.dialog = DialogAdapter()
        self.tts = TtsAdapter()
        self.driver = DriverAdapter()
        self.renderer = RendererAdapter()
        self.transport = TransportAdapter()

    def next_event(self, event: Event, event_type: str, payload: Any) -> Event:
        return Event(
            trace_id=event.trace_id,
            sequence=event.sequence + 1,
            generation_id=event.generation_id,
            event_type=event_type,
            payload=payload,
        )

    def run(self, audio: bytes, generation_id: int) -> None:
        if type(generation_id) is not int or generation_id < 1:
            raise ValueError("生成代次须为正整数")
        trace_id = str(uuid4())
        event = Event(trace_id, 0, generation_id, "audio.input", audio)

        event = self.asr.recognize(self.next_event(event, event.event_type, event.payload))
        self.print_event(event)

        event = self.next_event(event, event.event_type, event.payload)
        event = self.dialog.reply(event)
        self.print_event(event)

        event = self.next_event(event, event.event_type, event.payload)
        tts_event = self.tts.synthesize(event)
        self.print_event(tts_event)

        driver_input = self.next_event(tts_event, "tts.audio", tts_event.payload)
        driver_event = self.driver.drive(driver_input)
        self.print_event(driver_event)

        render_input = self.next_event(driver_event, driver_event.event_type, driver_event.payload)
        render_event = self.renderer.render(render_input)
        self.print_event(render_event)

        transport_input = self.next_event(render_event, "transport.input", {
            "audio": tts_event.payload,
            "video": render_event.payload,
        })
        sent_event = self.transport.send(transport_input)
        self.print_event(sent_event)

    @staticmethod
    def print_event(event: Event) -> None:
        print(
            f"seq={event.sequence} generation={event.generation_id} "
            f"type={event.event_type} payload={event.payload}"
        )

if __name__ == "__main__":
    Coordinator().run("如何重置密码?".encode("utf-8"), generation_id=7)
运行命令如下:
python pipeline_demo.py预期输出如下:
seq=1 generation=7 type=asr.final payload=如何重置密码?
seq=2 generation=7 type=dialog.reply payload=已查询知识库:如何重置密码?
seq=3 generation=7 type=tts.audio payload=AUDIO<已查询知识库:如何重置密码?>
seq=4 generation=7 type=driver.frames payload={'lip_frames': 48, 'expression': 'friendly'}
seq=5 generation=7 type=render.video payload=VIDEO<48 frames>
seq=6 generation=7 type=transport.sent payload=audio+video
加入取消、超时与可观测性
生产链路必须在每个阶段记录开始时间、结束时间、状态和错误码,并把这些字段绑定到同一 trace_id。当用户插话时,协调器递增 generation_id,停止播放器,取消仍在执行的对话与 TTS 任务,并丢弃旧代次随后到达的音频或视频。
超时应按阶段分别设置。ASR、对话首字、TTS 首包、单帧渲染和发送队列的容忍时间不同,使用一个总超时会掩盖瓶颈。队列必须有容量上限;当下游变慢时,应触发丢帧、降级或取消,而不是无限占用内存。
集成验证与故障定位
先验收本地事件顺序、标识和两条媒体载荷。transport.sent 仅表示模拟调用完成;真实网络中的已入发送队列、对端已接收和实际已播放应分别记录。随后加入空识别、知识库拒答、TTS 超时、渲染失败、客户端断线和用户插话等案例,验证每个错误都能被定位到具体阶段。
常见错误包括适配器直接泄露供应商数据结构、音频与驱动使用不同时间基准、重试后重复发送旧媒体,以及只记录最终失败而不记录阶段耗时。修复时应先稳定事件契约,再检查代次过滤、时间戳和队列方案。
本课总结
- 端到端集成应依赖统一事件信封和稳定适配器,而不是直接耦合各家 SDK。
trace_id用于追踪,sequence用于排序,generation_id用于隔离打断后的旧结果。- 先验证顺序与失败传播,再引入流式并发、背压和性能优化。
下一课预告
下一阶段将围绕完整工程链路开展故障排查与验收,重点分析时延异常、取消失效、音画不同步、渲染失败和断线恢复等问题。