
AI 内容创作 / 系统课时
二维与三维数字人技术路线
二维与三维数字人技术路线
数字人并不是单一技术,而是从视频驱动、二维骨骼、三维实时角色到神经渲染的一组方案。本课将用成本、效果、实时性、可控性和开发难度建立统一比较框架,帮助你先确定业务目标,再选择可落地的技术路线。
学习目标
- 识别二维视频数字人、二维骨骼角色、三维角色和神经渲染数字人的核心组成。
- 从效果、实时性、成本、可控性和交付风险比较四类路线。
- 根据直播、客服、培训和品牌展示等场景完成初步选型。
技术路线全景
四类路线从角色表示和画面生成机制作实用分类。二维视频可以由神经模型驱动,三维角色也可叠加学习型驱动;这些类别允许混合。二维视频数字人直接合成或驱动人物视频;二维骨骼角色把角色拆成可变形图层;三维角色使用网格、骨骼、材质和实时渲染;神经渲染则由模型学习人物外观与运动映射。
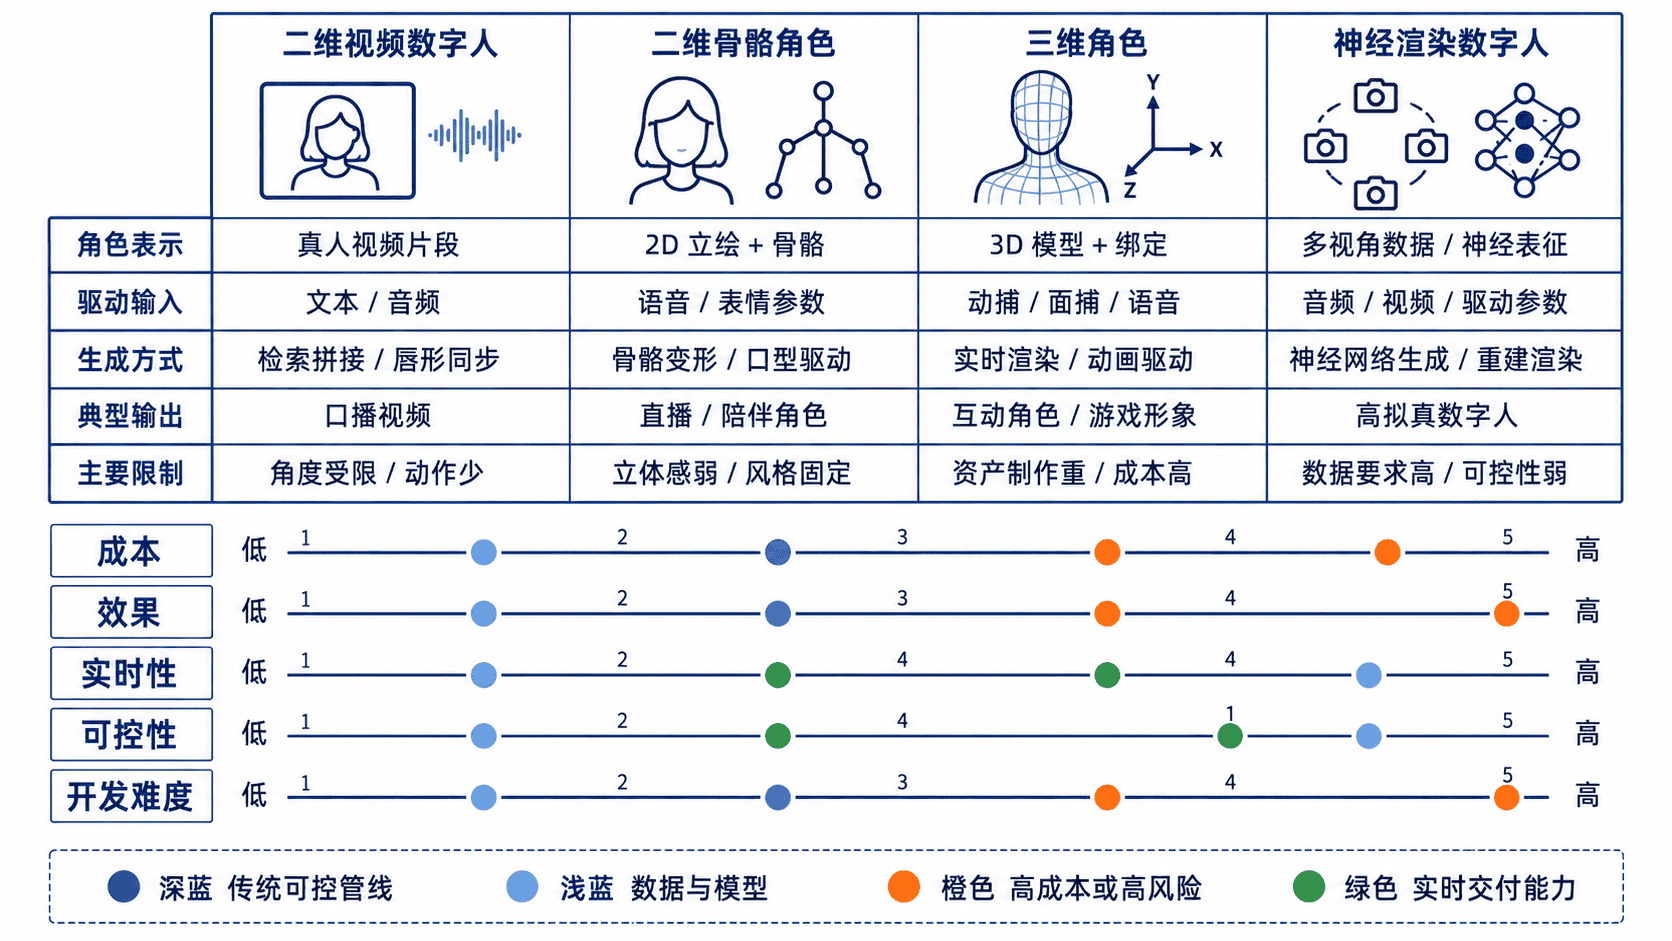
二维视频数字人通常以真人素材或预训练形象为基础,输入文本或音频后生成口型、表情与视频。它的优势是上线快、画面接近真人,限制是动作范围、镜头角度和实时延迟受模型能力约束。二维骨骼角色则更像可编程动画,动作与表情容易控制,但写实感通常低于真人视频方案。
三维角色通过骨骼、表情绑定、动画系统和渲染引擎构建完整角色。它适合需要自由机位、全身动作、虚拟场景和实时交互的项目,但前期资产制作与工程集成成本更高。神经渲染能够生成高度逼真的外观和细节,却更依赖训练数据、推理算力与稳定性治理。
四类路线的关键差异
| 技术路线 | 角色表示 | 实时性 | 可控性 | 初始成本 | 主要风险 |
|---|---|---|---|---|---|
| 二维视频数字人 | 真人视频或学习到的外观模型 | 中到高 | 中 | 低到中 | 口型漂移、姿态受限、素材授权 |
| 二维骨骼角色 | 分层图片、网格与二维骨骼 | 高 | 高 | 低到中 | 视角有限、写实感不足 |
| 三维角色 | 网格、骨骼、材质与动画状态 | 高 | 很高 | 中到高 | 资产制作重、渲染性能压力 |
| 神经渲染数字人 | 神经表示与生成模型 | 中 | 中到高 | 高 | 训练成本、时序不稳定、可解释性弱 |
表中高、中、低是用于立项讨论的定性假设,需要在目标模型、硬件、并发和输出规格下实测。现成模型可大幅降低神经路线的前期成本,复杂的二维素材或授权也可能比复用三维资产更昂贵。客服窗口只显示胸像时,稳定口型与低延迟往往比自由机位更重要;虚拟直播需要全身动作与场景交互时,三维路线的可控性更有价值;一次性品牌短片重视逼真度,可以接受更长的离线生成时间。
实时性也不等于只有帧率。用户感知延迟还包括语音识别、语言模型生成、语音合成、动作驱动、渲染和网络传输。某条路线即使能够输出 30 FPS,只要整条链路停顿明显,交互体验仍然会失败。
从需求到选型
先把需求拆成五个可验证问题,再决定技术路线:
- 角色需要真人写实、卡通表达,还是统一品牌形象?
- 是否要求实时对话,允许的端到端延迟是多少?
- 是否需要全身动作、自由机位、换装或复杂场景交互?
- 团队能否承担角色资产、训练数据、算力和持续维护成本?
- 输出是否涉及肖像权、声音授权、数据留存和内容审核?
对于低频培训视频,可优先考虑二维视频数字人,用模板化流程换取快速交付。对于需要表情丰富、成本可控的卡通主播,二维骨骼角色更合适。对于游戏内角色、虚拟展厅或长期直播,三维角色通常更稳定。神经渲染适合追求高拟真且拥有数据、算力和模型治理能力的团队,不应仅因画面新颖就直接采用。
选型时应建立最小验证样片,而不是只看厂商演示。使用同一段文本、同一网络条件和同一输出规格,分别记录离线生成的产出时长和在线模式的首帧、首段可听回应与端到端 p95,统计口型错误、动作可控项、人工修正时间及单分钟成本。再用含停顿、快速语速、侧脸和用户打断的样片检查异常表现。若三维管线采用 glTF 2.0,还应验证蒙皮、关节映射、表情形变权重与实际渲染器的兼容性。只有测试数据满足验收门槛,路线才算可进入正式开发。
本课总结
- 四类路线的根本差异在于角色表示、驱动方式和画面生成机制。
- 选型必须同时比较效果、实时性、可控性、成本与长期维护风险。
- 最可靠的决策方式是用统一素材制作最小样片,并以可测指标验收。
下一课预告
下一课将进入“开发硬件与性能预算”,把选定技术路线拆解为 CPU、GPU、显存、内存、采集设备和网络资源需求,形成可执行的端侧与云端预算。