
AI 内容创作 / 系统课时
文本规范化与读法控制
文本规范化与读法控制
同一段文字中可能同时出现日期、金额、英文缩写、单位和专业词。若直接交给语音模型,读法容易随上下文或模型版本变化。本课将构建有优先级的规范化规则链,并用显式停顿和词典覆盖获得可测试、可回归的发音结果。
学习目标
- 为日期、金额、英文缩写和符号设计稳定的转换规则
- 使用词典、规则优先级和停顿标记控制读法与节奏
- 编写可运行的规范化程序并核对转换结果
规范化规则链
文本规范化的目标不是改写语义,而是把书写形式转换为适合朗读的形式。处理顺序通常是字符清理、受保护词典匹配、结构化实体识别、数字与单位展开、英文处理、标点停顿映射,最后再检查未识别片段和规则冲突。
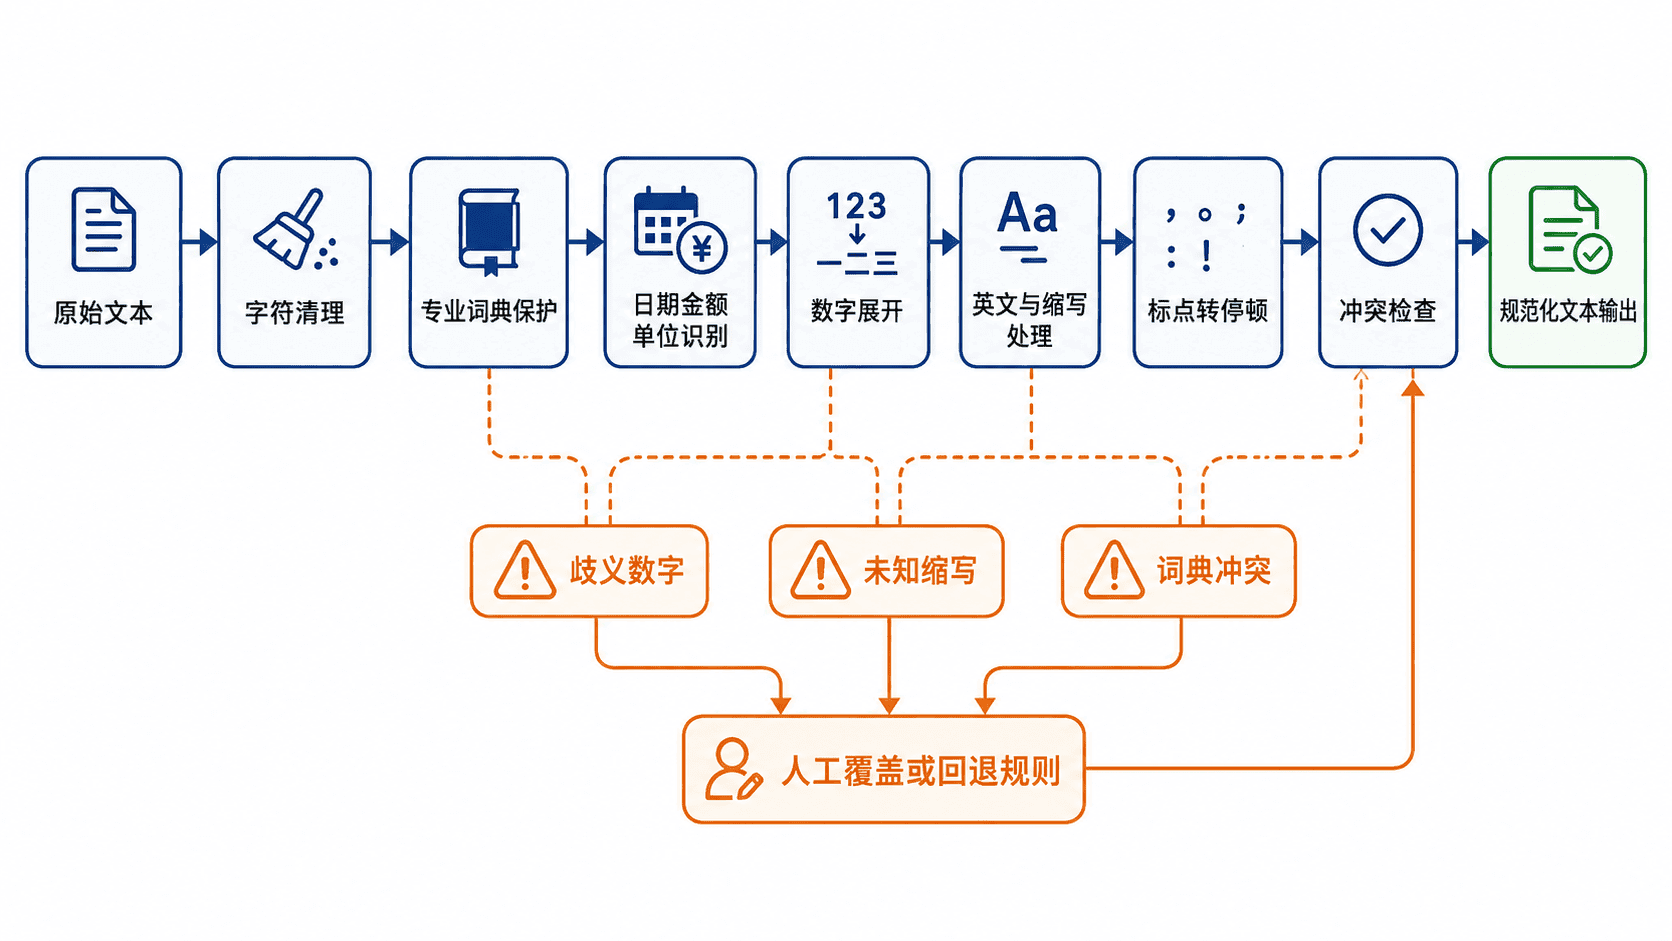
规则应从具体到一般执行。例如,先识别完整日期 2026-08-04,再处理普通整数;否则日期可能被拆成三个互不相关的数字。专业词典也应早于通用英文规则,否则产品名或人名可能被逐字母朗读。
常见实体的读法设计
日期中的年份通常逐位朗读,月份和日期按整数朗读;金额需要处理千分位、小数和币种;英文缩写可按字母、单词或词典指定读法处理。电话号码、版本号、序列号等数字串不能共用一种规则,必须依据业务类型区分。
| 输入类型 | 示例 | 推荐读法 |
|---|---|---|
| 日期 | 2026-08-04 |
二零二六年八月四日 |
| 金额 | ¥1,234.50 |
一千二百三十四元五角 |
| 缩写 | API |
A P I |
| 版本号 | 2.1.0 |
二点一点零 |
| 百分比 | 12.5% |
百分之十二点五 |
专业术语应维护“书写形式、标准读法、适用语言、优先级和版本”五项信息。词典变更后要用固定语料回归,避免修复一个词却破坏另一个词。对于无法可靠判断的缩写,应保留原文并记录告警,不应静默猜测。
停顿、重音与边界控制
标点可以映射为内部停顿标记,例如逗号对应短停顿,句号对应长停顿。内部标记应在接入具体服务前再转换成该服务支持的 SSML 或参数格式,避免业务正文直接绑定某一家接口。
停顿并非越多越自然。连续短句如果都插入长停顿,会造成播报割裂;数字、单位和量词之间则不应随意切分。验证时既要检查规范化文本,也要试听边界位置,并记录最终发送给合成服务的请求内容。
可运行的规范化示例
以下例子用 Python 3.11 标准库。只转换有效的四位年份日期、范围在 0 至 9999.99 的非负人民币金额和词典中的缩写。无效或超范围实体原样保留并输出警告。停顿使用结构化元素传递,不让业务文本里的方括号自动变成控制指令。
from datetime import date
import re

DIGITS = "零一二三四五六七八九"
UNITS = ("", "十", "百", "千")
LEXICON = {"API": "A P I", "TTS": "T T S"}
TOKEN = re.compile(
    r"(?P<date>(?<![0-9A-Za-z_-])[0-9]{4}-[0-9]{1,2}-[0-9]{1,2}(?![0-9A-Za-z_-]))"
    r"|(?P<amount>¥[ \t]*[+-]?[0-9][0-9.,A-Za-z_]*)"
    r"|(?P<abbr>(?<![A-Za-z0-9_])[A-Z]{2,}(?![A-Za-z0-9_]))"
    r"|(?P<break_>[,。])"
)
MONEY = re.compile(r"¥[ \t]*((?:0|[1-9][0-9]{0,3}|[1-9],[0-9]{3}))(?:\.([0-9]{1,2}))?")


def number(value):
    if not 0 <= value <= 9999:
        raise ValueError("out of range")
    if not value:
        return "零"
    text = str(value)
    result, pending_zero = [], False
    for i, ch in enumerate(text):
        digit = int(ch)
        power = len(text) - i - 1
        if not digit:
            pending_zero = True
            continue
        if pending_zero:
            result.append("零")
            pending_zero = False
        if not (digit == 1 and power == 1 and not result):
            result.append(DIGITS[digit])
        result.append(UNITS[power])
    return "".join(result)


def read_token(kind, token):
    if kind == "date":
        year, month, day = token.split("-")
        date(int(year), int(month), int(day))
        return "".join(DIGITS[int(ch)] for ch in year) + f"年{number(int(month))}月{number(int(day))}日"
    if kind == "amount":
        match = MONEY.fullmatch(token)
        if not match:
            raise ValueError("unsupported amount")
        integer, fraction = match.groups()
        jiao, fen = map(int, ((fraction or "") + "00")[:2])
        yuan = int(integer.replace(",", ""))
        suffix = (DIGITS[jiao] + "角") if jiao else ("零" if yuan and fen else "")
        suffix += (DIGITS[fen] + "分") if fen else ""
        return number(yuan) + "元" + (suffix or "整")
    if token not in LEXICON:
        raise ValueError("unknown abbreviation")
    return LEXICON[token]


def normalize(text):
    output, warnings = [], []
    start = 0
    for match in TOKEN.finditer(text):
        if match.start() > start:
            output.append({"text": text[start:match.start()]})
        kind, token = match.lastgroup, match[0]
        if kind == "break_":
            output.append({"pause_ms": 200 if token == "," else 400})
        else:
            try:
                output.append({"text": read_token(kind, token)})
            except ValueError:
                output.append({"text": token})
                warnings.append(kind)
        start = match.end()
    if start < len(text):
        output.append({"text": text[start:]})
    return output, warnings


if __name__ == "__main__":
    parts, warnings = normalize("请在2026-08-04支付¥1,234.50,调用API查询订单。")
    for part in parts:
        if "pause_ms" in part:
            print("停顿", part["pause_ms"], "ms")
        else:
            print(part["text"])
    print("警告", warnings)
将示例保存为 text_normalizer.py,运行 python text_normalizer.py。
请在
二零二六年八月四日
支付
一千二百三十四元五角
停顿 200 ms
调用
A P I
查询订单
停顿 400 ms
警告 []
例子按限定业务输入处理。不同币种、负数、较大金额、精度超过分或格式不完整时应另定义规则。接到支持 SSML 的服务时,适配器负责转义文本并生成允许的节点。遇到警告可使用保守读法,或对高风险数字要求确认,避免悄悄改写金额和日期。