
AI 内容创作 / 系统课时
日志、指标与链路追踪
日志、指标与链路追踪
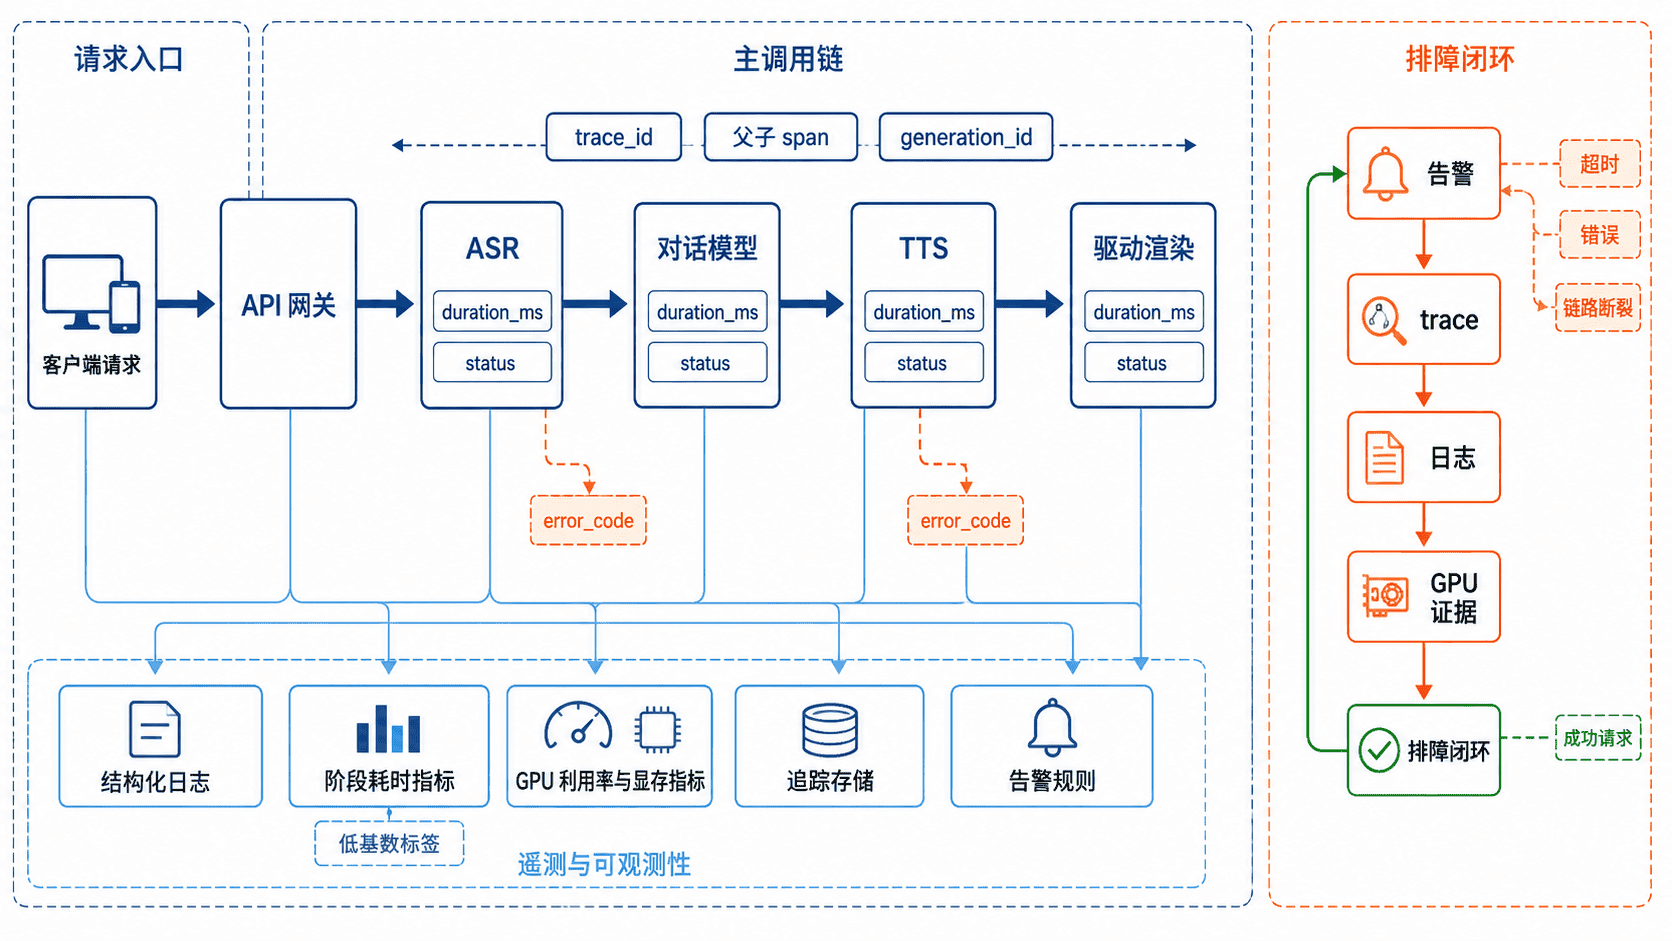
本课建立实时数字人的可观测性最小闭环:用结构化日志记录一次请求发生了什么,用指标观察阶段耗时与 GPU 资源趋势,再用统一 trace_id 串联 ASR、对话、TTS 和渲染阶段。完成后,故障定位将从猜测转为按证据还原调用链。
学习目标
- 设计日志、指标与追踪共享的标识和字段。
- 采集阶段耗时、请求结果与 NVIDIA GPU 快照。
- 识别链路断裂、指标高基数和计时方式错误等问题。
可观测性数据模型
结构化日志记录事件,链路追踪还原阶段和父子关系,指标衡量总体分布。请求相关的日志可携带 trace_id 与 span_id。聚合指标的维度只选数量可控的服务、阶段、状态和发布版本。有 exemplar 支持时,可把少量观测值链接到对应 trace;无需为每个 trace 创建独立时间序列。OpenTelemetry 日志字段 · OpenTelemetry exemplar
同一进程内测量阶段和请求耗时使用单调时钟;UTC 墙上时间用于检索日志。跨进程传递追踪上下文,分段测量本地耗时。并行阶段的耗时可能重叠,分析总耗时应看关键路径和等待区间。日志使用受控的错误码,避免打印可能包含输入或凭据的异常文本。
最小可运行采集器
把以下程序保存为 observability_demo.py。默认运行合成请求,结构化输出的每个父子阶段和根请求都由上下文管理器记录结束。单独用 --gpu 运行一次设备采样,部署时由独立采集器周期调用,使用设备 UUID 区分显卡。显存单位为 MiB。设备报告 N/A 时保留其他字段,缺失与 0 分开。NVIDIA nvidia-smi
import argparse
import csv
import json
import secrets
import subprocess
import time
from contextlib import contextmanager
from datetime import datetime, timezone


def emit(event, **fields):
    ts = datetime.now(timezone.utc).isoformat(timespec="milliseconds")
    print(json.dumps({"ts": ts, "event": event, **fields}, ensure_ascii=False))


@contextmanager
def span(trace_id, stage, parent=None):
    span_id = secrets.token_hex(8)
    fields = {"trace_id": trace_id, "span_id": span_id, "parent_span_id": parent, "stage": stage}
    started = time.perf_counter_ns()
    status = "ok"
    emit("span.start", **fields)
    try:
        yield span_id
    except BaseException:
        status = "error"
        raise
    finally:
        duration = (time.perf_counter_ns() - started) / 1_000_000
        emit("span.end", **fields, status=status, duration_ms=round(duration, 3))


def request(fail_stage=None):
    trace_id = secrets.token_hex(16)
    with span(trace_id, "request") as root:
        for stage in ("asr", "dialogue", "tts", "render"):
            with span(trace_id, stage, root):
                time.sleep(0.005)
                if stage == fail_stage:
                    raise RuntimeError("synthetic stage failure")


def read_gpu_snapshot():
    command = [
        "nvidia-smi", "--query-gpu=uuid,utilization.gpu,memory.used,memory.total",
        "--format=csv,noheader,nounits",
    ]
    try:
        result = subprocess.run(command, capture_output=True, text=True, check=True, timeout=2)
    except (OSError, subprocess.SubprocessError):
        return {"status": "unavailable", "devices": []}

    devices = []
    for row in csv.reader(result.stdout.splitlines(), skipinitialspace=True):
        if len(row) != 4:
            continue
        gpu, *raw = (cell.strip() for cell in row)
        if not gpu.startswith("GPU-"):
            continue
        values = [int(cell) if cell.isascii() and cell.isdecimal() else None for cell in raw]
        devices.append(dict(zip(("gpu", "utilization_pct", "used_mib", "total_mib"), [gpu, *values])))
    return {"status": "ok" if devices else "no_data", "devices": devices}


if __name__ == "__main__":
    cli = argparse.ArgumentParser()
    mode = cli.add_mutually_exclusive_group()
    mode.add_argument("--gpu", action="store_true")
    mode.add_argument("--fail-stage", choices=("asr", "dialogue", "tts", "render"))
    args = cli.parse_args()
    if args.gpu:
        emit("gpu.snapshot", **read_gpu_snapshot())
    else:
        try:
            request(args.fail_stage)
        except RuntimeError:
raise SystemExit(1)python observability_demo.py
python observability_demo.py --fail-stage tts
python observability_demo.py --gpu默认命令输出 10 行 JSON,根 span 包含 ASR、对话、TTS、渲染四个子 span,所有结束状态均为 ok。注入 TTS 故障时程序退出码为 1,TTS 和根 span 均以 error 结束,未进入渲染。独立 GPU 采样仅输出一行;驱动或命令不可用时状态为 unavailable。示例只输出日志,直方图与计数器需接入指标系统。
验证与告警边界
先用同一个 trace_id 检查已执行阶段是否完整,并按 span_id 配对开始和结束。跨 HTTP 服务使用 W3C traceparent:收到有效上下文后保留 trace ID,在本地创建 span,向下游传播时用当前调用的 span ID 作为父 ID。跨队列由发布者注入、消费者提取上下文;多个消息汇合时可用 span links 保留关联。示例没有实现 HTTP/队列传播,真实服务可用追踪 SDK 注入和提取。W3C Trace Context
指标验证应关注分布而不是单次值。阶段延迟通常用直方图计算 p50、p95 和 p99,请求结果用计数器统计成功、超时与取消,GPU 显存和利用率使用仪表值。告警需要同时设置持续窗口和最小请求量,避免一次冷启动触发误报。若时序库中出现大量只包含一个样本的序列,应立即检查是否把 trace_id、session_id 或原始错误文本误设为标签。
排障顺序应保持固定:先看失败率或 p95 告警,再打开对应 trace,随后查看最慢 span 的结构化日志,最后对照同一时间窗口的 GPU 与队列指标。这样可以区分模型推理变慢、显存不足、排队拥塞和下游超时,避免只凭某一条错误日志下结论。
本课总结
- 日志和追踪用 trace/span 标识关联,聚合指标可通过 exemplar 连接个别观测。
- 用单调时钟测量本地阶段,独立采集 GPU 指标并区分缺失值。
- 按告警窗口选择 trace,将关键路径与同窗资源数据对照。
下一课预告
下一课将用结构化证据区分排队、媒体时间基准、显存峰值与模型制品故障。