
AI 内容创作 / 系统课时
断句与标点恢复
断句与标点恢复
部分识别器返回未加标点的字符流,另一些模型已输出标点或文本规范化结果。先检查上游输出,再选择需要的处理。本课把原始文本依次做口头语清理、数字规范化、断句和标点恢复,得到可直接交给对话模型、字幕模块或日志系统的稳定文本,并保留可追溯的处理边界。
学习目标
- 理解断句、标点恢复、数字规范化和口头语清理的职责边界。
- 能按稳定顺序组织语音识别后处理链路。
- 能实现并验证一个可运行的规则化文本后处理示例。
处理链路与职责边界
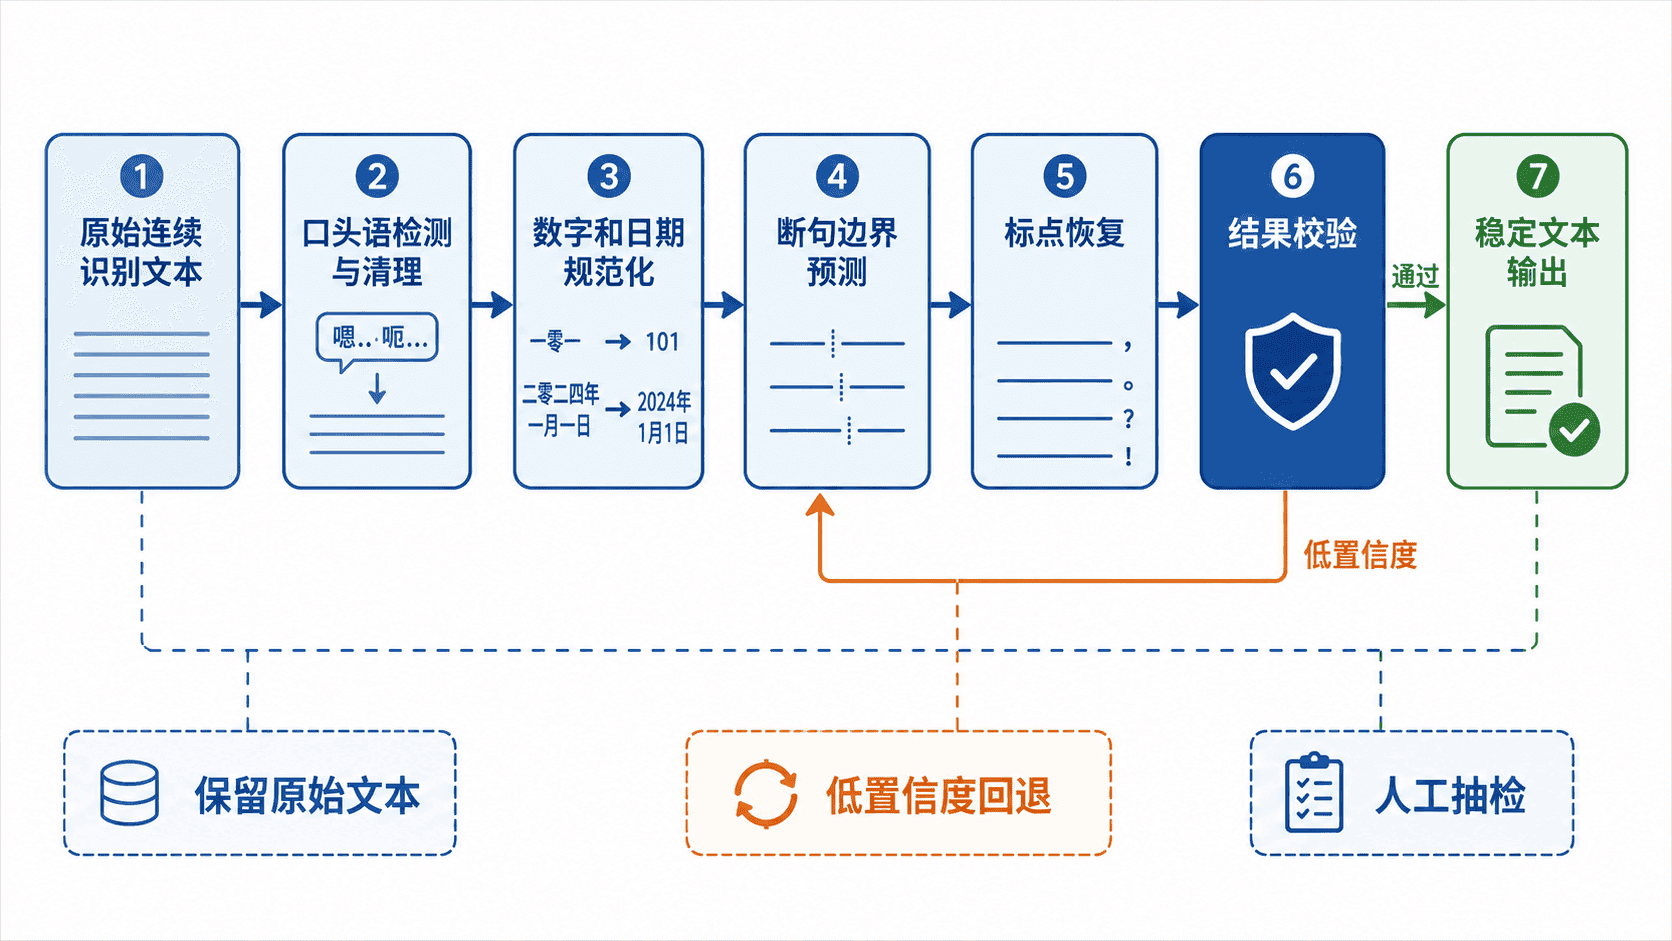
语音识别后处理不只是“补几个逗号”。原始识别结果可能同时包含连续字符、口头语、口语数字和不稳定分段。工程上应保留原始文本,再生成清洗后的派生文本,避免后续发现误删信息时无法回溯。
推荐链路为:原始识别文本进入口头语清理和数字规范化,再执行断句与标点恢复,最后做长度、空文本和敏感字段检查。若使用训练好的标点模型,输入形式必须与模型训练时的文本规范保持一致。
断句与标点恢复策略
断句通常依据停顿时长、词语边界、语义完整性和模型置信度共同判断。离线场景可以等待整句后统一处理;流式场景则要区分“临时结果”和“稳定结果”,只有稳定片段才应写入对话上下文。
| 处理项 | 主要输入 | 典型输出 | 关键风险 |
|---|---|---|---|
| 口头语清理 | 识别文本、词级置信度 | 删除或保留后的文本 | 误删有语义的语气词 |
| 数字规范化 | 中文数字、日期、单位上下文 | 三点 转为 3 点 或 15:00 |
缺少上下文导致误转换 |
| 断句 | 停顿、词边界、语义特征 | 句子边界 | 流式结果反复改写 |
| 标点恢复 | 已分词或字符序列 | 逗号、句号、问号 | 训练域与业务域不一致 |
生产系统应记录实际执行的规则和版本。只有模型或标注流程提供有效分数时才记录置信信息。低置信度片段可以保留原文、不强制加标点,或交给下游模型结合上下文判断,而不是静默改写成看似流畅但含义错误的句子。
完整可运行示例
示例只用 Python 3.11 标准库。输入是词级跨度和可信标注。已标明无语义的填充词可以从展示文本中移除。只有明确属于日程时间的词才做对应替换。这里的标注由测试提供,代码不会从字符或停顿自动推断词义。
from dataclasses import dataclass
from math import isfinite


@dataclass(frozen=True)
class Word:
    text: str
    start: float
    end: float
    kind: str = ""


def sentence(text):
    if text.endswith(("。", "!", "?", ".", "!", "?")):
        return text
    return text + ("?" if text.endswith("吗") else "。")


def process(words, pause=0.6):
    if not isfinite(pause) or pause <= 0:
        raise ValueError("positive pause required")
    kept = []
    raw = "".join(word.text for word in words)
    previous_start = 0.0
    for word in words:
        if not all(map(isfinite, (word.start, word.end))) or not previous_start <= word.start <= word.end:
            raise ValueError("invalid word timing")
        previous_start = word.start
        if word.kind == "filler" and word.text in {"嗯", "呃"} and len(words) > 1:
            continue
        text = " 15:00 " if word.kind == "schedule_time" and word.text == "下午三点" else word.text
        kept.append((text, word))

    result, part, previous_end = [], "", None
    for text, word in kept:
        if previous_end is not None and word.start - previous_end >= pause and part.strip():
            result.append(sentence(part.strip()))
            part = ""
        part += text
        previous_end = max(previous_end, word.end) if previous_end is not None else word.end
    if part.strip():
        result.append(sentence(part.strip()))
    return {"raw": raw, "sentences": result, "version": "demo-1"}


if __name__ == "__main__":
    words = [
        Word("嗯", 0.0, 0.1, "filler"),
        Word("今天", 0.2, 0.4),
        Word("下午三点", 0.4, 0.9, "schedule_time"),
        Word("我们开会", 0.9, 1.3),
        Word("先看语音识别质量,可以吗", 2.1, 3.2),
    ]
    for part in process(words)["sentences"]:
        print(part)
将示例保存为 asr_postprocess.py,运行 python asr_postprocess.py。
今天 15:00 我们开会。
先看语音识别质量,可以吗?
单独出现的“嗯”可以表示确认。没有可信填充词标注时原样保留。停顿只作为断句线索,不能覆盖语义和已有标点。真实词级时间戳存在估计误差,应根据语言和业务样本校准阈值。
工程注意事项与常见错误
不要直接覆盖识别器返回的原始文本。正确做法是同时保存 raw_text、normalized_text 和处理版本,出现误断句时才能定位问题来自识别、规范化还是标点模型。
不要在没有上下文时强行转换数字。“三点”可能表示时间、分数或三个要点。规则化转换必须限定业务场景,模型化转换则应返回置信度,并对低置信度结果保留原表达。
流式识别中不要把临时标点立即写入最终字幕。应等待稳定片段或设置最小稳定窗口,否则用户会看到句尾不断从逗号变成句号,甚至整句回退重写。
本课练习
- 在已有业务标签的日程场景支持“明天下午两点半”,要求保留“明天”或在明确时区与基准日期后解析日期。并为无法确定上午或下午的表达保留原文。验收时至少覆盖一个成功转换和一个拒绝转换的输入。
- 为处理函数增加结果结构,返回原始文本、清洗文本、最终文本和处理步骤列表。验收时应能看出每一步是否修改了内容,且不丢失原始输入。
本课总结
- 断句与标点恢复应放在可追溯的文本后处理链路中,而不是直接覆盖原始识别结果。
- 数字规范化和口头语清理都需要上下文与置信度,过度规则化会改变原意。
- 流式场景必须区分临时结果与稳定结果,避免字幕和对话上下文频繁回退。
下一课预告
下一课将学习“语音识别质量评估”,使用字错误率、实时率和首字延迟验证后处理前后的识别质量,并定位口音、噪声、专业词和远场拾音造成的误差。