
AI 内容创作 / 系统课时
流式语音识别实现
流式语音识别实现
本课将离线文件识别改造成可持续接收音频块的流式链路。系统按固定时长读取 PCM 数据,维护会话状态,持续发布可被覆盖的中间文本,并在端点检测后确认不可再修改的最终文本。完成后,你将得到可直接接入实时数字人对话的增量识别接口。
学习目标
- 设计音频分块、缓冲、增量解码和会话结束的协作机制。
- 正确区分可修订的
partial结果与只追加的final结果。 - 使用本地流式引擎验证首字延迟、最终延迟和结果去重逻辑。
流式链路与状态规则
流式 ASR 的目标不是让单次推理更快,而是让系统在用户尚未说完时就产生可用文本。音频采集线程持续写入短块,识别线程按顺序消费,解码器反复更新当前句假设。当检测到停顿、句末或主动结束时,当前假设被提交为最终结果,并开始新的句段。
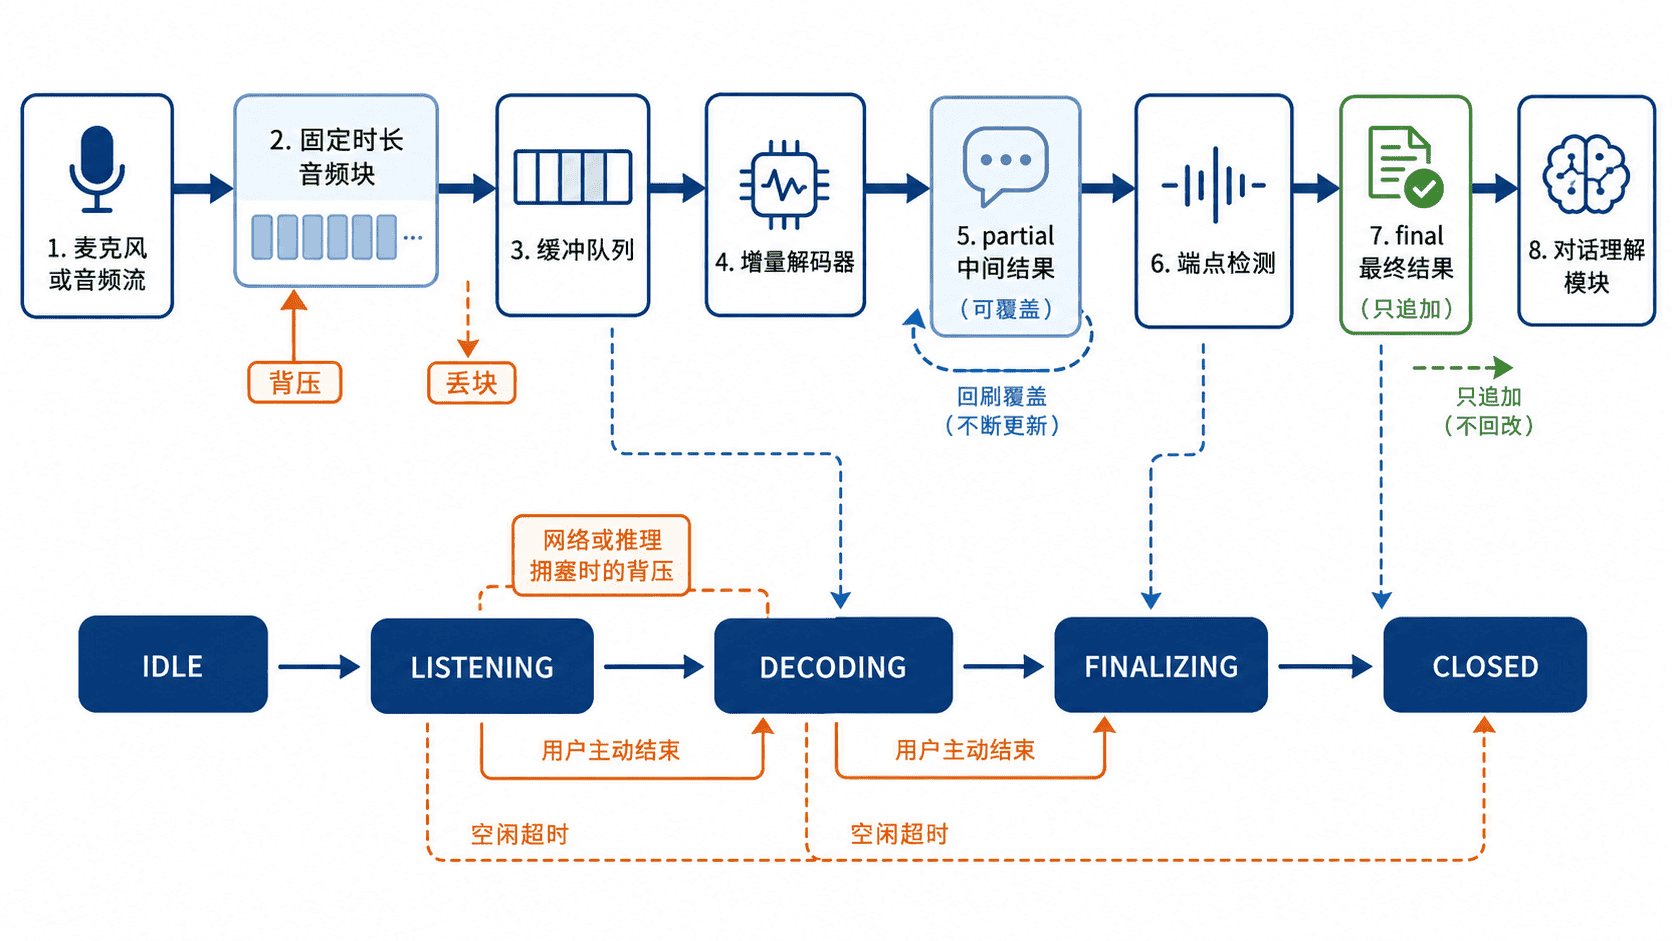
建议把一次识别会话建模为以下规则:partial 只表示当前未结束句段的最新假设,前端在同一会话和句段内按 revision 覆盖显示;final 表示已经确认的句段,前端只能追加;会话关闭前必须调用最终刷新,否则缓冲区中最后一小段语音可能丢失。
| 机制 | 推荐做法 | 错误后果 |
|---|---|---|
| 分块大小 | 100~300 ms 起步并实测 | 太小增加调度开销,太大增加首字延迟 |
| 缓冲队列 | 有界队列并记录积压时长 | 无界增长导致延迟越来越高 |
| 中间结果 | 相同文本不重复发布 | UI 抖动、下游重复处理 |
| 最终结果 | 只追加并带递增序号 | 已确认文本被错误覆盖 |
| 会话结束 | 刷新解码器并发送关闭事件 | 尾部语音无法提交 |
完整可运行示例
用 Python 3.11 虚拟环境安装 python -m pip install vosk==0.3.45,从官方模型清单提前取得符合语言和许可要求的模型。输入为单声道 16 位 PCM WAV。本例固定 16 kHz,选用支持该输入的模型。只用本地合成语音或获准录音,保存识别结果时遵守与录音一致的访问范围。
把代码保存为 streaming_asr.py。eventId 在一个会话内递增,segmentId 标记当前句段,revision 在每句内递增。空的 partial 可清空临时文字。最终事件结束该句段,其中只有非空文本才追加到字幕。closed 表示会话已刷新。
import argparse
import json
import time
import uuid
import wave
from pathlib import Path

from vosk import KaldiRecognizer, Model

RATE = 16000


class StreamingSession:
    def __init__(self, recognizer, session_id):
        self.recognizer = recognizer
        self.session_id = session_id
        self.event_id = 0
        self.segment_id = 1
        self.revision = 0
        self.partial = ""
        self.closed = False

    def event(self, kind, text="", words=None):
        self.event_id += 1
        self.revision += 1
        return {
            "sessionId": self.session_id, "eventId": self.event_id,
            "segmentId": self.segment_id, "revision": self.revision,
            "type": kind, "text": text, "words": words or [],
        }

    def final(self, payload):
        text = payload.get("text", "").strip()
        event = self.event("final", text, payload.get("result"))
        self.segment_id += 1
        self.revision = 0
        self.partial = ""
        return event

    def accept(self, chunk):
        if self.closed:
            raise RuntimeError("session is closed")
        if not chunk or len(chunk) % 2:
            raise ValueError("expected complete PCM samples")
        if self.recognizer.AcceptWaveform(chunk):
            return [self.final(json.loads(self.recognizer.Result()))]
        text = json.loads(self.recognizer.PartialResult()).get("partial", "").strip()
        if text == self.partial:
            return []
        self.partial = text
        return [self.event("partial", text)]

    def finish(self):
        if self.closed:
            return []
        self.closed = True
        payload = json.loads(self.recognizer.FinalResult())
        events = [self.final(payload)] if payload.get("text", "").strip() or self.partial else []
        return [*events, self.event("closed")]


def pcm_chunks(audio, frames_per_chunk):
    if type(frames_per_chunk) is not int or frames_per_chunk <= 0:
        raise ValueError("positive chunk length required")
    if (audio.getnchannels(), audio.getsampwidth(), audio.getframerate(), audio.getcomptype()) != (1, 2, RATE, "NONE"):
        raise ValueError("expected mono 16-bit PCM at 16 kHz")
    remaining = audio.getnframes()
    if remaining <= 0:
        raise ValueError("empty PCM input")
    while remaining:
        count = min(remaining, frames_per_chunk)
        chunk = audio.readframes(count)
        if len(chunk) != 2 * count:
            raise ValueError("truncated PCM input")
        remaining -= count
        yield chunk


def emit(events):
    for event in events:
        print(json.dumps(event, ensure_ascii=False, allow_nan=False), flush=True)


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--model", required=True, type=Path)
    parser.add_argument("--audio", required=True, type=Path)
    parser.add_argument("--chunk-ms", type=int, default=200)
    parser.add_argument("--realtime", action="store_true")
    args = parser.parse_args()
    if not args.model.is_dir() or not 50 <= args.chunk_ms <= 1000:
        raise ValueError("需要本地模型目录,chunk-ms 必须为 50 至 1000")
    model = Model(model_path=str(args.model.resolve()))
    recognizer = KaldiRecognizer(model, RATE)
    recognizer.SetWords(True)
    session = StreamingSession(recognizer, uuid.uuid4().hex)
    with wave.open(str(args.audio), "rb") as audio:
        started = time.monotonic()
        samples = 0
        for chunk in pcm_chunks(audio, RATE * args.chunk_ms // 1000):
            samples += len(chunk) // 2
            if args.realtime:
                time.sleep(max(0, started + samples / RATE - time.monotonic()))
            emit(session.accept(chunk))
    emit(session.finish())


if __name__ == "__main__":
    main()
运行示例,将目录和路径换成实际本地值。
python streaming_asr.py --model ./models/vosk --audio ./test-16k.wav --chunk-ms 200终端按 JSON Lines 输出。中间结果的数量和识别文字因素材而异,末尾应有一次 closed。核对 eventId 单调递增、同句段中间结果被替换、空最终段能清除草稿,以及刷新后不重复提交。服务端传输重试可按 sessionId + eventId 去重。跨会话结果不能覆盖当前草稿。
--realtime 根据已读到的累计样本数等待至块末时刻,最后一个短块按实际长度等待。这只是单进程模拟,落后时不会继续叠加固定睡眠。真实麦克风链路另需有界队列、音频顺序检查、过载策略和时延埋点。可以丢弃过期 UI 中间结果;若音频块缺失,要显式记录或重开识别会话,不能当作连续音频处理。
用同一音频分别以 100、200 和 500 ms 测试。单独记录首个非空中间结果和最终结果时刻,固定是否使用实时节奏,再比较总时长与文本。分块变小不保证延迟下降,也不保证 Vosk 在不同端点切分条件下逐段完全一致。