
AI 内容创作 / 系统课时
人脸检测与关键点定位
人脸检测与关键点定位
数字人驱动不能只知道“画面里有人脸”,还要获得稳定的人脸区域、关键点和头部姿态。本课将把检测、定位、姿态解析与可视化串成一条可验证流程,并说明置信度阈值和视频抖动为何会直接影响口型与表情驱动。
学习目标
- 理解人脸检测、稠密关键点和头部姿态三类结果的职责边界。
- 使用 MediaPipe Face Landmarker 与 OpenCV 完成单张图像分析和结果可视化。
- 能够针对低置信度、遮挡和视频关键点抖动设计基础质量控制策略。
核心流程
人脸分析通常先确认人脸是否存在,再在有效区域内定位关键点,最后依据规范人脸到当前人脸的变换估计姿态。检测框用于裁剪和调度,关键点用于口型、眼动及表情驱动,姿态角用于控制头部旋转;三者不能互相替代。
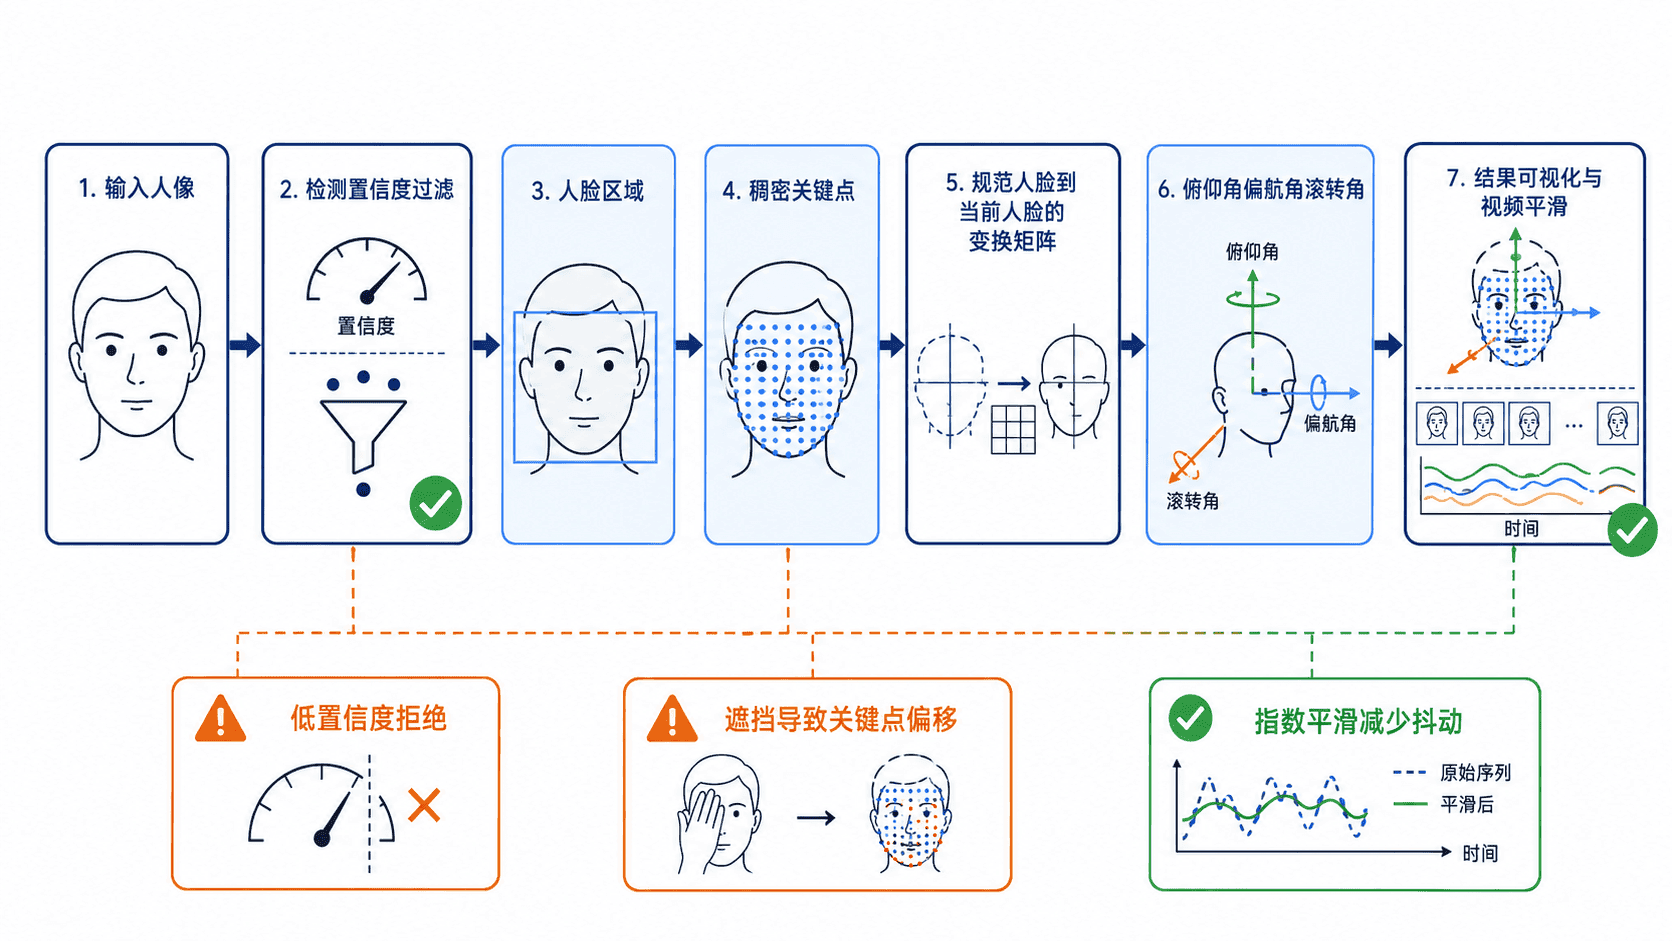
置信度阈值决定“是否接受本次结果”,并不代表几何位置一定准确。阈值过低会让侧脸、模糊区域或背景纹理进入后续流程;阈值过高则可能漏掉快速运动和局部遮挡。工程上应同时检查检测状态、关键点是否越界、姿态是否突变以及连续帧是否稳定。
| 结果 | 主要用途 | 关键边界 |
|---|---|---|
| 人脸区域 | 裁剪、缩放、资源调度 | 框过紧会切掉下巴和额头,框过松会引入背景 |
| 稠密关键点 | 口型、眼动、表情和几何对齐 | 单帧准确不等于时间上稳定 |
| 姿态角 | 头部朝向判断和驱动 | 角度正负与坐标系约定必须统一 |
| 置信度阈值 | 拒绝不可靠结果 | 需要结合漏检率和误检率调节 |
完整可运行示例
准备一张有权用于调试且只包含一张清晰人脸的 portrait.jpg,从 Face Landmarker 官方模型列表 获取 Face Landmarker 模型文件,保存为 models/face_landmarker.task。模型与 Python 包版本应随实验结果记录。安装依赖:
python -m pip install mediapipe opencv-python-headless numpy将下面代码保存为 face_landmark_pose.py。程序提取稠密关键点,从关键点范围得到调试框,再从规范脸到当前脸的 4×4 变换估算姿态。这里约定矩阵按 Rz·Ry·Rx 分解,依次把绕 X、Y、Z 的角称为俯仰、偏航和滚转。角度符号要在目标渲染器和镜像预览上通过已知朝向校准。接近偏航 ±90° 时,三个欧拉角没有唯一解;实时驱动可保留旋转矩阵或四元数。
若 Linux 的 MediaPipe wheel 在启动时报缺少 libGLESv2.so.2,应补对应发行版的运行库(例如 Ubuntu 的 libgles2);CPU 推理的 wheel 也可能链接图形运行库。
import argparse
import math
from pathlib import Path

import cv2
import mediapipe as mp
import numpy as np

def rotation_part(transform: np.ndarray) -> np.ndarray:
    if transform.shape != (4, 4) or not np.isfinite(transform).all():
        raise ValueError("面部变换必须是有限的 4×4 矩阵")
    left, scales, right = np.linalg.svd(transform[:3, :3])
    rotation = left @ right
    if scales[0] == 0.0 or scales[-1] / scales[0] < 1e-6 or np.linalg.det(rotation) <= 0:
        raise ValueError("变换退化或包含镜像,无法按当前坐标约定解析姿态")
    return rotation

def rotation_matrix_to_euler(rotation: np.ndarray) -> tuple[float, float, float]:
    """分解 Rz·Ry·Rx 并返回 X、Y、Z 三个角,单位为度。"""
    sy = math.sqrt(rotation[0, 0] ** 2 + rotation[1, 0] ** 2)
    singular = sy < 1e-6

    if not singular:
        pitch = math.atan2(rotation[2, 1], rotation[2, 2])
        yaw = math.atan2(-rotation[2, 0], sy)
        roll = math.atan2(rotation[1, 0], rotation[0, 0])
    else:
        pitch = math.atan2(-rotation[1, 2], rotation[1, 1])
        yaw = math.atan2(-rotation[2, 0], sy)
        roll = 0.0

    return tuple(float(value) for value in np.degrees([pitch, yaw, roll]))

def clamp(value: int, lower: int, upper: int) -> int:
    return max(lower, min(value, upper))

def main() -> int:
    parser = argparse.ArgumentParser()
    parser.add_argument("--input", required=True, help="输入人像路径")
    parser.add_argument("--model", required=True, help="Face Landmarker 模型路径")
    parser.add_argument("--output", default="output/face_debug.png")
    args = parser.parse_args()

    image_bgr = cv2.imread(args.input)
    if image_bgr is None:
        raise FileNotFoundError(f"无法读取输入图像: {args.input}")

    image_rgb = cv2.cvtColor(image_bgr, cv2.COLOR_BGR2RGB)
    mp_image = mp.Image(image_format=mp.ImageFormat.SRGB, data=image_rgb)

    options = mp.tasks.vision.FaceLandmarkerOptions(
        base_options=mp.tasks.BaseOptions(model_asset_path=args.model),
        running_mode=mp.tasks.vision.RunningMode.IMAGE,
        num_faces=1,
        min_face_detection_confidence=0.5,
        min_face_presence_confidence=0.5,
        output_facial_transformation_matrixes=True,
    )

    with mp.tasks.vision.FaceLandmarker.create_from_options(options) as landmarker:
        result = landmarker.detect(mp_image)

    if not result.face_landmarks:
        print("未检测到人脸")
        return 2
    if not result.facial_transformation_matrixes:
        raise RuntimeError("模型未返回面部变换矩阵")

    height, width = image_bgr.shape[:2]
    landmarks = result.face_landmarks[0]
    points = [
        (
            clamp(round(point.x * width), 0, width - 1),
            clamp(round(point.y * height), 0, height - 1),
        )
        for point in landmarks
    ]

    xs = [point[0] for point in points]
    ys = [point[1] for point in points]
    margin = round(0.04 * max(width, height))
    x1 = clamp(min(xs) - margin, 0, width - 1)
    y1 = clamp(min(ys) - margin, 0, height - 1)
    x2 = clamp(max(xs) + margin, 0, width - 1)
    y2 = clamp(max(ys) + margin, 0, height - 1)

    canvas = image_bgr.copy()
    cv2.rectangle(canvas, (x1, y1), (x2, y2), (0, 220, 0), 2)
    for index, point in enumerate(points):
        if index % 4 == 0:
            cv2.circle(canvas, point, 1, (255, 120, 0), -1)

    transform = np.asarray(
        result.facial_transformation_matrixes[0], dtype=np.float64
    )
    pitch, yaw, roll = rotation_matrix_to_euler(rotation_part(transform))
    label = f"pitch={pitch:.1f} yaw={yaw:.1f} roll={roll:.1f}"
    cv2.putText(
        canvas,
        label,
        (x1, max(24, y1 - 10)),
        cv2.FONT_HERSHEY_SIMPLEX,
        0.6,
        (0, 220, 0),
        2,
        cv2.LINE_AA,
    )

    output_path = Path(args.output)
    output_path.parent.mkdir(parents=True, exist_ok=True)
    if not cv2.imwrite(str(output_path), canvas):
        raise OSError(f"无法写入输出图像: {output_path}")

    print("检测到人脸: 1")
    print(f"关键点数量: {len(points)}")
    print(f"人脸框: ({x1}, {y1}) - ({x2}, {y2})")
    print(
        "姿态角(度): "
        f"pitch={pitch:.1f}, yaw={yaw:.1f}, roll={roll:.1f}"
    )
    print(f"可视化结果: {output_path}")
    return 0

if __name__ == "__main__":
    raise SystemExit(main())
运行程序:
python face_landmark_pose.py --input portrait.jpg --model models/face_landmarker.task --output output/face_debug.png预期输出如下。坐标和角度由输入人像决定,关键点数量由模型决定。官方 Face Landmarker 模型输出 478 个关键点。
检测到人脸: 1
关键点数量: <COUNT>
人脸框: (<X1>, <Y1>) - (<X2>, <Y2>)
姿态角(度): pitch=<PITCH>, yaw=<YAW>, roll=<ROLL>
可视化结果: output/face_debug.png
同时应生成 output/face_debug.png,图中包含人脸框、抽样关键点和姿态角文本。若控制台输出“未检测到人脸”,程序会以状态码 2 结束,不会产生误导性的空结果。
质量控制与练习
视频中的关键点抖动通常来自图像噪声、快速运动、遮挡和检测器重新初始化。最简单的平滑方式是对每个关键点应用指数移动平均:。较小的 更平稳但延迟更大,口型关键点与头部姿态可以使用不同参数。
常见错误包括把 BGR 图像直接作为 SRGB 输入、忘记限制归一化坐标导致绘制越界、混淆俯仰与偏航的坐标轴,以及在低置信度帧上继续驱动角色。修复时应先验证颜色空间和坐标范围,再记录连续帧角度变化;若单帧跳变超过业务阈值,应保持上一稳定值或触发重新检测。
练习一:将示例改为读取 5 秒视频,将运行模式改为 VIDEO,通过 detect_for_video 传入严格递增的毫秒时间戳;对连续有效帧的 yaw 做指数平滑。若角度跨过表示的折返点,先处理角度展开,或者直接平滑四元数;检测中断或切换人物时重置滤波器。输入视频中人物应缓慢左右转头;验收条件是平滑曲线无明显单帧尖峰,且方向变化没有被反转。
练习二:分别把检测阈值设为 0.3、0.5 和 0.8,在正脸、侧脸和轻度遮挡图像上记录成功率。验收条件是能够说明误检与漏检如何随阈值变化,并为数字人素材采集选择一组可解释的默认值。
本课总结
- 人脸框负责定位,稠密关键点负责局部驱动,姿态矩阵负责整体朝向,三类结果应分别验证。
- 置信度只能过滤明显不可靠结果,仍需检查坐标越界、姿态突变和连续帧稳定性。
- 可视化调试图是定位颜色空间、坐标系和关键点抖动问题的最低成本手段。
下一课预告
下一课将学习“人像分割与背景处理”,把人物从原始背景中分离出来,并通过边缘优化、发丝处理和透明蒙版生成,为后续视频合成准备可直接使用的前景资产。