
AI 内容创作 / 系统课时
数字人系统的核心模块
数字人系统的核心模块
本课从一次完整交互出发,拆解语音识别、语言模型、语音合成、形象驱动、渲染与实时通信的职责,并建立模块间的数据流、依赖关系和故障边界。
学习目标
- 说明数字人端到端链路中各核心模块的输入与输出
- 理解文本链路、音频链路和视频链路之间的依赖关系
- 用延迟、同步、降级和转人工规则检查系统设计
端到端数据流
典型实时数字人从麦克风或文本框接收输入。语音输入先经过语音识别转成文本,语言模型结合会话上下文生成回复,语音合成输出音频,部分服务还会附带音素或口型时间信息,形象驱动据此生成口型和动作,渲染模块形成视频帧,实时通信负责把音视频送到用户端。
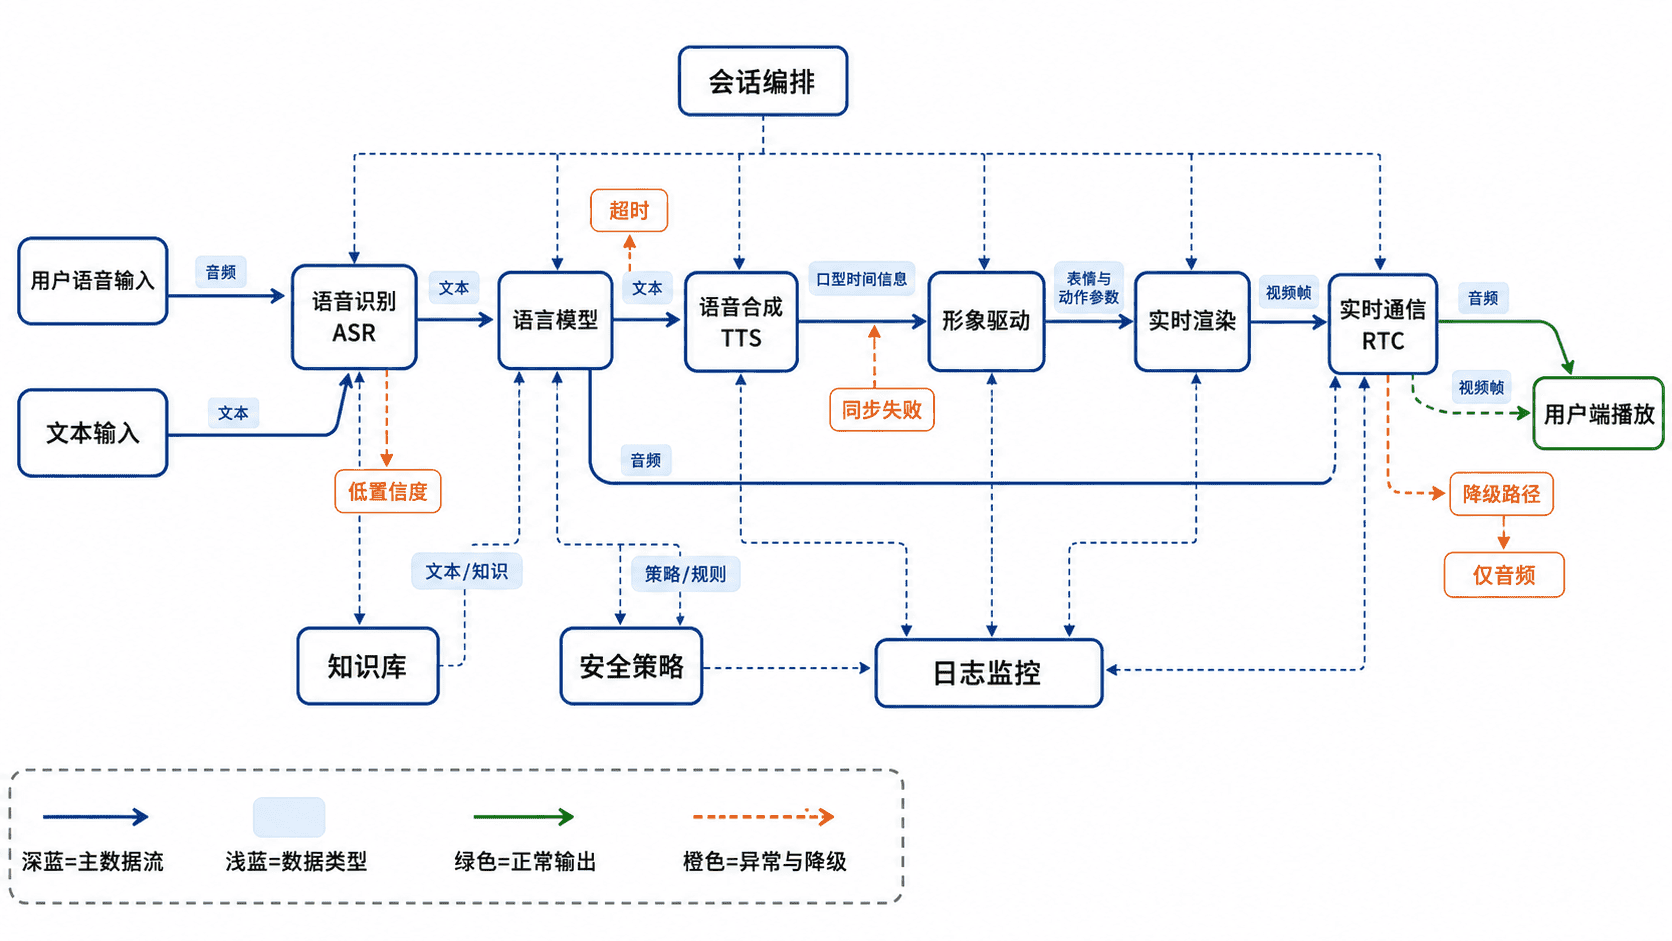
语音输入与文本输入并不完全相同。文本可直接进入语言模型,语音则需要额外处理端点检测、识别置信度和说话人打断。若系统支持流式处理,各模块可以边接收边输出,从而减少等待,但也会增加状态管理和同步难度。
模块职责与依赖
| 模块 | 主要输入 | 主要输出 | 关键依赖 |
|---|---|---|---|
| 语音识别 ASR | 音频帧、语言配置 | 部分或最终文本;时间戳和置信度取决于接口 | 音频质量、端点检测、领域词表 |
| 语言模型 | 用户文本、会话上下文、检索结果 | 回复文本、工具调用或控制指令 | 提示规则、知识来源、安全策略 |
| 语音合成 TTS | 回复文本、音色与语速参数 | 音频流;部分服务还提供音素或口型时间信息 | 音色授权、断句、流式首包速度 |
| 形象驱动 | 音素、音频特征、情绪与动作指令 | 口型、表情、骨骼或混合形状参数 | 角色绑定质量、动作库、同步时钟 |
| 渲染 | 角色资产、场景、动作参数 | 连续视频帧 | GPU 能力、分辨率、帧率与画质设置 |
| 实时通信 RTC | 上下行音视频流、网络状态 | 用户端可播放的媒体流 | 带宽、抖动、丢包、拥塞控制 |
| 会话编排 | 各模块状态、会话标识、超时事件 | 调度、重试、取消与降级决策 | 状态机、日志、监控和人工接管 |
模块之间传递的不只是内容,还包括时间信息和控制信号。例如,TTS 给出的音素时间戳会影响口型同步;用户打断时,编排层立即停播并清空本轮音视频缓冲,向支持取消的上游传播信号。新一轮使用新的生成 ID。即使旧 TTS 或渲染结果已经在途,播放端也会丢弃它。已经执行的外部工具动作需独立核验。
实时性与故障边界
实时体验主要观察两类指标:第一类是用户语音结束到设备实际播放首段回应的端到端等待时间;服务器首包到达是其中一个可单独记录的节点,第二类是回应开始后音频和画面是否连续。首包时延过长会让交互显得迟钝,持续播放不稳定则会表现为卡顿、口型错位或声音先于画面。
系统不应把所有错误都交给同一个重试逻辑。ASR 置信度过低时应请求用户重述;语言模型超时可以返回受控提示;TTS 失败时可先显示文字;渲染负载过高时可降低分辨率或帧率;网络持续异常时应切换为纯音频或结束会话。
| 故障点 | 可观察现象 | 推荐处理 |
|---|---|---|
| ASR 识别不确定 | 文本与原话偏差大 | 展示确认文本并请求重述 |
| 语言模型超时 | 长时间无回复 | 取消本轮生成并返回固定提示 |
| TTS 首包过慢 | 已有文字但迟迟无声音 | 先显示字幕,必要时切换备用音色 |
| 口型与音频不同步 | 嘴型明显提前或滞后 | 把音视频时间映射到统一播放时间线,核对各自缓冲和时钟漂移 |
| RTC 网络抖动 | 卡顿、花屏或断音 | 降码率、降分辨率或退化为音频 |
按生成轮次接收媒体片段
以下例子只演示切轮和去重。在调用此函数前,传输层已经将每种媒体的时间戳换算到同一播放时间轴。不同 RTP 流的原始时间戳具有不同起点和时钟频率,可借助 RTCP Sender Report 里的 NTP 和 RTP 时间对应关系同步。序号在本例中按每一轮、每一轨独立递增;真实网络接收还需要单独处理缺口和抖动。
active_turn = "reply-2"
last_sequence = {}

def accept_media(turn: str, track: str, sequence: int) -> bool:
    if turn != active_turn or sequence <= last_sequence.get(track, -1):
        return False
    last_sequence[track] = sequence
    return True

print(accept_media("reply-2", "audio", 0))  # True
print(accept_media("reply-1", "video", 5))  # False
print(accept_media("reply-2", "audio", 0))  # False
print(accept_media("reply-2", "video", 0))  # True
切换生成轮次时重置该轮序号和播放队列。第一帧、首段可听声音和中途卡顿分别测量。
设计与验收检查
最小可用系统应先保证链路完整,再追求表情丰富和高画质。开发阶段可按“文本问答可用、语音往返可用、口型同步可用、实时传输稳定”的顺序逐层验收,这样能快速定位问题属于语义、音频、动画还是网络。
上线前至少要验证连续对话、用户打断、静音输入、识别失败、模型超时、网络抖动和人工接管。每个异常都应有明确的用户可见反馈,不能让界面停在无响应状态,也不能让过期音频继续播放。
本课总结
- 数字人系统由语义链、音频链、动画链和传输链共同组成,任何一段都可能成为体验瓶颈
- 模块接口既要传递内容,也要传递时间戳、置信度、取消和状态信号
- 可靠系统必须为识别失败、生成超时、合成异常、渲染过载和网络波动设计独立降级路径
下一课预告
后续将继续围绕开发环境、数据准备和最小可用链路展开,把本课的数据流模型落实为可验证的工程组件。