
AI 内容创作 / 系统课时
语音合成系统原理
语音合成系统原理
语音合成并不是把文字直接“播放”出来,而是依次完成文本理解、发音表示、声学特征预测、波形生成和音频修整。本课将建立端到端处理链路,说明各模块的输入输出,并帮助你判断质量、速度与实时延迟之间的取舍。
学习目标
- 说明文本前端、声学模型、声码器和后处理模块的职责
- 理解梅尔频谱等中间表示如何连接文本与音频波形
- 根据离线生成和实时交互场景选择合适的合成方案
系统链路与模块职责
以分阶段架构为例,处理从原始文本开始。文本前端先统一数字、日期、缩写和标点读法,再把句子转换为字、音素或其他离散符号。声学模型根据这些符号预测时长、音高、能量和梅尔频谱,声码器以频谱等特征为条件合成 PCM 波形,再按任务做响度、静音、采样率与编码处理。梅尔频谱并不保留足以唯一反推出波形的全部信息。端到端模型也可把部分模块集成,不一定对外提供梅尔谱接口。
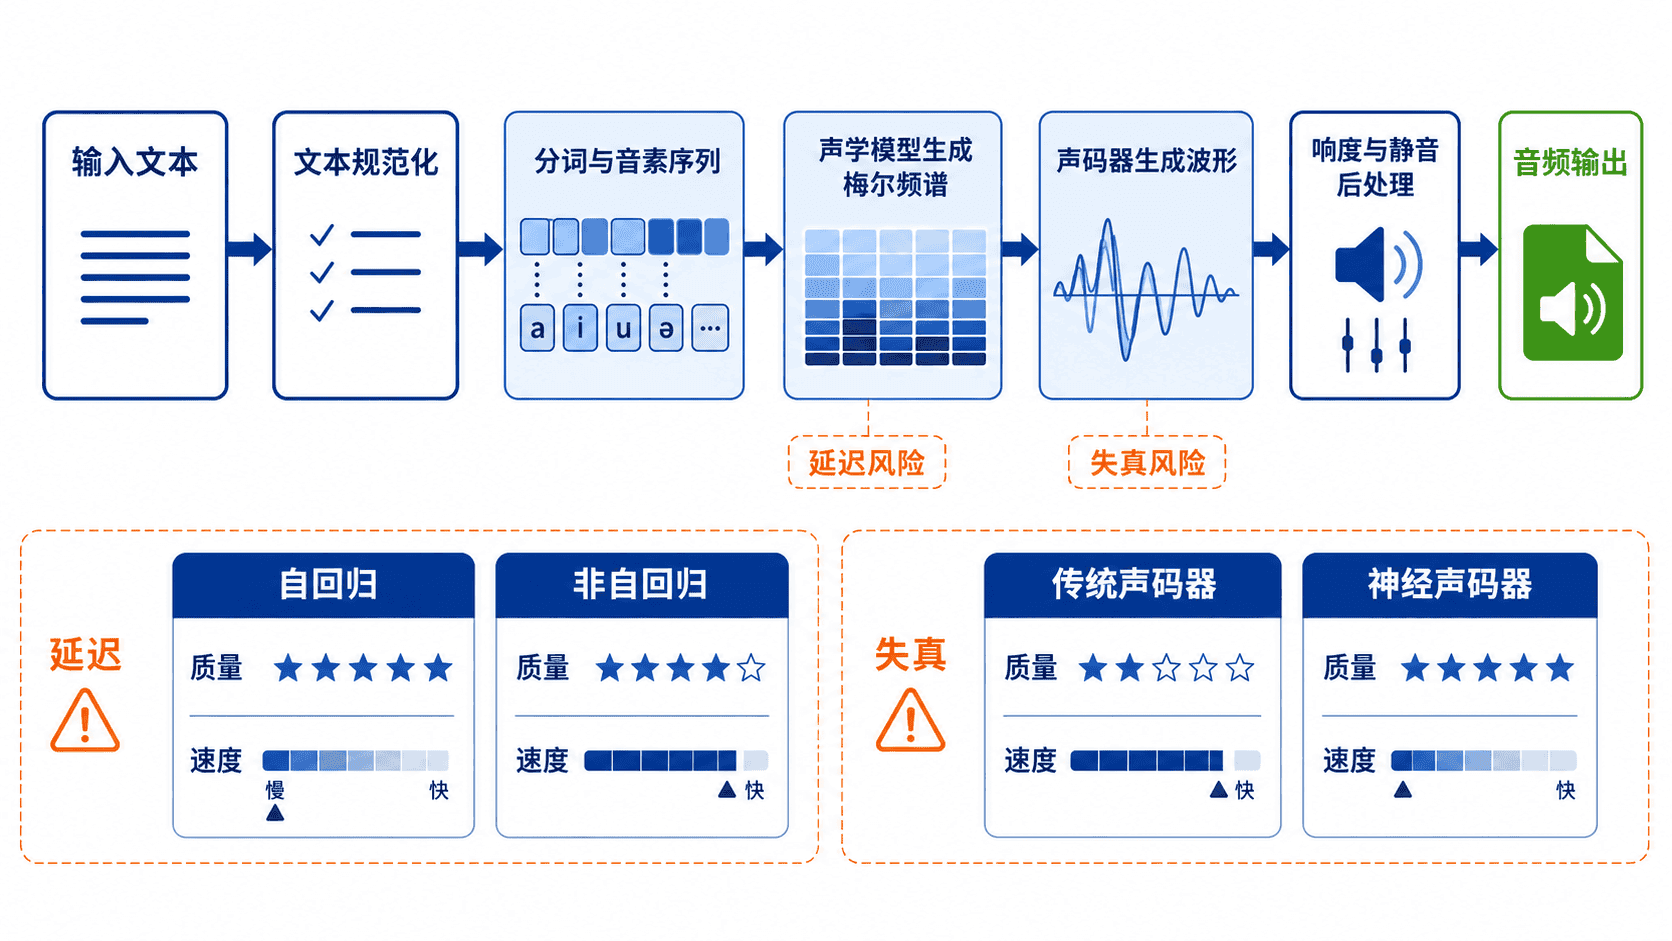
各模块之间应使用明确的数据契约。例如,文本前端输出符号序列和停顿信息,声学模型输出固定维度的频谱帧,声码器输出采样率确定的浮点或整数波形。接口越清晰,越容易替换模型、测试单个模块并定位异常。
声学模型与声码器的分工
声学模型解决“应该怎样说”,需要预测每个符号持续多久、基频如何变化、哪里重读以及能量怎样分布。声码器解决“如何把特征变成声音”,它接收梅尔频谱等条件,生成连续采样点。两者职责不同,不能把发音错误简单归因于声码器,也不能用后处理修复错误读法。
| 方案维度 | 常见特点 | 适用场景 |
|---|---|---|
| 自回归声学模型 | 逐步生成,表现力较强但延迟较高 | 高质量离线配音 |
| 非自回归声学模型 | 并行生成,速度快且时长可控 | 数字人实时对话 |
| 神经声码器 | 计算量和音质随架构及硬件变化 | 先按延迟、资源和听感实测再选型 |
| 轻量声码器 | 延迟低、资源占用小,细节可能受损 | 移动端和低算力设备 |
实时系统除了关注整句生成速度,还应记录首包延迟和实时率。实时率可写为 。当同一计时口径下 时,整段生成耗时小于音频时长。首包等待、网络抖动和播放缓冲仍会影响实际开口时间与连续性。
后处理与工程边界
后处理通常包含去除首尾静音、限制峰值、响度归一化、淡入淡出、重采样和编码。它可以改善播放一致性,却不能纠正音素、重音或韵律错误。工程上应保留后处理前后的音频与指标,避免把模型问题掩盖成“听起来稍好”的结果。
流式合成还要把长文本切成可连续播放的小段。切分点应优先落在句号、问号或自然停顿处,并为相邻音频保留平滑衔接。切得过短会增加调用和拼接开销,切得过长则会抬高首包延迟。
可运行的最小管线演示
下面的 Python 3.10 示例不生成真实语音,而是用确定性数据模拟四个模块的接口。它能够直接运行,并展示符号数量如何影响频谱帧数、采样点数量和预计时长。
from dataclasses import dataclass
import re

@dataclass
class AcousticFeatures:
    frames: int
    mel_bins: int = 80

class MiniTtsPipeline:
    def normalize(self, text: str) -> str:
        text = re.sub(r"(?<![A-Za-z0-9_])AI(?![A-Za-z0-9_])", "A I", text)
        return re.sub(r"\s+", " ", text).strip()

    def tokenize(self, text: str) -> list[str]:
        punctuation = ",。!?"
        return [
            ch
            for ch in text
            if not ch.isspace() and ch not in punctuation
        ]

    def acoustic_model(self, tokens: list[str]) -> AcousticFeatures:
        # 教学模型:假设每个符号对应 5 帧梅尔特征。
        return AcousticFeatures(frames=len(tokens) * 5)

    def vocoder(self, features: AcousticFeatures) -> dict:
        # 假设每帧推进 256 个采样点,采样率为 24 kHz。
        samples = features.frames * 256
        return {"sample_rate": 24000, "samples": samples}

    def postprocess(self, waveform: dict) -> dict:
        duration = waveform["samples"] / waveform["sample_rate"]
        return {
            **waveform,
            "duration": round(duration, 3),
        }

    def run(self, text: str) -> None:
        normalized = self.normalize(text)
        tokens = self.tokenize(normalized)
        features = self.acoustic_model(tokens)
        waveform = self.vocoder(features)
        result = self.postprocess(waveform)

        print(f"前端文本: {normalized}")
        print(f"符号数量: {len(tokens)}")
        print(f"梅尔帧数: {features.frames}")
        print(f"PCM 采样点: {result['samples']}")
        print(f"预计时长: {result['duration']} 秒")

if __name__ == "__main__":
    MiniTtsPipeline().run("欢迎来到 AI 数字人课程。")
将代码保存为 mini_tts_pipeline.py,然后运行:
python mini_tts_pipeline.py预期输出:
前端文本: 欢迎来到 A I 数字人课程。
符号数量: 11
梅尔帧数: 55
PCM 采样点: 14080
预计时长: 0.587 秒
此处仅按帧步长估算样本数,未生成波形,无法测量峰值。真实声码器输出长度还取决于填充、端点与上采样策略。示例中的帧数规则是教学假设,真实模型会根据文本上下文、语速和停顿预测时长。验证真实系统时,应分别检查前端序列、频谱帧、原始波形和后处理结果,而不是只试听最终文件。
本课总结
- 语音合成由文本前端、声学模型、声码器和后处理模块共同完成
- 声学模型负责韵律与频谱,声码器负责把频谱转换为连续波形
- 实时体验需要同时控制首包延迟、实时率、切分策略和音频衔接
下一课预告
下一课将学习“文本规范化与读法控制”,把日期、金额、缩写、英文和专业术语转换为稳定读法,并使用停顿标记控制节奏。