
AI 内容创作 / 系统课时
流式合成与语音质量评估
流式合成与语音质量评估
数字人需要在回答尚未全部生成时尽快开口,同时保持句间连续、音频不卡顿。本课将建立分句合成、音频块排序、缓冲播放和质量评估链路,并用可运行程序计算首包延迟、实时率和播放欠载次数。
学习目标
- 设计分句合成、音频块返回与连续播放流程
- 正确计算首包延迟、实时率和播放欠载
- 建立自然度、相似度与异常发音的联合验收方法
流式链路与缓冲策略
流式语音合成不是简单地把长文本切成多段。系统需要先按标点和语义边界生成稳定句子,再为每句分配顺序号,将返回的音频块放入队列。播放器通常先积累少量连续音频再开始播放,以吸收网络和推理抖动。若流已经结束且音频很短,可直接播放剩余内容,避免永远达不到启动阈值。
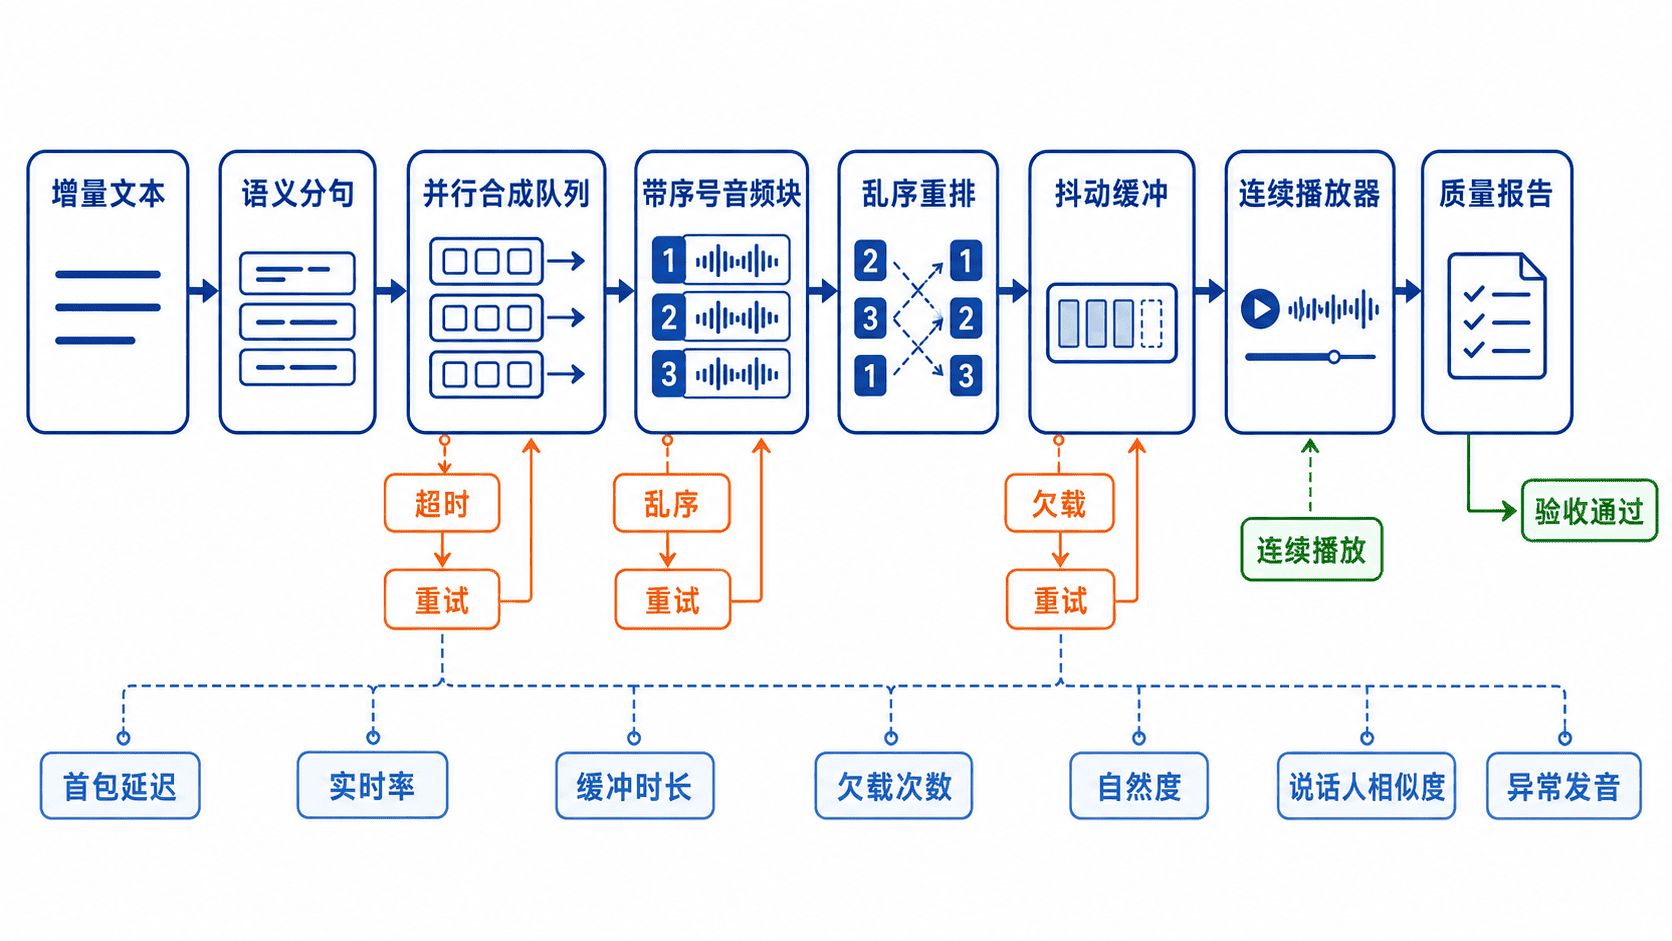
切分过短会增加请求数和句间音色波动,切分过长又会推高首包延迟。服务型对话可优先按完整短句切分,并设置最小字符数与最大等待时间。音频块必须携带 sentence_id、sequence、采样率、声道数和持续时长,播放器只消费连续序号,缺块时先短暂等待,再按策略重试或降级。
指标体系与验收口径
实时率 RTF 等于合成耗时除以生成音频时长。RTF < 1 表示合成速度快于实时播放,但它不能替代首包延迟:一个系统可能总体很快,却在第一块音频返回前等待很久。线上评估还要同时观察缓冲欠载、句间断裂和异常发音。
| 指标 | 计算或评估方式 | 主要用途 |
|---|---|---|
| 首包延迟 | 从提交首句到第一块可解码音频到达 | 判断交付速度;另报真实播放开始 |
实时率 RTF |
合成墙钟时间 ÷ 音频总时长 | 判断持续生成能力 |
| 欠载次数 | 播放中耗尽连续可用音频并进入重新缓冲的次数 | 排除开播前等待及自然播完 |
| 自然度 | 固定文本的人工评分或成对偏好 | 判断听感 |
| 说话人相似度 | 人工对比或说话人嵌入相似度 | 判断角色一致性 |
| 异常发音率 | 数字、英文、专名和多音字错误数 ÷ 检查项数 | 判断文本覆盖质量 |
完整可运行示例
下面用 Python 3.11 模拟块接收和缓冲播放。时刻均为提交后毫秒,音频块时长应由经过校验的帧数和采样率换算。先按连续序号入缓冲,重复块只计一次。结束记录声明最后的序号。脚本计算到末个有效块的交付耗时比,服务端生成 RTF 需要独立测量。
from dataclasses import dataclass


@dataclass(frozen=True)
class Chunk:
    seq: int
    at_ms: int
    audio_ms: int


def evaluate(chunks, final_seq, end_ms, target=360):
    if type(target) is not int or target <= 0:
        raise ValueError("positive buffer target required")
    if type(final_seq) is not int or final_seq <= 0 or type(end_ms) is not int or end_ms < 0:
        raise ValueError("invalid end marker")
    seen, waiting = {}, {}
    next_seq = 1
    buffer = now = underruns = 0
    first = playback = last_packet = None
    playing = False

    def advance(at):
        nonlocal buffer, now, playing, underruns
        if playing:
            elapsed = at - now
            if elapsed > buffer:
                if next_seq <= final_seq:
                    underruns += 1
                buffer, playing = 0, False
            else:
                buffer -= elapsed
        now = at

    def start():
        nonlocal playing, playback
        playing = True
        if playback is None:
            playback = now

    for packet in chunks:
        if (
            any(type(value) is not int for value in (packet.seq, packet.at_ms, packet.audio_ms))
            or not 1 <= packet.seq <= final_seq or not now <= packet.at_ms <= end_ms
            or packet.audio_ms <= 0
        ):
            raise ValueError("invalid packet")
        advance(packet.at_ms)
        if packet.seq in seen:
            if seen[packet.seq] != packet.audio_ms:
                raise ValueError("conflicting duplicate")
            continue
        if first is None:
            first = now
        last_packet = now
        seen[packet.seq] = waiting[packet.seq] = packet.audio_ms
        while next_seq in waiting:
            buffer += waiting.pop(next_seq)
            next_seq += 1
        if not playing and buffer >= target:
            start()

    advance(end_ms)
    if next_seq != final_seq + 1:
        raise ValueError("stream ended with missing chunks")
    if not playing and buffer:
        start()
    duration = sum(seen.values())
    return {
        "first_packet_ms": first, "playback_start_ms": playback,
        "audio_ms": duration, "delivery_ratio": round(last_packet / duration, 3),
        "underruns": underruns,
    }


if __name__ == "__main__":
    chunks = [Chunk(2, 80, 200), Chunk(1, 150, 200),
              Chunk(2, 210, 200), Chunk(3, 800, 120)]
    print(evaluate(chunks, final_seq=3, end_ms=850))
    print(evaluate([Chunk(1, 80, 120)], final_seq=1, end_ms=100))
保存为 streaming_tts_metrics.py,运行 python streaming_tts_metrics.py。
{'first_packet_ms': 80, 'playback_start_ms': 150, 'audio_ms': 520, 'delivery_ratio': 1.538, 'underruns': 1}
{'first_packet_ms': 80, 'playback_start_ms': 100, 'audio_ms': 120, 'delivery_ratio': 0.667, 'underruns': 0}
生产应为每个请求绑定流 ID,逐块校验编码、采样率、声道、字节数、序号和负载摘要。同序号、同长度的数据也可能不同。为乱序等待设置容量和期限,超限时停止或明确降级。取消后隔离旧流的迟到数据。此例仅模拟缓冲,不包含真实音频设备、播放时钟漂移和网络。
验收自然度与发音
同时记录首包、可播放时刻、实际开口和结束,以定位抖动缓冲与设备延迟。模型 RTF 在服务端按明确起止点测量,不能用请求末包到达时刻替代。固定文本、音色版本和渲染条件,覆盖数字日期、缩写、专名、长句、疑问句、跨句衔接与不同情绪。逐项核对发音,把自然度与声音相似度分开收集。正式听评记录参与者、听音条件、量表、样本数及评分分布。合成测试音可以验证格式和播放流程,无法验证语音自然度。