
AI 内容创作 / 系统课时
基于音频特征的唇形同步
基于音频特征的唇形同步
本课把音频切成与视频帧严格对齐的特征窗口,再通过批量推理得到连续嘴部参数,最终完成逐帧渲染和音视频封装。你将掌握输入校验、时间戳映射、跨批次平滑与结果验收,避免嘴形提前、滞后或在批次边界跳变。
学习目标
- 能够将单声道 PCM 音频按视频帧率切片并提取 RMS、过零率等基础特征。
- 能够设计批量推理接口,并保持跨批次状态连续与音画时间一致。
- 能够生成带音轨的视频结果,并用帧数、时长和主观观感完成验收。
处理链路与核心机制
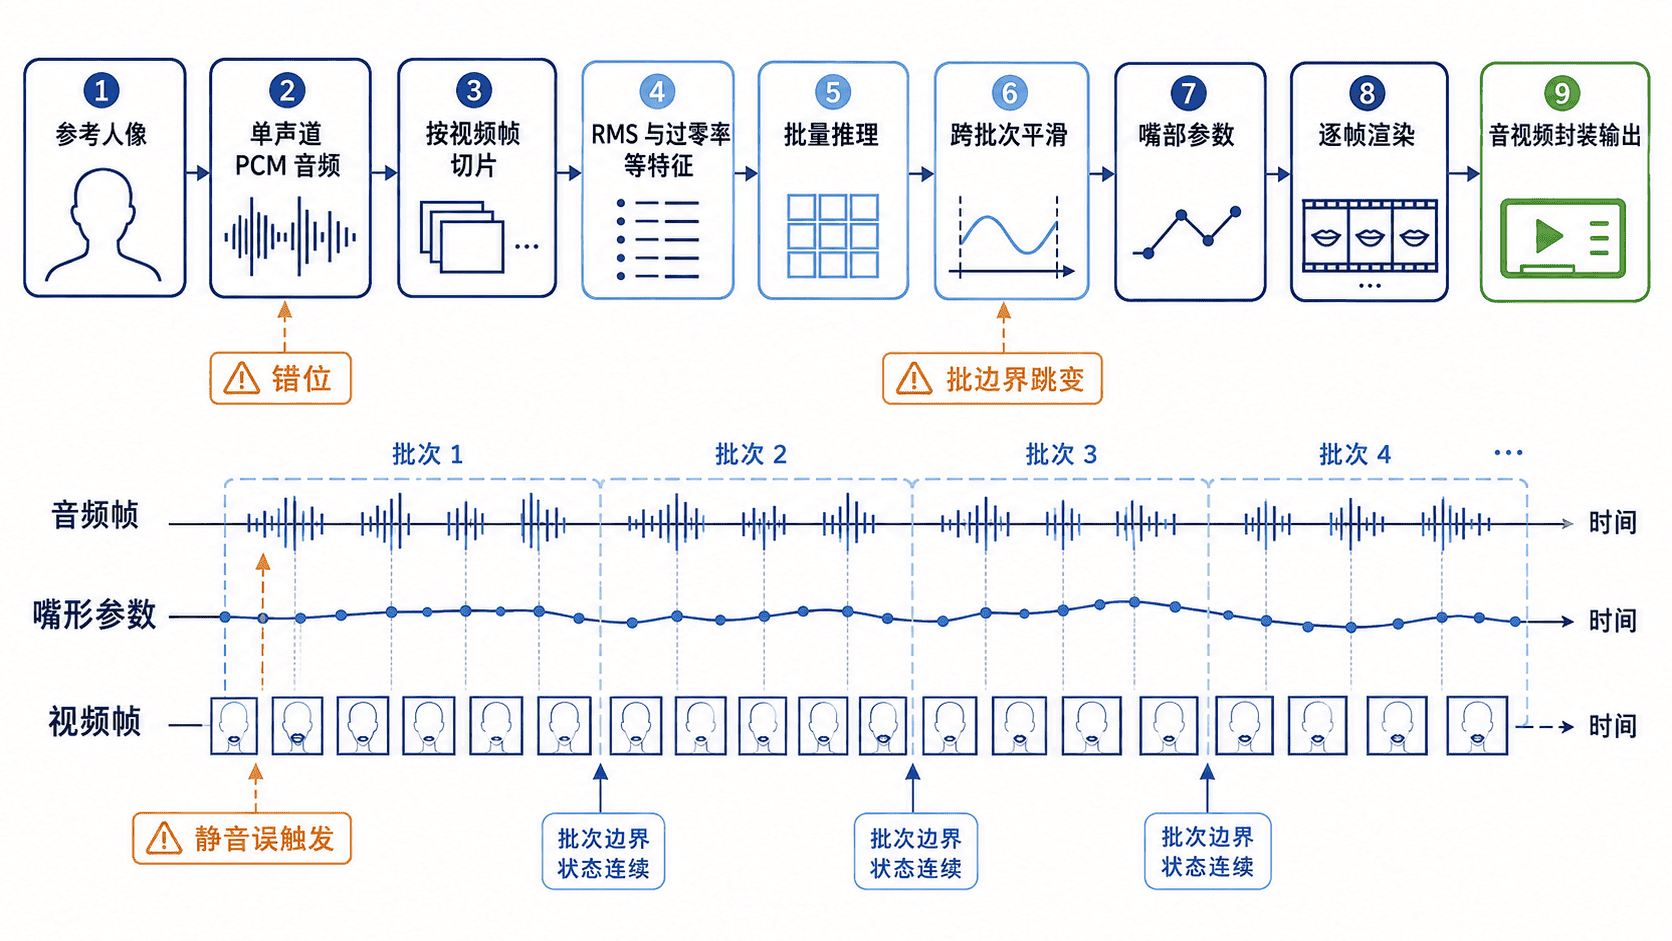
唇形同步的核心不是单独识别某个音素,而是建立稳定的时间映射。视频帧索引 i 对应时间 i / FPS,音频窗口也必须从同一时间点取样。若采样率为 16 kHz、视频为 25 FPS,则每帧恰好对应 640 个采样点。一般情况下,第 i 帧的采样区间采用 floor(i × 采样率 ÷ 帧率) 到 floor((i+1) × 采样率 ÷ 帧率),每帧重新计算边界。最后不足的部分可补零。真实项目还应统一音视频起始时间和采样方向(帧起点、中心或因果窗口)。
| 环节 | 输入 | 输出 | 关键校验 |
|---|---|---|---|
| 输入准备 | 参考人像、PCM 音频、目标帧率 | 统一规格素材 | 声道数、采样率、时长可读 |
| 特征提取 | 每帧音频窗口 | RMS、过零率或频谱特征 | 窗口数等于目标视频帧数 |
| 批量推理 | 连续特征批次 | mouth_open 等嘴部参数 |
批次顺序不变,状态跨批次延续 |
| 渲染封装 | 参考人像、参数序列、原音频 | MP4 视频 | 帧率、音轨、总时长一致 |
RMS 反映当前窗口的能量,可作为张嘴幅度的基础信号;过零率可粗略反映清辅音变化。RMS 和过零率只是启发信号,无法识别具体辅音或元音。真实模型可使用梅尔频谱、音素时间戳或上下文编码,但无论特征多复杂,输出都应统一为按帧排列的参数序列。对参数做限幅与一阶平滑,可以抑制噪声造成的快速抖动。
批量推理可以提高吞吐,但不能把每个批次当成完全独立的片段。平滑器、循环网络隐藏状态或上下文窗口必须跨批次保留,否则第 16、32、48 帧附近容易出现突变。输出阶段应先按帧渲染静音画面,再把原音频封装回视频,避免重新合成音频导致时长漂移。
完整可运行示例
下面的 Python 3.10+ 示例不依赖第三方 Python 包。它生成 3 秒测试音频和一张 PPM 参考人像,按 25 FPS 提取特征,以批大小 16 执行可替换的模型适配器,再通过系统中的 ffmpeg 输出带音轨的 lip_sync_result.mp4。测试音频是带包络的合成音调,PPM 是固定尺寸的卡通图形。这条最小链路验证开合与音画时间,生产接入还需授权素材、真实模型、坐标/通道绑定和质量验收。
from __future__ import annotations

import math
import shutil
import struct
import subprocess
import wave
from dataclasses import dataclass
from pathlib import Path

WIDTH = 320
HEIGHT = 320
FPS = 25
SAMPLE_RATE = 16000
DURATION_SECONDS = 3
BATCH_SIZE = 16

@dataclass(frozen=True)
class AudioFeature:
    rms: float
    zero_crossing_rate: float

def create_reference_ppm(path: Path) -> None:
    pixels = bytearray([245, 247, 250] * WIDTH * HEIGHT)

    def paint_ellipse(cx: int, cy: int, rx: int, ry: int, color: tuple[int, int, int]) -> None:
        for y in range(max(0, cy - ry), min(HEIGHT, cy + ry + 1)):
            for x in range(max(0, cx - rx), min(WIDTH, cx + rx + 1)):
                if ((x - cx) ** 2) / (rx * rx) + ((y - cy) ** 2) / (ry * ry) <= 1:
                    offset = (y * WIDTH + x) * 3
                    pixels[offset:offset + 3] = bytes(color)

    paint_ellipse(160, 155, 100, 125, (244, 210, 185))
    paint_ellipse(125, 130, 10, 6, (35, 45, 60))
    paint_ellipse(195, 130, 10, 6, (35, 45, 60))
    save_ppm(path, pixels)

def save_ppm(path: Path, pixels: bytearray) -> None:
    path.write_bytes(f"P6\n{WIDTH} {HEIGHT}\n255\n".encode("ascii") + pixels)

def load_ppm(path: Path) -> bytearray:
    data = path.read_bytes()
    header = f"P6\n{WIDTH} {HEIGHT}\n255\n".encode("ascii")
    if not data.startswith(header):
        raise ValueError("仅接收示例生成器的固定 P6 图像规格")
    pixels = bytearray(data[len(header):])
    if len(pixels) != WIDTH * HEIGHT * 3:
        raise ValueError(f"reference.ppm must be {WIDTH}x{HEIGHT}")
    return pixels

def create_speech_wav(path: Path) -> None:
    samples: list[int] = []
    total = SAMPLE_RATE * DURATION_SECONDS
    for index in range(total):
        time_seconds = index / SAMPLE_RATE
        # 三段不同强度的包络模拟发音与短暂停顿。
        segment = int(time_seconds * 4) % 4
        envelope = (0.75, 0.35, 0.0, 0.55)[segment]
        carrier = math.sin(2 * math.pi * 180 * time_seconds)
        harmonic = 0.35 * math.sin(2 * math.pi * 360 * time_seconds)
        sample = int(15000 * envelope * (carrier + harmonic))
        samples.append(max(-32768, min(32767, sample)))

    with wave.open(str(path), "wb") as wav_file:
        wav_file.setnchannels(1)
        wav_file.setsampwidth(2)
        wav_file.setframerate(SAMPLE_RATE)
        wav_file.writeframes(struct.pack(f"<{len(samples)}h", *samples))

def extract_features(path: Path) -> list[AudioFeature]:
    with wave.open(str(path), "rb") as wav_file:
        if wav_file.getnchannels() != 1 or wav_file.getsampwidth() != 2:
            raise ValueError("audio must be mono 16-bit PCM WAV")
        sample_rate = wav_file.getframerate()
        sample_count = wav_file.getnframes()
        raw = wav_file.readframes(sample_count)
        if sample_count == 0 or len(raw) != sample_count * 2 or sample_rate < FPS:
            raise ValueError("音频为空、PCM 不完整或采样率过低")
        samples = struct.unpack(f"<{sample_count}h", raw)

    frame_count = (sample_count * FPS + sample_rate - 1) // sample_rate
    features: list[AudioFeature] = []
    for index in range(frame_count):
        start = index * sample_rate // FPS
        end = (index + 1) * sample_rate // FPS
        frame = samples[start:end]
        frame += (0,) * (end - start - len(frame))
        rms = math.sqrt(sum(value * value for value in frame) / len(frame)) / 32768.0
        crossings = sum(
            1 for left, right in zip(frame, frame[1:]) if (left < 0 <= right) or (left >= 0 > right)
        )
        zcr = crossings / max(1, len(frame) - 1)
        features.append(AudioFeature(rms=rms, zero_crossing_rate=zcr))
    return features

class AudioFeatureLipSyncModel:
    def __init__(self) -> None:
        self.previous_open = 0.0

    def predict_batch(self, batch: list[AudioFeature]) -> list[float]:
        predictions: list[float] = []
        for feature in batch:
            target = min(1.0, feature.rms * 8.0 + feature.zero_crossing_rate * 0.8)
            # 跨批次保存上一帧状态,避免批边界出现嘴形跳变。
            smoothed = self.previous_open * 0.65 + target * 0.35
            self.previous_open = smoothed
            predictions.append(smoothed)
        return predictions

def draw_mouth(reference: bytearray, mouth_open: float) -> bytes:
    frame = bytearray(reference)
    cx, cy = 160, 215
    rx = 34
    ry = max(3, int(5 + mouth_open * 24))

    for y in range(cy - ry - 3, cy + ry + 4):
        for x in range(cx - rx - 3, cx + rx + 4):
            normalized = ((x - cx) ** 2) / ((rx + 3) ** 2) + ((y - cy) ** 2) / ((ry + 3) ** 2)
            if normalized <= 1:
                offset = (y * WIDTH + x) * 3
                frame[offset:offset + 3] = bytes((150, 55, 70))

    for y in range(cy - ry, cy + ry + 1):
        for x in range(cx - rx, cx + rx + 1):
            normalized = ((x - cx) ** 2) / (rx * rx) + ((y - cy) ** 2) / (ry * ry)
            if normalized <= 1:
                offset = (y * WIDTH + x) * 3
                frame[offset:offset + 3] = bytes((45, 20, 28))
    return bytes(frame)

def render_video(reference: bytearray, audio_path: Path, output_path: Path, mouth_values: list[float]) -> None:
    ffmpeg = shutil.which("ffmpeg")
    if ffmpeg is None:
        raise RuntimeError("ffmpeg is required and must be available in PATH")

    command = [
        ffmpeg,
        "-y",
        "-loglevel",
        "error",
        "-f",
        "rawvideo",
        "-pix_fmt",
        "rgb24",
        "-s",
        f"{WIDTH}x{HEIGHT}",
        "-r",
        str(FPS),
        "-i",
        "-",
        "-i",
        str(audio_path),
        "-map", "0:v:0",
        "-map", "1:a:0",
        "-c:v",
        "libx264",
        "-pix_fmt",
        "yuv420p",
        "-c:a",
        "aac",
        "-shortest",
        str(output_path),
    ]
    if not mouth_values:
        raise ValueError("没有可渲染的口型帧")
    with subprocess.Popen(command, stdin=subprocess.PIPE) as process:
        assert process.stdin is not None
        for value in mouth_values:
            process.stdin.write(draw_mouth(reference, value))
        process.stdin.close()
        if process.wait() != 0:
            raise RuntimeError("ffmpeg failed to encode the result")

def main() -> None:
    reference_path = Path("reference.ppm")
    audio_path = Path("speech.wav")
    output_path = Path("lip_sync_result.mp4")

    create_reference_ppm(reference_path)
    create_speech_wav(audio_path)
    reference = load_ppm(reference_path)
    features = extract_features(audio_path)

    model = AudioFeatureLipSyncModel()
    mouth_values: list[float] = []
    batch_count = 0
    for start in range(0, len(features), BATCH_SIZE):
        mouth_values.extend(model.predict_batch(features[start:start + BATCH_SIZE]))
        batch_count += 1

    render_video(reference, audio_path, output_path, mouth_values)
    print(f"reference: {reference_path}")
    print(f"audio: {audio_path}")
    print(f"frames: {len(mouth_values)}")
    print(f"batches: {batch_count}")
    print(f"video: {output_path}")

if __name__ == "__main__":
    main()
将代码保存为 audio_feature_lipsync.py,确认 ffmpeg 已加入 PATH,且构建包含 libx264 和 AAC 编码器,在临时工作目录运行(示例会覆盖同名输出):
python audio_feature_lipsync.py预期输出
reference: reference.ppm
audio: speech.wav
frames: 75
batches: 5
video: lip_sync_result.mp4
程序还会生成 reference.ppm、speech.wav 和 lip_sync_result.mp4。其中 75 帧来自 3 秒乘以 25 FPS,5 个批次来自对 75 帧按 16 帧分批并向上取整。打开视频后应看到嘴部随音频能量变化,并且停顿区间逐渐闭合。
工程验证与常见问题
验收时先检查机器指标,再检查主观效果。使用 ffprobe 核对音视频流数量、解码帧数、帧率、起始时间和持续时间。合成例的两路输入都从 0 开始;普通输入的尾帧补零只供特征计算,封装仍使用原音频,容器和各流时长可能因帧边界或 AAC 编码延迟略有不同;随后重点观察爆破音、短停顿和批次边界。若嘴形整体提前或滞后,优先检查音频起始静音、帧索引到时间戳的换算,以及模型是否额外引入了上下文延迟。
- 嘴形持续抖动:特征窗口过短、输入噪声过大或平滑系数过低。应先固定帧率,再增加上下文或使用带迟滞的平滑策略。
- 批次边界跳变:模型状态在每批开始时被重置。应把上一批末尾状态传给下一批,或在批次间保留重叠窗口并只取中心结果。
- 视频有画面但无声音:编码阶段只写入了视频流。应显式把原音频作为第二路输入,并在输出容器中选择视频和音频编码器。
- 嘴张开但发音不匹配:仅靠能量只能表达开合,不能区分圆唇、唇齿和闭口音。生产模型需要音素、频谱或上下文特征,并输出多个嘴部参数。
本课总结
- 音频特征、嘴部参数和视频帧必须共享同一帧率与时间基准。
- 批量推理提高吞吐,但跨批次状态、顺序和尾帧处理决定连续性。
- 最终验收要同时覆盖容器时长、音轨存在性、边界帧和主观音画同步。
下一课预告
下一课将学习“面部表情参数控制”,在口型参数之外加入眨眼、注视、眉毛和微笑等通道,并处理多层动画同时驱动同一面部区域时的优先级与冲突。