
AI 内容创作 / 系统课时
基于时间戳的口型驱动
基于时间戳的口型驱动
获得视素标签后,还需要把它们准确放到音频时间轴上,否则嘴形会提前、滞后或在停顿处保持不动。本课将使用起止时间生成口型关键帧,并通过过渡窗口、静音回落和边界校验得到可直接交给动画系统的时间序列。
学习目标
- 将带起止时间的视素片段转换为有序关键帧。
- 根据连续发音和停顿长度选择交叉过渡或闭口区间。
- 校验时间戳顺序、过渡时长和最终口型回落状态。
时间轴驱动链路
口型驱动的输入通常是音素或词级对齐结果,至少包含 start_ms、end_ms 和 viseme。系统先校验时间区间,再生成保持点和过渡点,最后由渲染端在关键帧之间做线性插值或曲线插值。
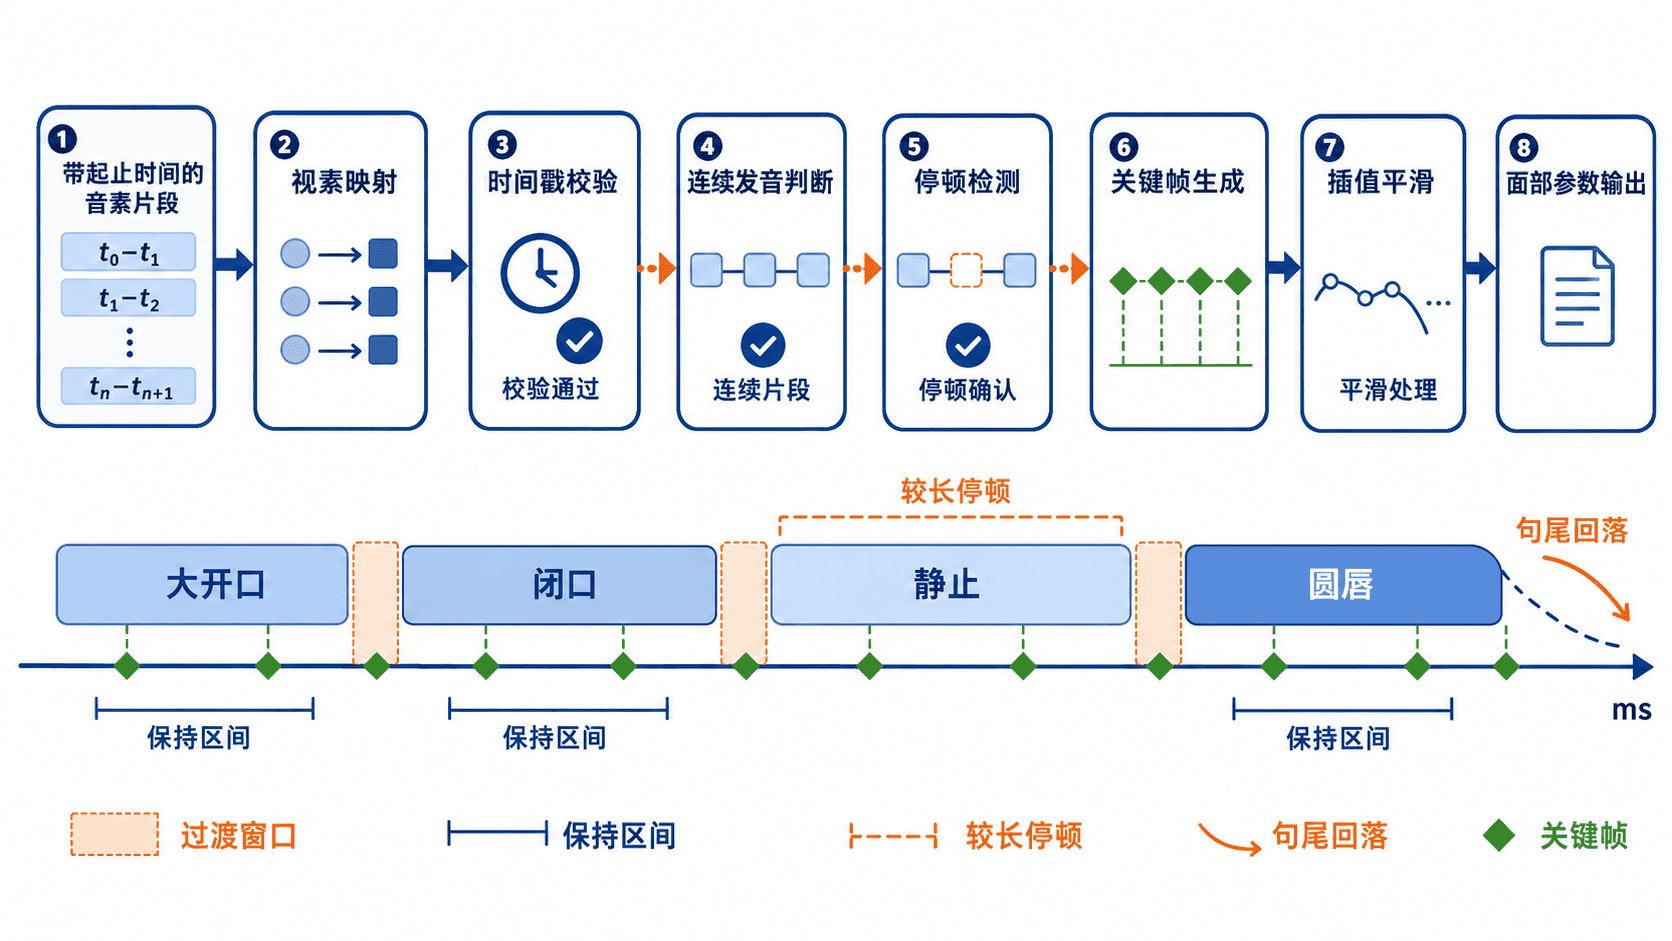
连续片段之间的间隔较小时,可以直接从当前视素过渡到下一个视素;间隔达到闭口阈值时,应先回到 REST,保持一段静止,再进入下一口型。这样既避免嘴部跳变,也能防止长停顿被错误地拉成长时间插值。
关键帧生成规则
设片段开始时间为 ,结束时间为 ,过渡时长为 。当前视素通常保持到 ,随后在剩余窗口内过渡到下一状态。实现时需要保证 ,并将过渡时长限制在片段持续时间以内。
| 情况 | 处理规则 | 结果 |
|---|---|---|
| 相邻片段首尾相接 | 在前一片段末尾进入下一视素 | 形成连续协同发音 |
| 间隔小于闭口阈值 | 过渡一直到下一片段起点,不插入 REST | 避免短暂停顿造成抖动 |
| 间隔不小于闭口阈值 | 前一片段结束时进入 REST |
形成明确闭口区间 |
| 最后一个片段结束 | 强制追加 REST |
防止嘴形停留在最后状态 |
| 时间戳逆序或重叠异常 | 拒绝生成并报告错误 | 避免渲染时间轴失真 |
词级时间戳只能提供较粗的边界,适合低成本方案;音素级时间戳可以更精确地表达闭口辅音和元音变化。无论输入粒度如何,都应先归一化为统一的毫秒时间轴,再进入关键帧生成器。
完整实现与验收
下面的程序接收已经完成视素映射的时间片。相邻片段在共同边界切入下一视素,短间隔把过渡延续至下一起点;较长停顿则插入两个 REST 关键帧,以便渲染器在停顿中间保持闭口。
from dataclasses import dataclass

@dataclass(frozen=True)
class Segment:
    start_ms: int
    end_ms: int
    viseme: str

def validate_segments(segments: list[Segment]) -> None:
    previous_end = 0
    for index, segment in enumerate(segments):
        if (type(segment.start_ms) is not int or type(segment.end_ms) is not int
                or segment.start_ms < 0 or segment.end_ms <= segment.start_ms):
            raise ValueError(f"segment {index} has an invalid time range")
        if index > 0 and segment.start_ms < previous_end:
            raise ValueError(f"segment {index} overlaps the previous segment")
        previous_end = segment.end_ms

def build_keyframes(
    segments: list[Segment],
    transition_ms: int = 40,
    close_gap_ms: int = 50,
) -> list[tuple[int, str]]:
    if (type(transition_ms) is not int or type(close_gap_ms) is not int
            or not 0 < transition_ms < close_gap_ms):
        raise ValueError("需要正整数时长,且过渡窗口小于闭口阈值")
    validate_segments(segments)
    if not segments:
        return [(0, "REST")]
    keyframes: list[tuple[int, str]] = []

    def add_key(time_ms: int, viseme: str) -> None:
        if keyframes and keyframes[-1] == (time_ms, viseme):
            return
        if keyframes and keyframes[-1][0] == time_ms:
            keyframes[-1] = (time_ms, viseme)
            return
        keyframes.append((time_ms, viseme))

    for index, segment in enumerate(segments):
        previous = segments[index - 1] if index > 0 else None
        following = segments[index + 1] if index + 1 < len(segments) else None

        if previous is None:
            if segment.start_ms > 0:
                add_key(0, "REST")
                add_key(max(0, segment.start_ms - transition_ms), "REST")
            add_key(segment.start_ms, segment.viseme)
        else:
            gap = segment.start_ms - previous.end_ms
            if gap >= close_gap_ms:
                # 在长停顿末端保留一个静止点,再进入新口型。
                add_key(max(previous.end_ms, segment.start_ms - transition_ms), "REST")
                add_key(segment.start_ms, segment.viseme)
            elif gap > 0:
                add_key(segment.start_ms, segment.viseme)

        hold_time = max(segment.start_ms, segment.end_ms - transition_ms)
        add_key(hold_time, segment.viseme)

        if following is None:
            add_key(segment.end_ms, "REST")
        else:
            next_gap = following.start_ms - segment.end_ms
            if next_gap < close_gap_ms:
                add_key(following.start_ms, following.viseme)
            else:
                add_key(segment.end_ms, "REST")

    return keyframes

def main() -> None:
    segments = [
        Segment(0, 180, "OPEN_LARGE"),
        Segment(180, 300, "CLOSED"),
        Segment(360, 520, "ROUNDED"),
    ]
    for time_ms, viseme in build_keyframes(segments):
        print(f"{time_ms:04d} ms -> {viseme}")

if __name__ == "__main__":
    main()
将代码保存为 timestamp_lip_sync.py,然后运行:
python timestamp_lip_sync.py预期输出:
0000 ms -> OPEN_LARGE
0140 ms -> OPEN_LARGE
0180 ms -> CLOSED
0260 ms -> CLOSED
0300 ms -> REST
0320 ms -> REST
0360 ms -> ROUNDED
0480 ms -> ROUNDED
0520 ms -> REST
渲染时按同一音频播放时钟采样关键帧,用视素对应的数值权重插值。实时播放以当前实际播放到的音频位置为参考,不能用 TTS 网络片段到达时间直接驱动。验收时可同时播放音频并观察慢速录屏。动态设备上的实际帧时间可能存在数毫秒偏差,因此不要只比较单帧截图;更可靠的指标是闭口辅音是否对齐、元音峰值是否落在发音主体内,以及停顿时是否稳定回到 REST。
本课总结
- 时间戳驱动的核心是把视素片段转换为有序、无逆序的关键帧时间轴。
- 连续发音适合平滑过渡,达到阈值的停顿应显式插入
REST。 - 句尾回落、过渡时长裁剪和时间区间校验是稳定播放不可缺少的边界规则。
下一课预告
下一阶段将继续完善面部驱动,把离散口型关键帧扩展为连续参数曲线,并进一步协调嘴角、下颌、面颊与表情通道。