
AI 内容创作 / 系统课时
模型加载与资源管理
模型加载与资源管理
本课解决数字人服务重复加载模型、显存长期占用和多模型切换失控的问题。你将实现一个线程安全的模型管理器,用预加载、延迟加载、引用计数和空闲回收统一管理模型生命周期,并通过可运行示例验证同一模型只加载一次。
学习目标
- 能够区分预加载与延迟加载,并为不同模型选择合适的加载时机。
- 能够使用引用计数保护正在推理的模型,避免误释放和重复加载。
- 能够设计空闲回收与多模型切换流程,降低显存泄漏和峰值占用风险。
生命周期与关键不变量
模型资源应按 模型版本 + 设备 + 精度 组成唯一键。预加载用于首包延迟敏感、命中率高的主模型;延迟加载用于低频角色或备用模型。无论采用哪种方式,都要保证同一个键在并发请求下只创建一个实例,并且只有引用计数归零后才允许进入回收候选集合。
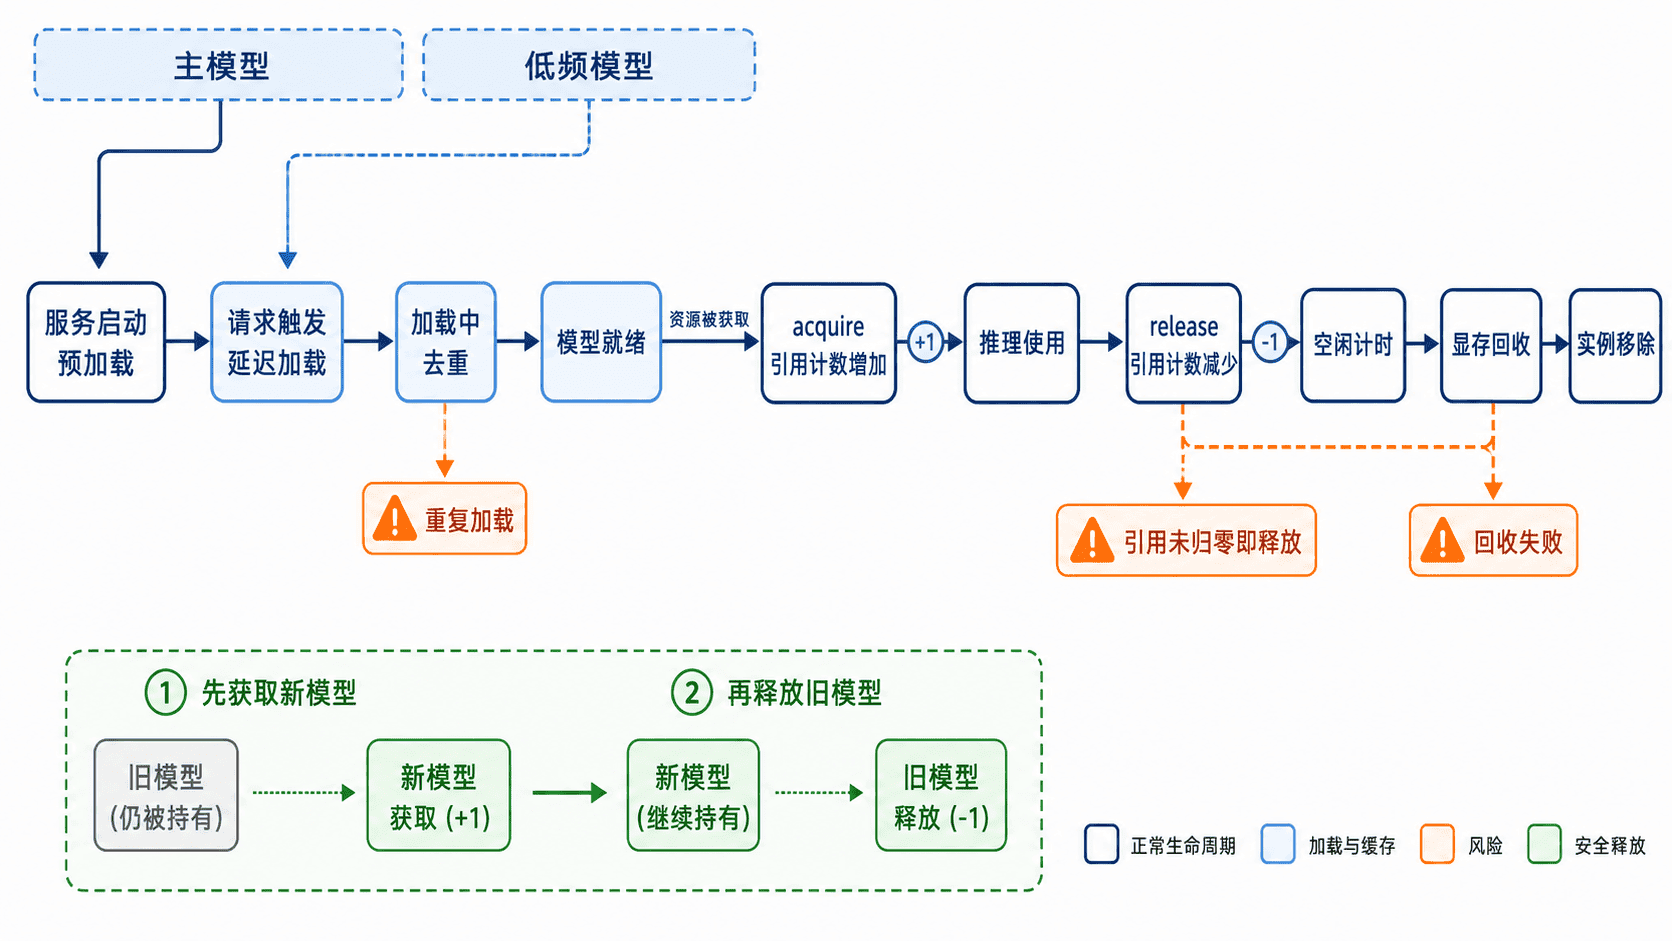
资源管理至少要维持三个不变量:refCount > 0 的模型不能回收;加载失败的实例不能写入可用缓存;回收时必须先阻止新引用,再执行模型关闭、对象引用移除和框架缓存整理。若直接调用显存清理函数而仍有张量或执行上下文持有引用,显存不会真正释放,还可能破坏正在运行的推理。
预加载、延迟加载与切换策略
| 策略 | 适用场景 | 优点 | 主要代价 |
|---|---|---|---|
| 预加载 | 默认角色、核心语音与渲染模型 | 首次请求延迟低 | 启动慢,常驻显存高 |
| 延迟加载 | 低频角色、备用语言模型 | 节省常驻资源 | 首次命中需要等待 |
| 空闲回收 | 模型数量多、流量波动明显 | 控制峰值与泄漏 | 需要准确的引用与计时 |
| 显式切换 | 会话中更换角色或模型版本 | 行为可控、便于审计 | 切换期间可能短暂双占用 |
安全切换的顺序是先获取目标模型,确认加载成功后再把会话指针切过去,最后释放旧模型。若先释放旧模型而新模型加载失败,会话将失去可用实例。若同时保留过多新旧模型,则应在调度层设置显存预算,在加载前评估预计占用并拒绝超过预算的切换。
线程安全模型池示例
以下 Python 3.11 示例使用标准库。池的键包含模型名、版本、设备和精度。单进程内用同一把锁保护加载、引用和回收。模型执行发生在锁外,提供器是否允许并发推理由它的契约决定。课堂只模拟模型,不调用 GPU。
from contextlib import contextmanager
from dataclasses import dataclass
from threading import Lock
from time import monotonic


@dataclass(frozen=True)
class Key:
    model: str
    version: str
    device: str
    dtype: str


@dataclass
class Entry:
    model: object
    idle_since: float
    refs: int = 0
    retiring: bool = False


class Pool:
    def __init__(self, clock=monotonic):
        self.entries = {}
        self.lock = Lock()
        self.clock = clock

    def _get(self, key, loader):
        if key not in self.entries:
            model = loader(key)
            self.entries[key] = Entry(model, self.clock())
        entry = self.entries[key]
        if entry.retiring:
            raise RuntimeError("model is retiring")
        return entry

    def preload(self, key, loader):
        with self.lock:
            self._get(key, loader)

    @contextmanager
    def lease(self, key, loader):
        with self.lock:
            entry = self._get(key, loader)
            entry.refs += 1
        try:
            yield entry.model
        finally:
            with self.lock:
                entry.refs -= 1
                if entry.refs == 0:
                    entry.idle_since = self.clock()

    def evict(self, minimum_idle):
        if minimum_idle < 0:
            raise ValueError("negative idle interval")
        removed = []
        with self.lock:
            now = self.clock()
            for key, entry in list(self.entries.items()):
                if entry.refs or now - entry.idle_since < minimum_idle:
                    continue
                entry.retiring = True
                entry.model.close()
                del self.entries[key]
                removed.append(key)
        return removed


class DemoModel:
    def __init__(self, key):
        self.key = key
        self.closed = False
        print("加载", key.model, key.version)

    def close(self):
        self.closed = True


if __name__ == "__main__":
    clock = [0.0]
    pool = Pool(lambda: clock[0])
    key = Key("avatar", "v1", "cpu", "float32")
    pool.preload(key, DemoModel)
    with pool.lease(key, DemoModel) as left, pool.lease(key, DemoModel) as right:
        print("共享实例:", left is right)
        print("在用回收:", pool.evict(0))
    clock[0] += 5
    print("空闲回收:", [item.model for item in pool.evict(5)])
保存为 model_manager_demo.py,运行 python model_manager_demo.py。
加载 avatar v1
共享实例: True
在用回收: []
空闲回收: ['avatar']
若加载抛错,池不登记实例。若关闭抛错,保留隔离状态,禁止新的租约。提供器要么支持安全重试关闭,要么由管理进程负责清理。示例的全局锁会让慢加载阻塞其他键。生产可用每键加载状态和设备预算,但仍须避免在旧实例关闭前同键另开实例。租约不能跨退出边界继续使用;提交到 GPU 的异步工作需要等到其实际完成或解除资源依赖后再归还租约。
工程化回收与故障处理
真实 GPU 模型的回收钩子应先停止新请求进入,再等待在途推理完成,随后关闭推理会话、释放模型对象和相关缓冲,最后才调用框架提供的缓存整理能力。缓存整理只能处理未被活跃对象引用的内存,不能替代引用计数,也不能作为每次请求结束后的固定操作,否则会增加同步和重新分配开销。
常见故障包括引用计数不平衡、加载异常后缓存脏条目、切换模型时显存瞬时翻倍,以及多个工作进程各自加载一份大模型。修复时应记录 modelKey、refCount、加载耗时、估算显存和最后使用时间;部署层还要明确模型是进程内共享、单机模型服务共享,还是由独立推理服务统一托管。
生产环境可把全局锁升级为“每个模型键一个加载状态”,让不同模型并行加载,同时让同一模型的请求等待同一个加载结果。回收线程应使用单调时钟判断空闲时间,并在删除前再次检查引用计数,避免扫描完成到执行回收之间出现竞态。
本课总结
- 预加载、延迟加载和空闲回收应由同一个模型管理器维护,不能分散在各业务接口中。
- 引用计数是保护在途推理的核心边界,只有归零后的模型才允许进入显存回收流程。
- 多模型切换必须先确认新模型可用,再释放旧模型,并结合显存预算控制短时双占用。
下一课预告
下一阶段将把会话接口与模型资源池接入容器化部署、并发限流、监控指标和压力测试流程,验证服务在多实例与高负载条件下的稳定性。