
AI 内容创作 / 系统课时
核心模块集成
核心模块集成
架构确定后,真正的难点是让不同速度、不同接口形态的模块稳定协作。本课用统一事件信封和异步编排器连接 ASR、对话模型、TTS、口型表情、动作控制与渲染模块,完成一条可运行、可追踪、可扩展的基础交互链路。
学习目标
- 为各模块设计统一输入输出和事件序列。
- 使用异步编排控制流式数据、背压、超时和取消。
- 通过可运行骨架验证从用户语音到渲染帧的完整链路。
统一事件与最小链路
集成时不要让模块直接依赖彼此的 SDK 类型。每个适配器只暴露项目内部接口,并把结果转换为统一事件。一次交互共享同一个 trace_id;序号只在同一流内递增,便于重放、排错和定位迟到结果。
最小链路可以按以下顺序工作:音频输入进入 ASR,最终文本交给对话模型;对话模型按短文本片段流式输出;每个片段交给 TTS;音频块同时驱动播放器和口型表情模块;驱动参数与动作控制结果送入渲染器。首版先保证链路正确,再加入并行预取与批量优化。
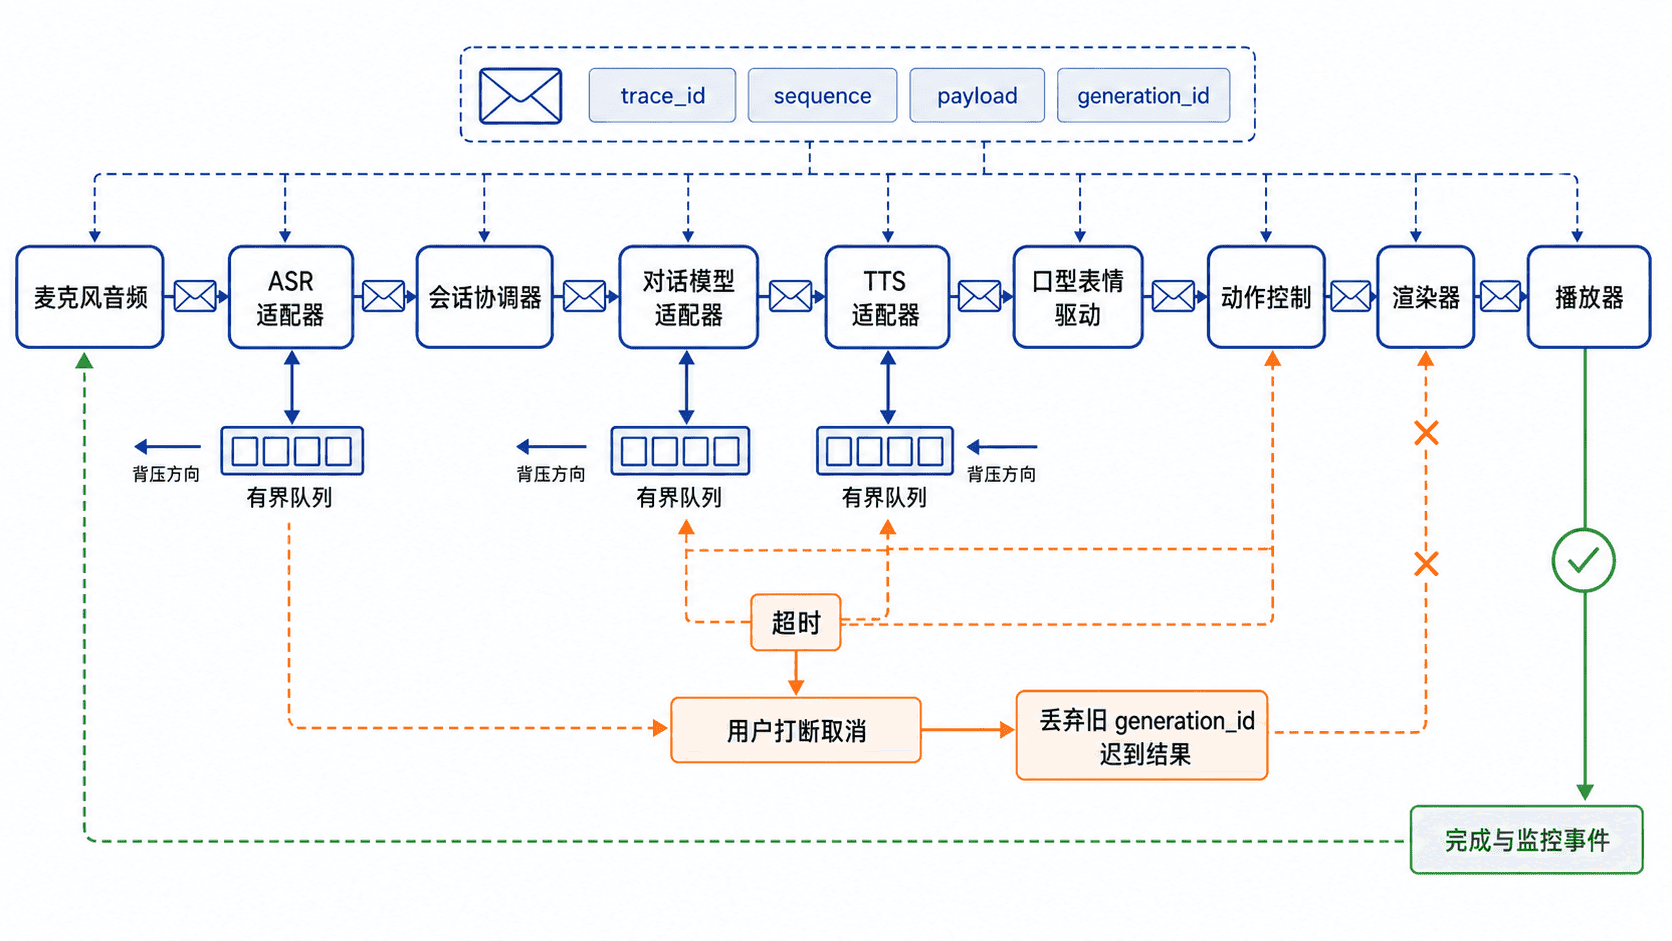
集成接口应区分最终结果和流式增量。例如 ASR 可以产生 asr.partial 与 asr.final,对话模块产生 dialog.delta,TTS 产生 tts.audio,驱动模块产生 driver.frame。协调器只根据事件类型推进状态,不解析供应商特有字段。
并发编排、取消与背压
流式模块速度不同,必须使用有界队列限制内存增长。TTS 若比渲染快,音频队列达到 maxsize 后应暂停上游写入;渲染若持续落后,则根据业务策略丢弃过期视频帧,而不是无限积压。队列容量要结合帧率、音频块时长和可接受等待时间计算。
用户打断时,协调器应生成新的 generation_id,立即停止播放器,取消旧对话与 TTS 任务,并拒绝旧任务迟到的数据。仅调用 cancel() 不够,消费端仍需检查代际标识,否则已经进入网络或线程池的结果可能继续写入当前会话。
每个外部调用都应设置超时并转换为项目内部错误事件。ASR 超时可以提示用户重试;对话模型超时可以返回简短降级文本;TTS 失败可以切换备用声音或只显示字幕。降级策略必须可观测,不能把失败伪装成正常完成。
可运行的集成骨架
下面的 Python 3.11 示例使用异步适配器模拟完整链路。模块是可替换的测试实现。示例用单个生成器按需拉取增量,TTS 和渲染串行处理,不包含独立队列或真实 PCM。生产事件还要包含上一课的流 ID、时间戳和生成代际。
import asyncio
from contextlib import aclosing
from dataclasses import dataclass
from typing import AsyncIterator

@dataclass(frozen=True)
class Event:
    event_type: str
    trace_id: str
    sequence: int
    payload: str

class Sequence:
    def __init__(self) -> None:
        self.value = 0

    def next(self) -> int:
        self.value += 1
        return self.value

# 适配器隐藏外部服务差异,协调器只依赖项目内部方法。
class MockAsr:
    async def transcribe(self, audio: bytes) -> str:
        await asyncio.sleep(0.01)
        return "你好,请介绍课程。"

class MockDialog:
    async def stream_reply(self, text: str) -> AsyncIterator[str]:
        for part in ("这是一门", "AI 数字人开发教程。"):
            await asyncio.sleep(0.01)
            yield part

class MockTts:
    async def synthesize(self, text: str, index: int) -> str:
        await asyncio.sleep(0.01)
        return f"audio-{index}"

class MockDriver:
    def build_frame(self, audio_chunk: str, index: int) -> tuple[str, float, str]:
        # 两个固定口型值让示例输出可重复验证。
        mouth = 0.45 if index == 1 else 0.65
        gesture = "explain"
        return f"frame-{index}", mouth, gesture

class MockRenderer:
    async def render(self, frame_id: str) -> str:
        await asyncio.sleep(0.01)
        return frame_id

async def emit(event: Event) -> None:
    print(
        f"[{event.trace_id}] {event.event_type} "
        f"seq={event.sequence} {event.payload}"
    )

async def run_session(timeout_seconds: float = 2.0) -> None:
    async with asyncio.timeout(timeout_seconds):
        await emit_turn()

async def emit_turn() -> None:
    trace_id = "trace-001"
    sequence = Sequence()
    asr = MockAsr()
    dialog = MockDialog()
    tts = MockTts()
    driver = MockDriver()
    renderer = MockRenderer()

    # ASR 最终文本是对话流的唯一入口,事件序号从此递增。
    text = await asr.transcribe(b"pcm-audio")
    await emit(Event("asr.final", trace_id, sequence.next(), f"text={text}"))

    index = 0
    async with aclosing(dialog.stream_reply(text)) as deltas:
        async for delta in deltas:
            index += 1
            await emit(
                Event("dialog.delta", trace_id, sequence.next(), f"text={delta}")
            )

            audio_chunk = await tts.synthesize(delta, index)
            await emit(
                Event(
                    "tts.audio",
                    trace_id,
                    sequence.next(),
                    f"chunk={audio_chunk}",
                )
            )

            # 音频块在同一轮处理中生成驱动参数并交给渲染器。
            frame_id, mouth, gesture = driver.build_frame(audio_chunk, index)
            rendered = await renderer.render(frame_id)
            await emit(
                Event(
                    "render.frame",
                    trace_id,
                    sequence.next(),
                    f"frame={rendered} mouth={mouth:.2f} gesture={gesture}",
                )
            )

    await emit(Event("session.done", trace_id, sequence.next(), "status=ok"))

if __name__ == "__main__":
    asyncio.run(run_session())
将代码保存为 integration_demo.py,然后运行:
python integration_demo.py预期输出
[trace-001] asr.final seq=1 text=你好,请介绍课程。
[trace-001] dialog.delta seq=2 text=这是一门
[trace-001] tts.audio seq=3 chunk=audio-1
[trace-001] render.frame seq=4 frame=frame-1 mouth=0.45 gesture=explain
[trace-001] dialog.delta seq=5 text=AI 数字人开发教程。
[trace-001] tts.audio seq=6 chunk=audio-2
[trace-001] render.frame seq=7 frame=frame-2 mouth=0.65 gesture=explain
[trace-001] session.done seq=8 status=ok
该输出证明事件序号连续、同一 trace_id 贯穿全链路,并且每个固定文本片段都产生对应的模拟音频与渲染帧。超时或取消时,生成器退出并释放资源,调用方收到异常,示例不会输出 session.done。实际 TTS 应合并过细 token 至可朗读边界,再按音频 PTS 输出媒体。接入真实服务后,应在适配器层加入超时、重试、指标和数据格式转换,同时保持协调器接口不变。
本课总结
- 通过适配器和统一事件信封隔离供应商 SDK,可以降低核心流程的耦合度。
- 有界队列、代际标识、超时和取消共同保证流式链路在慢模块与用户打断下仍可控。
- 最小可运行链路应先验证事件顺序和模块边界,再逐步加入并行、缓存与性能优化。
下一课预告
下一阶段将围绕综合项目的运行验收与故障排查展开,重点检查延迟、资源占用、事件乱序、音画不同步以及单模块失败后的恢复路径。