
AI 内容创作 / 系统课时
音色复刻与样本准备
音色复刻与样本准备
本课建立一条可审计的音色复刻准备链路:先确认授权范围,再检查录音质量、裁剪静音、统一响度和格式,再说明说话人特征和复刻质量如何另行验证。你还将完成一个可运行的离线样本处理与相似度基线程序。
学习目标
- 制定参考音频的授权、录制和质量检查标准。
- 用合成样本验证静音裁剪、峰值调整和频谱比较。
- 正确解释相似度分数,并建立人工复核和发布门禁。
合规边界与样本标准
音色复刻必须以明确授权为前提。授权记录应说明声音主体、允许用途、使用期限、可发布渠道、是否允许再训练以及撤回方式,并在每次任务中保存可追踪的 consent_id。不得用公开音频推定授权,也不得将样本用于授权范围之外的身份冒充或欺骗场景。
| 检查维度 | 合格基线 | 不合格表现 |
|---|---|---|
| 文件格式 | 无损单声道 PCM WAV,并符合模型采样率要求 | 有损转码、多声道混合、采样率未知 |
| 录音环境 | 背景稳定、无音乐、无其他说话人 | 空调突变、键盘声、重叠人声 |
| 电平质量 | 无削波,信噪比稳定,距离和增益一致 | 波形顶端被截平、忽大忽小 |
| 内容覆盖 | 发音、数字、停顿和语气具有代表性 | 只有单一短句或大量重复内容 |
| 权利记录 | 授权范围、期限和撤回机制可查询 | 缺少可核验记录,或无法关联到样本 |
不同模型对采样率、最短片段和参考时长的要求并不相同,应以所选模型文档为准。工程上更重要的是保持一致:同一批样本不要混用麦克风、房间、降噪算法或响度标准,否则模型可能把环境差异当作说话人特征。
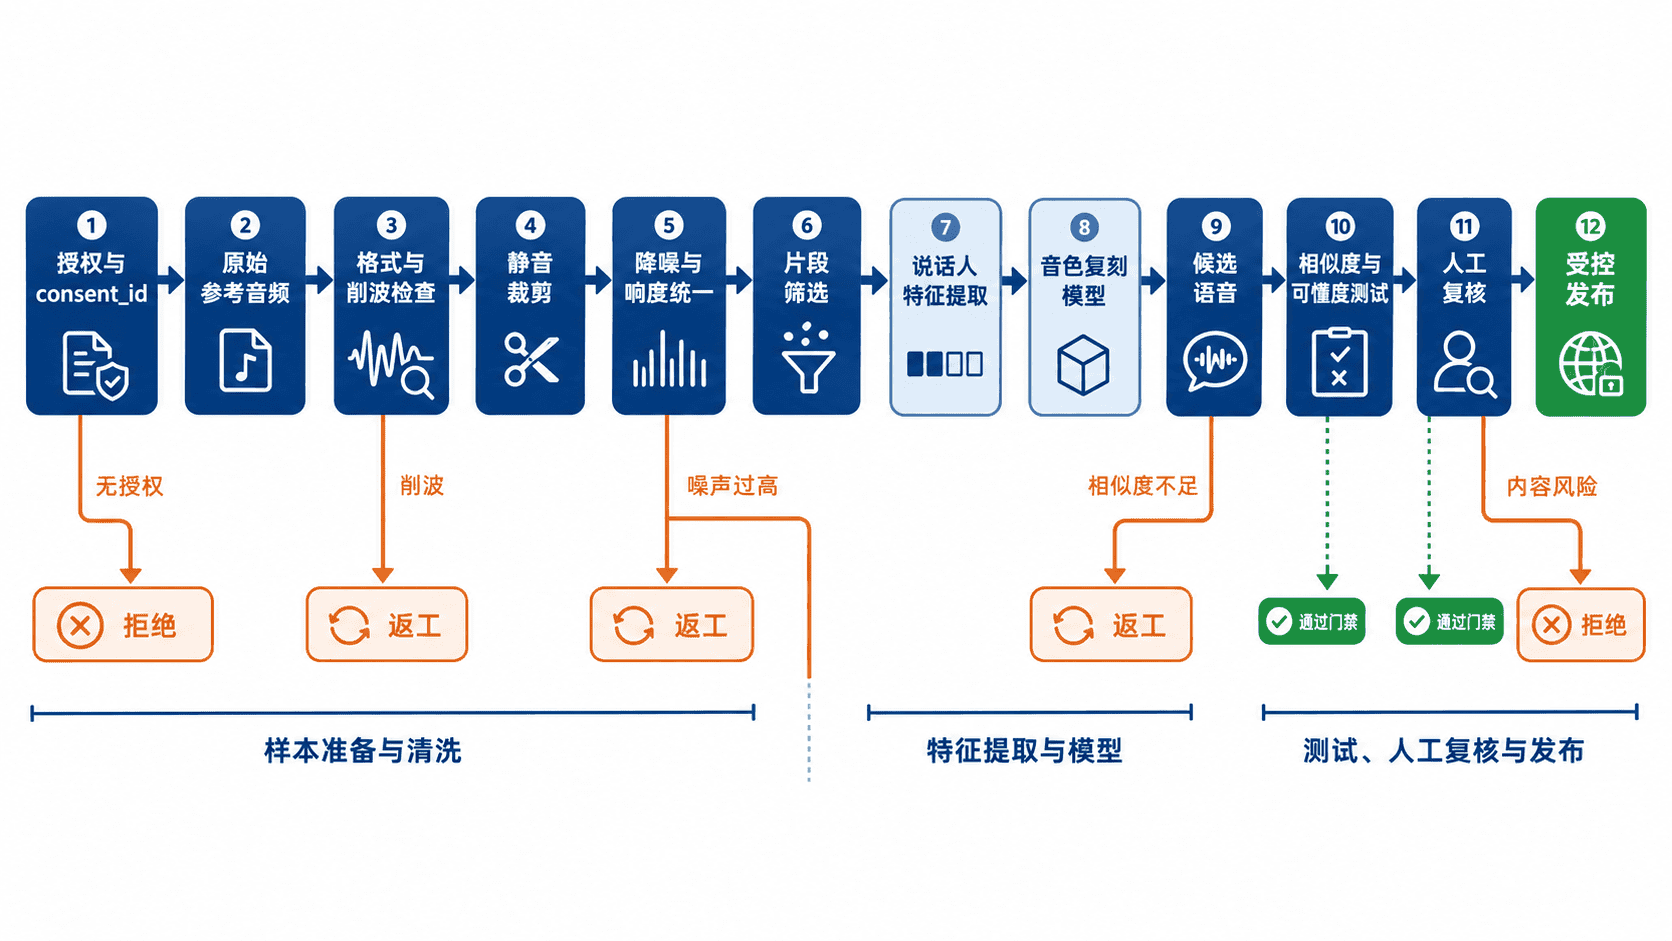
处理流程与接口约定
样本准备通常按固定顺序执行:验证授权和文件元数据,检测削波与长静音,按语音活动切分短片段,执行轻量去噪和响度统一,再提取说话人向量。顺序不能随意调换,例如先强降噪再做质量判断,可能掩盖原始录音缺陷并引入金属音。
复刻接口携带可追溯的授权标识、参考样本引用、目标文本、语言和输出格式。知道授权编号不等于获得权限。处理前由服务端核对调用者、样本指纹、用途、渠道、有效期和撤销状态。下面是一个数据结构示例;它表示接口契约,不绑定具体服务。
{
  "consentId": "consent-demo-001",
  "referenceAudio": "reference_prepared.wav",
  "targetText": "欢迎使用数字人系统。",
  "language": "zh-CN",
  "outputFormat": "wav"
}
返回结果除音频外,还应记录模型版本、参考样本摘要、生成参数、质量分数和审计标识。原始样本、特征向量和生成音频要设置不同的访问权限与保留期限,撤回授权后应能定位并停止后续生成。
完整可运行示例
以下代码使用 Python 3.11 和 NumPy 1.26.4。它生成三个无真人数据的音频夹具,模拟校验授权、裁剪首尾及控制样本峰值,然后比较频谱形状。没有执行音色复刻,也没有计算说话人嵌入。
from dataclasses import dataclass, replace
from hashlib import sha256
from pathlib import Path
from tempfile import mkdtemp
import wave

import numpy as np

RATE = 16000


@dataclass(frozen=True)
class Grant:
    actor: str
    digest: str
    purpose: str
    channel: str
    expires_at: int
    revoked: bool = False


def permitted(grant, actor, payload, purpose, channel, now):
    return (
        not grant.revoked and now < grant.expires_at
        and (actor, sha256(payload).hexdigest(), purpose, channel)
        == (grant.actor, grant.digest, grant.purpose, grant.channel)
    )


def create_tone(frequency, gain):
    t = np.arange(RATE) / RATE
    wave_data = gain * np.sin(2 * np.pi * frequency * t)
    return np.pad(wave_data, RATE // 4)


def prepare(samples):
    if samples.ndim != 1 or not samples.size or not np.isfinite(samples).all():
        raise ValueError("invalid mono waveform")
    if np.max(np.abs(samples)) >= .999:
        raise ValueError("possible clipping")
    signal = np.flatnonzero(np.abs(samples) >= .02)
    if not signal.size:
        raise ValueError("no signal above test threshold")
    start, end = int(signal[0]), int(signal[-1]) + 1
    trimmed = samples[start:end]
    if len(trimmed) < RATE // 2:
        raise ValueError("too short")
    return trimmed * (.9 / np.max(np.abs(trimmed))), (start, end)


def spectrum(samples):
    power = np.abs(np.fft.rfft(samples * np.hanning(len(samples)))) ** 2
    frequency = np.fft.rfftfreq(len(samples), 1 / RATE)
    edges = (80, 180, 300, 500, 800, 1200, 4000)
    vector = np.array([
        power[(frequency >= lo) & (frequency < hi)].sum()
        for lo, hi in zip(edges[:-1], edges[1:])
    ])
    norm = np.linalg.norm(vector)
    if not norm or not np.isfinite(norm):
        raise ValueError("no usable spectral energy")
    return vector / norm


def write_pcm(path, samples):
    pcm = np.clip(np.rint(samples * 32768), -32768, 32767).astype("<i2")
    with wave.open(str(path), "wb") as file:
        file.setparams((1, 2, RATE, 0, "NONE", "not compressed"))
        file.writeframes(pcm.tobytes())


if __name__ == "__main__":
    folder = Path(mkdtemp(prefix="voice-fixture-", dir="."))
    path = folder / "reference.wav"
    raw = create_tone(220, .55)
    write_pcm(path, raw)
    payload = path.read_bytes()
    grant = Grant("tester", sha256(payload).hexdigest(), "qa", "local", 100)
    print("授权夹具:", permitted(grant, "tester", payload, "qa", "local", 10))
    print("撤销后:", permitted(replace(grant, revoked=True), "tester", payload, "qa", "local", 10))
    if not permitted(grant, "tester", payload, "qa", "local", 10):
        raise PermissionError("not allowed")
    with wave.open(str(path), "rb") as file:
        recorded = np.frombuffer(file.readframes(file.getnframes()), dtype="<i2").astype(float) / 32768
    reference, span = prepare(recorded)
    same, _ = prepare(create_tone(220, .35))
    different, _ = prepare(create_tone(700, .55))
    write_pcm(folder / "prepared.wav", reference)
    print(f"处理后时长={len(reference) / RATE:.3f}s, 样本峰值={np.max(np.abs(reference)):.3f}")
    print(f"同频测试音的频谱相似度={np.dot(spectrum(reference), spectrum(same)):.3f}")
    print(f"异频测试音的频谱相似度={np.dot(spectrum(reference), spectrum(different)):.3f}")
保存为 voice_sample_pipeline.py。运行 python -m pip install numpy==1.26.4,再运行 python voice_sample_pipeline.py。
授权夹具: True
撤销后: False
处理后时长=1.000s, 样本峰值=0.900
同频测试音的频谱相似度=1.000
异频测试音的频谱相似度=0.000
样本峰值调整不等同于感知响度归一化。示例只用幅度阈值定位合成信号;真人录音须用语音活动检测和首尾留量,并核对弱辅音、噪声及重叠人声。频带余弦相似度会受基频、房间和录音条件影响,不能作为说话人验证或发布门槛。真实评估使用适配任务的说话人模型、独立参考集和盲听,同时分别核验文本、自然度与韵律。撤销后停止新的生成,并按预先约定处理样本、缓存、派生特征和已有制品。