
AI 内容创作 / 系统课时
并发控制与任务调度
并发控制与任务调度
数字人服务同时处理语音识别、对话生成、语音合成和逐帧渲染时,单纯增加线程会放大显存争用、会话串扰和超时堆积。本课建立一套可落地的调度模型:同一会话串行、不同会话并行、全局容量受控,并让高优先级、取消和超时都能被正确处理。
学习目标
- 设计会话隔离、全局并发上限和有界任务队列。
- 使用优先级、超时与取消机制避免长任务拖垮服务。
- 通过可运行示例验证调度结果,并识别上线时的关键风险。
调度模型与关键边界
并发控制应分成接入、排队和执行三层。接入层限制队列长度并决定拒绝、降级或转异步;排队层按照优先级、入队顺序和截止时间选择任务;执行层同时保护会话状态与 GPU、编码器等稀缺资源。只限制 worker 数量,无法阻止同一会话的两个任务并发修改播放器、缓冲区或 generation_id。
| 控制层 | 保护对象 | 推荐机制 | 主要失败信号 |
|---|---|---|---|
| 接入层 | 服务总容量 | 有界队列、速率限制、租户配额 | 队列满、拒绝率升高 |
| 会话层 | 单个会话状态 | session_id 对应的锁或串行队列 |
状态覆盖、旧结果回写 |
| 资源层 | GPU、编码器、模型实例 | 信号量或资源池 | 显存不足、延迟突增 |
| 时限层 | 任务生命周期 | 截止时间、取消令牌、幂等键 | 超时、僵尸任务、重复结果 |
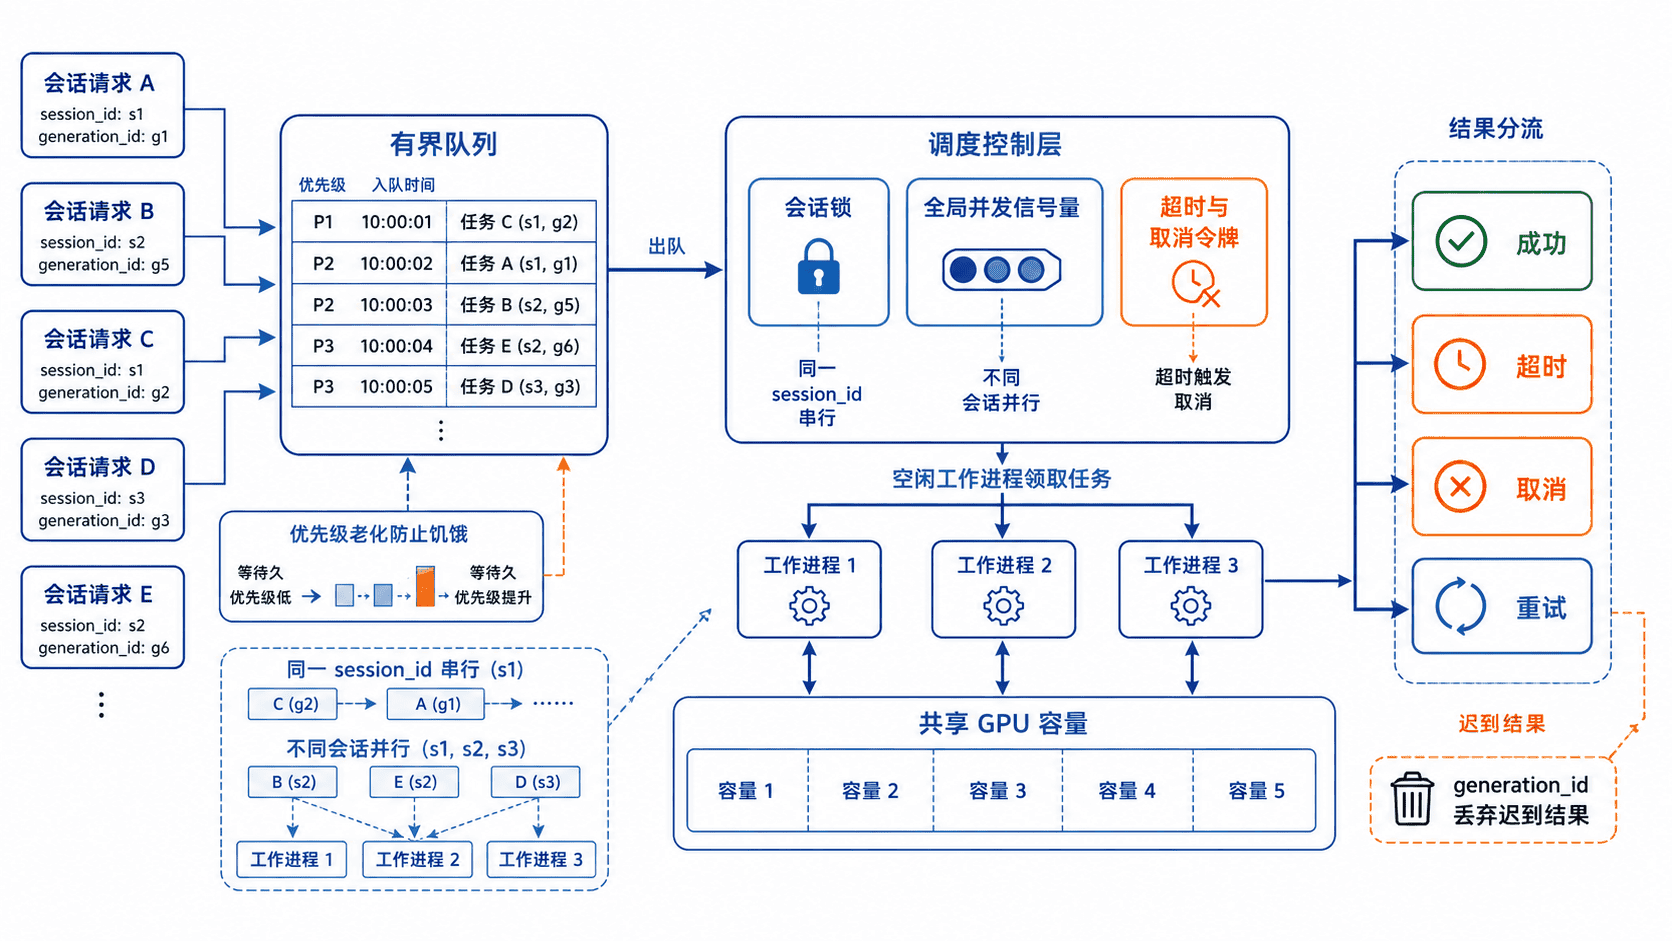
优先队列通常使用“优先级 + 递增序号”作为排序键,既保证高优先级先执行,又让同级任务保持先进先出。持续到来的高优先级任务可能造成饥饿,因此生产系统应加入等待时间加权、租户配额或加权公平队列。已经开始执行的任务不会被普通优先队列自动抢占,真正的抢占还需要下游推理、TTS 和渲染链路配合取消。
全局并发上限应通过压测确定,而不是直接等于 CPU 核数。GPU 场景可先用 floor((可用显存 - 常驻显存) / 单任务峰值显存) 估算,再根据显存碎片、批处理和延迟目标下调。内存队列仅适合单进程示例;多实例部署还需要外部消息系统、任务租约和故障后的重新投递。
完整可运行示例
本例用 Python 3.11 和单事件循环。调度器只从有空闲会话的任务中按优先级与顺序选择,避免同会话锁住多个工作器。队列有上限,时限从接收请求开始。取消使用显式任务 ID。
import asyncio
import itertools
import math
from dataclasses import dataclass


@dataclass
class Job:
    id: str
    session: str
    priority: int
    order: int
    deadline: float
    work: object
    result: asyncio.Future


class Scheduler:
    def __init__(self, slots=2, waiting_limit=8):
        if type(slots) is not int or type(waiting_limit) is not int or min(slots, waiting_limit) <= 0:
            raise ValueError("positive scheduler bounds required")
        self.slots, self.waiting_limit = slots, waiting_limit
        self.waiting, self.active = [], {}
        self.order = itertools.count()
        self.wake = asyncio.Event()
        self.accepting = True
        self.running = False

    def submit(self, ident, session, priority, ttl, work):
        if not self.accepting or len(self.waiting) >= self.waiting_limit:
            raise RuntimeError("not accepting or queue full")
        if not math.isfinite(ttl) or ttl <= 0:
            raise ValueError("positive deadline required")
        if any(job.id == ident for job in self.waiting) or any(job.id == ident for job, _ in self.active.values()):
            raise ValueError("duplicate job in progress")
        loop = asyncio.get_running_loop()
        result = loop.create_future()
        self.waiting.append(Job(ident, session, priority, next(self.order), loop.time() + ttl, work, result))
        result.add_done_callback(lambda _: self.wake.set())
        self.wake.set()
        return result

    def cancel(self, ident):
        for job in self.waiting:
            if job.id == ident:
                self.waiting.remove(job)
                if not job.result.done():
                    job.result.set_result("cancelled")
                self.wake.set()
                return
        for job, task in self.active.values():
            if job.id == ident:
                task.cancel()
                return

    def close(self):
        self.accepting = False
        self.wake.set()

    def completed(self, job, task):
        del self.active[job.session]
        result = "cancelled" if task.cancelled() else task.result()
        if not job.result.done():
            job.result.set_result(result)
        self.wake.set()

    async def execute(self, job):
        try:
            async with asyncio.timeout_at(job.deadline):
                return await job.work()
        except TimeoutError:
            return "timed_out"
        except Exception:
            return "failed"

    async def run(self):
        if self.running:
            raise RuntimeError("scheduler already running")
        self.running = True
        try:
            await self.dispatch()
        finally:
            self.accepting = False
            for job in self.waiting:
                if not job.result.done():
                    job.result.set_result("cancelled")
            self.waiting.clear()
            tasks = [task for _, task in self.active.values()]
            for task in tasks:
                task.cancel()
            await asyncio.gather(*tasks, return_exceptions=True)
            self.running = False

    async def dispatch(self):
        loop = asyncio.get_running_loop()
        while True:
            self.wake.clear()
            for job in list(self.waiting):
                if job.result.done() or loop.time() >= job.deadline:
                    self.waiting.remove(job)
                    if not job.result.done():
                        job.result.set_result("timed_out")
            while len(self.active) < self.slots:
                candidates = [job for job in self.waiting if job.session not in self.active]
                if not candidates:
                    break
                job = min(candidates, key=lambda item: (item.priority, item.order))
                self.waiting.remove(job)
                task = asyncio.create_task(self.execute(job))
                self.active[job.session] = (job, task)
                task.add_done_callback(lambda finished, job=job: self.completed(job, finished))
            if not self.accepting and not self.waiting and not self.active:
                return
            until = min((job.deadline for job in self.waiting), default=None)
            try:
                async with asyncio.timeout_at(until):
                    await self.wake.wait()
            except TimeoutError:
                pass


async def main():
    scheduler = Scheduler()
    release = asyncio.Event()

    async def held():
        await release.wait()
        return "first finished"

    async def quick():
        return "second session finished"

    first = scheduler.submit("a1", "a", 0, 2, held)
    expires = scheduler.submit("a2", "a", 1, .05, quick)
    other = scheduler.submit("b1", "b", 2, 2, quick)
    runner = asyncio.create_task(scheduler.run())
    print(await other)
    print(await expires)
    release.set()
    print(await first)
    scheduler.close()
    await runner


if __name__ == "__main__":
    asyncio.run(main())
保存为 digital_human_scheduler.py,运行 python digital_human_scheduler.py。
second session finished
timed_out
first finished
示例表明会话 A 排队的短期限任务不会阻塞会话 B。生产中调用方断开时应明确派发取消。已开始的 GPU 计算和外部业务操作可能无法立即撤销,需要向下传播取消、保持资源租约并隔离旧生成代次。真实运行还要加入租户配额、优先级饥饿治理和持久幂等记录。
上线检查与常见错误
上线前至少验证队列长度、活跃任务数、排队时长、执行时长、超时率、取消率和各 worker 负载。会话锁字典必须在会话结束后清理,否则长期运行会积累无用对象。任务失败后的重试应携带幂等键,并区分可重试错误、业务拒绝和用户主动取消,避免重复生成或重复计费。
- 只设全局并发,不做会话隔离:同一会话可能同时修改状态,修复方式是会话级锁、Actor 或单会话队列。
- 只在 API 层返回超时:后台协程仍继续消耗 GPU,修复方式是传播取消并在
finally中释放资源。 - 固定高优先级永久优先:普通任务可能长期得不到执行,修复方式是优先级老化、配额或加权公平调度。
- 无界队列吸收所有请求:服务看似不拒绝,实际延迟持续增长,修复方式是设置容量、截止时间和明确的过载策略。
本课总结
- 稳定调度需要同时控制接入容量、会话串行性和全局稀缺资源。
- 优先级只决定待执行任务的顺序,取消传播和迟到结果过滤才能完成真正的中断。
- 超时、重试和负载分配必须与指标、幂等性及资源清理一起设计。
下一课预告
下一课将学习“监控、隐私与安全合规”,把队列、延迟和错误转化为可观测指标,同时为声音、肖像、日志和生成内容建立授权、脱敏与审计闭环。