
AI 内容创作 / 系统课时
音素与视素映射
音素与视素映射
语音驱动口型的第一步不是直接让汉字对应嘴形,而是把文本或语音拆成带时间信息的发音单位,再归并为少量可复用的视素。本课将建立从拼音、音素到嘴部参数的映射模型,并用可运行代码验证基础规则。
学习目标
- 区分汉字、拼音音节、音素与视素在口型系统中的职责。
- 设计覆盖闭口、圆唇、展唇和开口状态的最小视素集合。
- 使用 Python 将音素片段转换为稳定的视素时间序列。
音素到视素的映射链路
汉字表达语义,拼音记录普通话音节,可分声母、韵母和声调;音素是更细的发音单位,单个韵母可包含多个音素,视素则只保留摄像机能够观察到的嘴部外观。它们不是一一对应关系:多个音素可能共享同一嘴形,同一音素也会因前后发音而产生不同过渡。
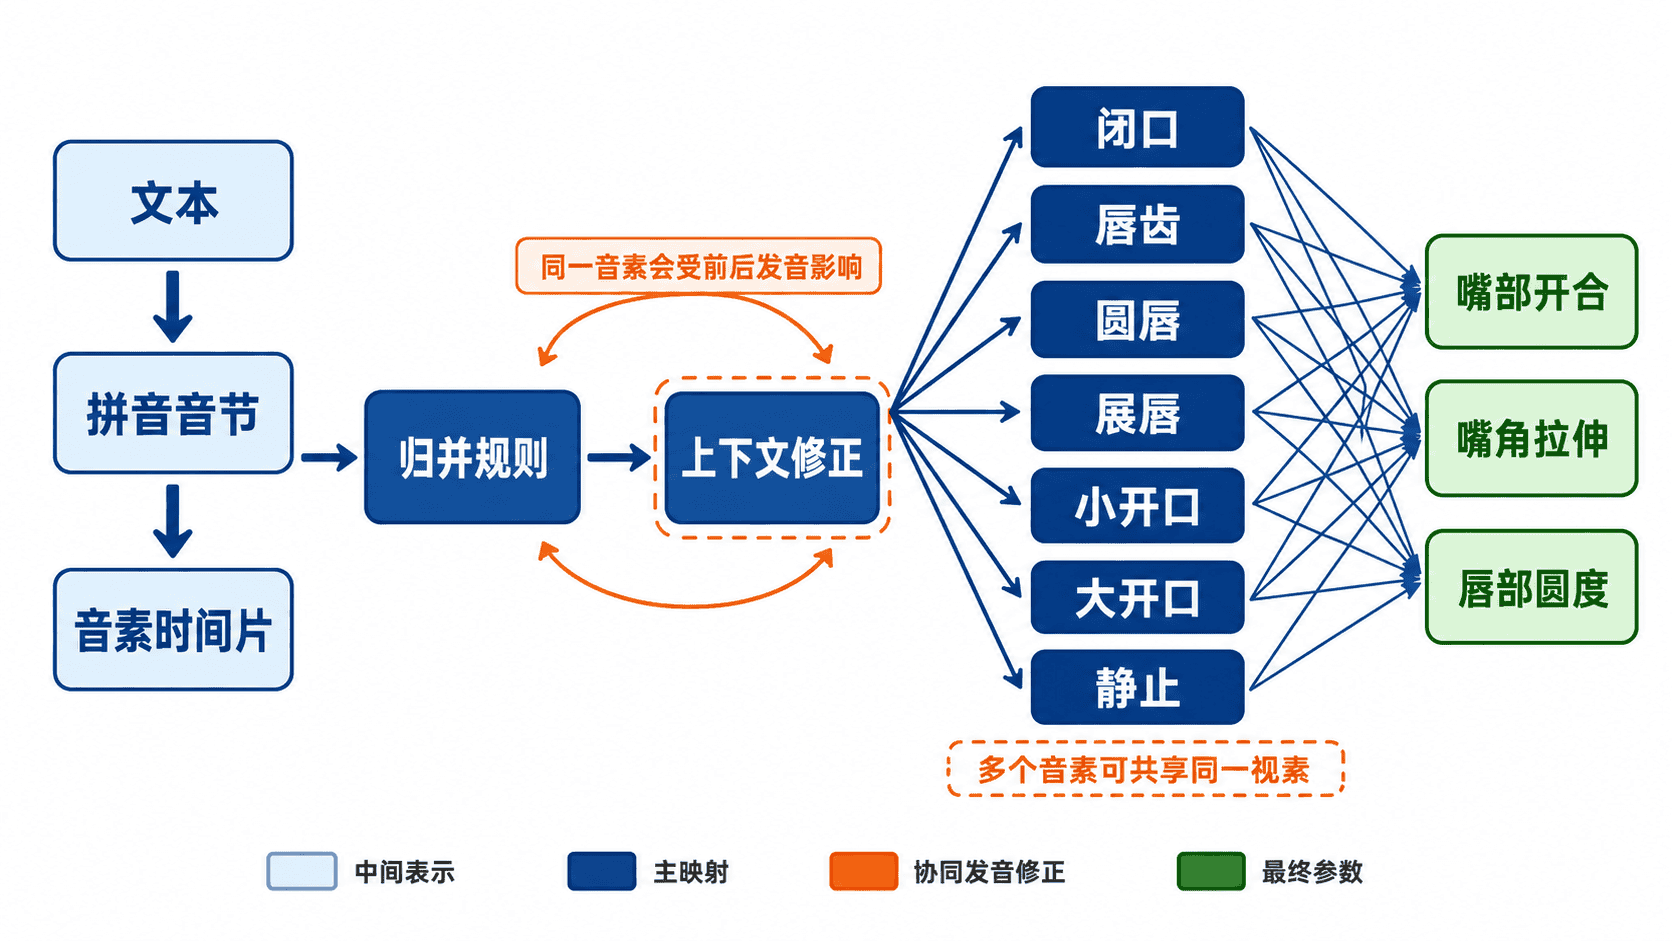
工程中通常不会为每个音素制作独立口型,因为可见差异远少于发音差异。可先定义一个小而稳定的视素集合,再根据角色资产增加舌位、下唇内收或牙齿可见度等细节通道。
| 视素 | 典型发音线索 | 主要外观 | 建议参数 |
|---|---|---|---|
REST |
静音、停顿 | 嘴部自然闭合或微开 | open = 0.0 |
CLOSED |
b、p、m |
双唇闭合 | open = 0.0,press = 1.0 |
LABIODENTAL |
f |
下唇接近上齿 | open = 0.2,lowerLipIn = 0.8 |
ROUNDED |
u、o、ü |
嘴唇前突并收圆 | round = 1.0 |
WIDE |
如“米”中单元音 i | 嘴角横向拉伸 | wide = 1.0 |
OPEN_SMALL |
e、弱读韵母 |
小幅张口 | open = 0.4 |
OPEN_LARGE |
a |
明显张口 | open = 0.9 |
映射规则与可运行示例
映射输入最好来自 TTS 或强制对齐模块输出的音素时间片,而不是直接遍历汉字。下面的程序使用教学标签表,不直接接收带声调的拼音音节或任意模型符号。真实接入先明确供应商符号集、静音标记、时基及偏移;同样写作拼音 i,在“米”和“知”中并不表示相同发音。规则只承担基础归类,真正播放时还需要下一课的时间戳、插值和闭口处理。
python
from dataclasses import dataclass

@dataclass(frozen=True)
class Segment:
    symbol: str
    duration_ms: int

DIRECT_RULES = {
    "b": "CLOSED",
    "p": "CLOSED",
    "m": "CLOSED",
    "f": "LABIODENTAL",
    "u": "ROUNDED",
    "o": "ROUNDED",
    "ü": "ROUNDED",
    "i": "WIDE",
    "a": "OPEN_LARGE",
    "e": "OPEN_SMALL",
    "rest": "REST",
}

def to_viseme(symbol: str) -> str:
    normalized = symbol.strip().lower()
    if normalized in DIRECT_RULES:
        return DIRECT_RULES[normalized]
    coarse_finals = {"ai": "OPEN_LARGE", "ao": "OPEN_LARGE", "ou": "ROUNDED"}
    if normalized in coarse_finals:
        return coarse_finals[normalized]
    raise ValueError(f"未知发音标签: {symbol!r}")

def build_timeline(segments: list[Segment]) -> list[tuple[int, int, str, str]]:
    timeline = []
    cursor_ms = 0
    for segment in segments:
        if type(segment.duration_ms) is not int or segment.duration_ms <= 0:
            raise ValueError("片段时长必须是正整数毫秒")
        end_ms = cursor_ms + segment.duration_ms
        timeline.append(
            (cursor_ms, end_ms, segment.symbol, to_viseme(segment.symbol))
        )
        cursor_ms = end_ms
    return timeline

def main() -> None:
    segments = [
        Segment("m", 80),
        Segment("a", 180),
        Segment("REST", 80),
        Segment("f", 90),
        Segment("u", 160),
    ]
    for start_ms, end_ms, symbol, viseme in build_timeline(segments):
        print(f"{start_ms:04d}-{end_ms:04d} ms {symbol:>4} -> {viseme}")

if __name__ == "__main__":
    main()
将代码保存为 phoneme_viseme_mapping.py,然后运行:
bash
python phoneme_viseme_mapping.py预期输出:
text
0000-0080 ms    m -> CLOSED
0080-0260 ms    a -> OPEN_LARGE
0260-0340 ms REST -> REST
0340-0430 ms    f -> LABIODENTAL
0430-0590 ms    u -> ROUNDED
调试与边界
映射表应与角色资产的实际通道保持一致。角色只有开合与圆度两个参数时,不应输出无法消费的舌位视素;角色支持混合形状时,则可把一个视素展开为多个权重,而不是改动上游音素标签。
- 不要把拼音字母逐字符映射。
zh、ch、sh和复合韵母必须按完整发音单位处理。 - 此处用正整数时长连续拼接;实际对齐结果有绝对起止时应保留它们,并单独处理间隙。ai、ao 等复合韵母的粗分类只生成一个目标,近景高精度动画可按元音转折拆成多个目标。
- 不要忽略静音。句首、句尾和较长停顿需要显式输出
REST,否则角色会长时间保持上一口型。 - 不要追求过多类别。视素数量增加后,资产制作、标注和调参成本都会上升,但可见收益未必同步增加。
- 不要把映射结果当作最终动画。协同发音会让相邻口型提前或延后,必须结合时间戳进行平滑过渡。
本课总结
- 音素描述发音单位,视素描述可见嘴形,二者通常是多对一映射。
- 最小视素集合应优先覆盖闭口、唇齿、圆唇、展唇、开口与静止状态。
- 基础映射只决定目标嘴形,最终动画还需要时间轴、过渡和闭口规则。
下一课预告
下一课将学习“基于时间戳的口型驱动”,把本课得到的视素片段转换为可播放的关键帧,并处理连续发音、停顿区间与过渡时长。
按自己的节奏,确认真正理解。