
AI 内容创作 / 系统课时
面部表情参数控制
面部表情参数控制
本课建立一套可计算、可限幅、可混合的面部参数体系,把眨眼、注视、眉毛、微笑和嘴部肌肉统一到逐帧控制流程中。你将学会分层合并情绪、行为和语音驱动,并通过优先级、冲突消解与时间平滑获得稳定自然的表情输出。
学习目标
- 能够定义面部参数的名称、范围、默认值和坐标方向。
- 能够按情绪层、行为层和语音层混合参数,并处理互斥动作。
- 能够使用限幅、视线归一化和时间平滑验证输出稳定性。
参数体系与混合规则
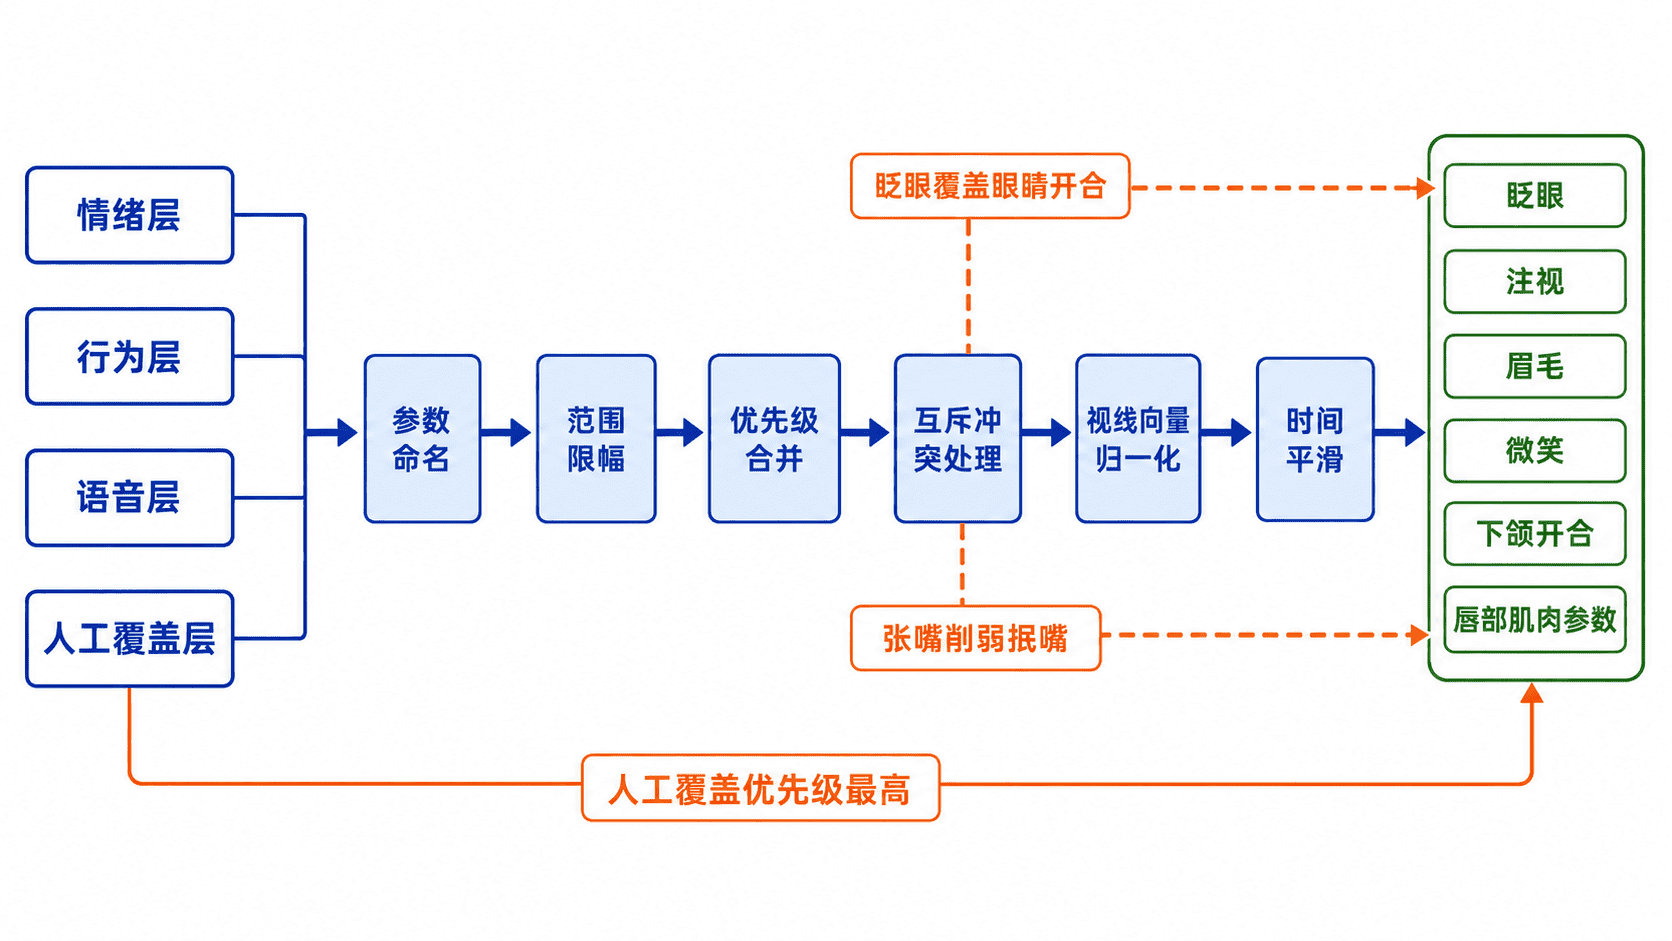
参数控制首先要统一语义。连续参数通常归一化到 0.0 至 1.0,双向参数如水平视线使用 -1.0 至 1.0。左右眼应保留独立通道,以支持单眼眨动和不对称表情;模型、动画资产和渲染器必须对坐标方向达成一致,否则正值向左还是向右会在接入时产生反转。
| 参数 | 推荐范围 | 主要来源 | 冲突规则 |
|---|---|---|---|
eye_open_left、eye_open_right |
0.0~1.0 | 眨眼与行为层 | 眨眼对眼睛开合拥有高优先级 |
gaze_x、gaze_y |
-1.0~1.0 | 注视目标 | 二维向量长度不超过 1 |
brow_raise、smile |
0.0~1.0 | 情绪层 | 与局部人工覆盖按优先级合并 |
jaw_open |
0.0~1.0 | 语音或口型层 | 张嘴时降低抿嘴强度 |
lip_press |
0.0~1.0 | 情绪与肌肉层 | 与大幅张嘴互斥 |
推荐把驱动来源拆成层,而不是让所有模块直接写最终骨骼。基础层提供中性姿态,情绪层控制较慢的眉毛和微笑,行为层控制眨眼与视线,语音层控制下颌和嘴唇,人工覆盖层用于导演或调试。合并时先应用低优先级层,再让高优先级层覆盖指定通道,最后统一执行限幅和冲突处理。
简单相加会让参数越界,平均值又可能削弱关键动作。例如眨眼时,眼睛开合必须接近 0,而不能与“保持睁眼”平均成 0.5;张嘴和抿嘴同时为高值会让网格相互拉扯。完成空间冲突处理后,还要进行时间平滑,但平滑不能过强,否则眨眼会变慢、语音口型会明显滞后。
完整可运行示例
下面的 Python 3.10+ 示例实现参数数据类、范围限幅、视线归一化、张嘴与抿嘴冲突处理,以及逐帧一阶平滑。输入分为情绪、行为和语音三层,输出可直接序列化为动画引擎、数字人 SDK 或网络传输层需要的逐帧参数。
from __future__ import annotations

import json
import math
from dataclasses import dataclass, fields

@dataclass
class FaceParameters:
    eye_open_left: float = 1.0
    eye_open_right: float = 1.0
    gaze_x: float = 0.0
    gaze_y: float = 0.0
    brow_raise: float = 0.0
    smile: float = 0.0
    jaw_open: float = 0.0
    lip_press: float = 0.0

RANGES = {
    "eye_open_left": (0.0, 1.0),
    "eye_open_right": (0.0, 1.0),
    "gaze_x": (-1.0, 1.0),
    "gaze_y": (-1.0, 1.0),
    "brow_raise": (0.0, 1.0),
    "smile": (0.0, 1.0),
    "jaw_open": (0.0, 1.0),
    "lip_press": (0.0, 1.0),
}

class ExpressionMixer:
    def __init__(self, smoothing: float = 0.5) -> None:
        if not math.isfinite(smoothing) or not 0 < smoothing <= 1:
            raise ValueError("平滑系数必须位于 (0, 1]")
        self.smoothing = smoothing
        self.previous = FaceParameters()

    def mix(
        self,
        emotion: dict[str, float],
        behavior: dict[str, float],
        speech: dict[str, float],
    ) -> FaceParameters:
        target = FaceParameters()

        # 情绪层负责眉毛与微笑,行为层负责视线和眨眼,语音层负责下颌。
        for layer, allowed in (
            (emotion, {"smile", "brow_raise", "lip_press"}),
            (behavior, {"eye_open_left", "eye_open_right", "gaze_x", "gaze_y"}),
            (speech, {"jaw_open", "lip_press"}),
        ):
            for name, value in layer.items():
                if name not in allowed or type(value) not in (int, float) or not math.isfinite(value):
                    raise ValueError(f"非法层参数: {name}")
                setattr(target, name, value)

        self._clamp(target)
        self._normalize_gaze(target)
        self._resolve_conflicts(target)

        result = FaceParameters()
        for field in fields(FaceParameters):
            old_value = getattr(self.previous, field.name)
            target_value = getattr(target, field.name)
            smoothed = old_value + self.smoothing * (target_value - old_value)
            if field.name in ("eye_open_left", "eye_open_right") and target_value == 0.0:
                smoothed = 0.0  # 只保留触发侧的短时闭合峰值
            setattr(result, field.name, smoothed)

        self._normalize_gaze(result)
        result.lip_press = min(result.lip_press, 1.0 - result.jaw_open)
        self.previous = FaceParameters(**vars(result))
        return result

    @staticmethod
    def _clamp(parameters: FaceParameters) -> None:
        for name, (minimum, maximum) in RANGES.items():
            value = getattr(parameters, name)
            setattr(parameters, name, max(minimum, min(maximum, value)))

    @staticmethod
    def _normalize_gaze(parameters: FaceParameters) -> None:
        length = math.hypot(parameters.gaze_x, parameters.gaze_y)
        if length > 1.0:
            parameters.gaze_x /= length
            parameters.gaze_y /= length

    @staticmethod
    def _resolve_conflicts(parameters: FaceParameters) -> None:
        # 张嘴越大,抿嘴参数越弱,避免互相拉扯导致嘴唇穿插。
        parameters.lip_press *= 1.0 - parameters.jaw_open

def main() -> None:
    mixer = ExpressionMixer(smoothing=0.5)
    frames = [
        {
            "emotion": {"smile": 0.8, "brow_raise": 0.3, "lip_press": 0.6},
            "behavior": {"gaze_x": 0.9, "gaze_y": 0.8},
            "speech": {"jaw_open": 0.0},
        },
        {
            "emotion": {"smile": 0.8, "brow_raise": 0.3, "lip_press": 0.6},
            "behavior": {"gaze_x": 0.9, "gaze_y": 0.8},
            "speech": {"jaw_open": 0.7},
        },
        {
            "emotion": {"smile": 0.8, "brow_raise": 0.3, "lip_press": 0.6},
            "behavior": {
                "eye_open_left": 0.0,
                "eye_open_right": 0.0,
                "gaze_x": 0.2,
                "gaze_y": 0.1,
            },
            "speech": {"jaw_open": 0.2},
        },
    ]

    output = []
    for index, layers in enumerate(frames):
        mixed = mixer.mix(**layers)
        display = {name: round(value, 3) for name, value in vars(mixed).items()}
        output.append({"frame": index, "parameters": display})

    print(json.dumps(output, ensure_ascii=False, indent=2))

if __name__ == "__main__":
    main()
将代码保存为 facial_expression_mixer.py,然后运行:
python facial_expression_mixer.py预期输出
[
  {
    "frame": 0,
    "parameters": {
      "eye_open_left": 1.0,
      "eye_open_right": 1.0,
      "gaze_x": 0.374,
      "gaze_y": 0.332,
      "brow_raise": 0.15,
      "smile": 0.4,
      "jaw_open": 0.0,
      "lip_press": 0.3
    }
  },
  {
    "frame": 1,
    "parameters": {
      "eye_open_left": 1.0,
      "eye_open_right": 1.0,
      "gaze_x": 0.561,
      "gaze_y": 0.498,
      "brow_raise": 0.225,
      "smile": 0.6,
      "jaw_open": 0.35,
      "lip_press": 0.24
    }
  },
  {
    "frame": 2,
    "parameters": {
      "eye_open_left": 0.0,
      "eye_open_right": 0.0,
      "gaze_x": 0.38,
      "gaze_y": 0.299,
      "brow_raise": 0.262,
      "smile": 0.7,
      "jaw_open": 0.275,
      "lip_press": 0.36
    }
  }
]
第 0 帧的视线输入为 (0.9, 0.8),长度超过 1,因此先归一化,再与上一帧做 0.5 系数平滑。第 1 帧张嘴目标为 0.7,抿嘴目标会先乘以 1 - jaw_open,所以不会与下颌动作强烈对抗。第 2 帧两侧都触发全闭,因此直接输出 0,回弹仍可平滑。只向左眼传入 0 时,右眼保持自己的目标。固定系数假设帧间隔稳定;渲染帧率变化时可按时间常数计算 alpha = 1 - exp(-dt / tau)。示例的三位小数只供展示,实际驱动用混合器返回的浮点数。
工程验证与常见问题
参数系统应同时做静态测试和时间序列测试。静态测试检查最小值、最大值、未知字段和坐标方向;时间序列测试检查眨眼峰值、视线跳转、微笑渐入和口型叠加。调试时最好记录“各层输入、冲突处理后目标值、平滑后输出值”三组数据,这样能快速判断问题来自上游驱动、混合规则还是渲染资产。
- 表情幅度忽大忽小:不同驱动使用了不同取值范围。应在进入混合器前统一归一化,并在输出端再次限幅。
- 眼睛闭合不彻底:眨眼与保持睁眼被平均。应把眨眼设为覆盖规则,或对眼睛开合取更强的关闭结果。
- 视线到达四角时变形:
gaze_x与gaze_y分别合法,但二维向量长度超过 1。应对视线向量整体归一化。 - 嘴唇穿插或形状僵硬:
jaw_open、lip_press、闭口视素同时为高值。应定义互斥矩阵,并保留语音层对关键嘴部通道的优先级。 - 表情稳定但反应迟钝:所有通道共用过大的平滑时间常数。应让眨眼、视线、情绪和口型使用不同的响应速度。
本课总结
- 面部驱动需要统一参数语义、范围、坐标方向和默认值,不能只约定字段名。
- 分层合并、优先级和互斥规则决定多个驱动同时工作时的可预测性。
- 限幅、归一化与按通道时间平滑共同保证输出稳定且不过度迟滞。
下一课预告
下一阶段将把口型与表情参数接入统一的实时驱动循环,继续处理音频、对话状态和动画渲染之间的同步、性能预算与异常回退。