
AI 内容创作 / 系统课时
数字音频的采样与编码
数字音频的采样与编码
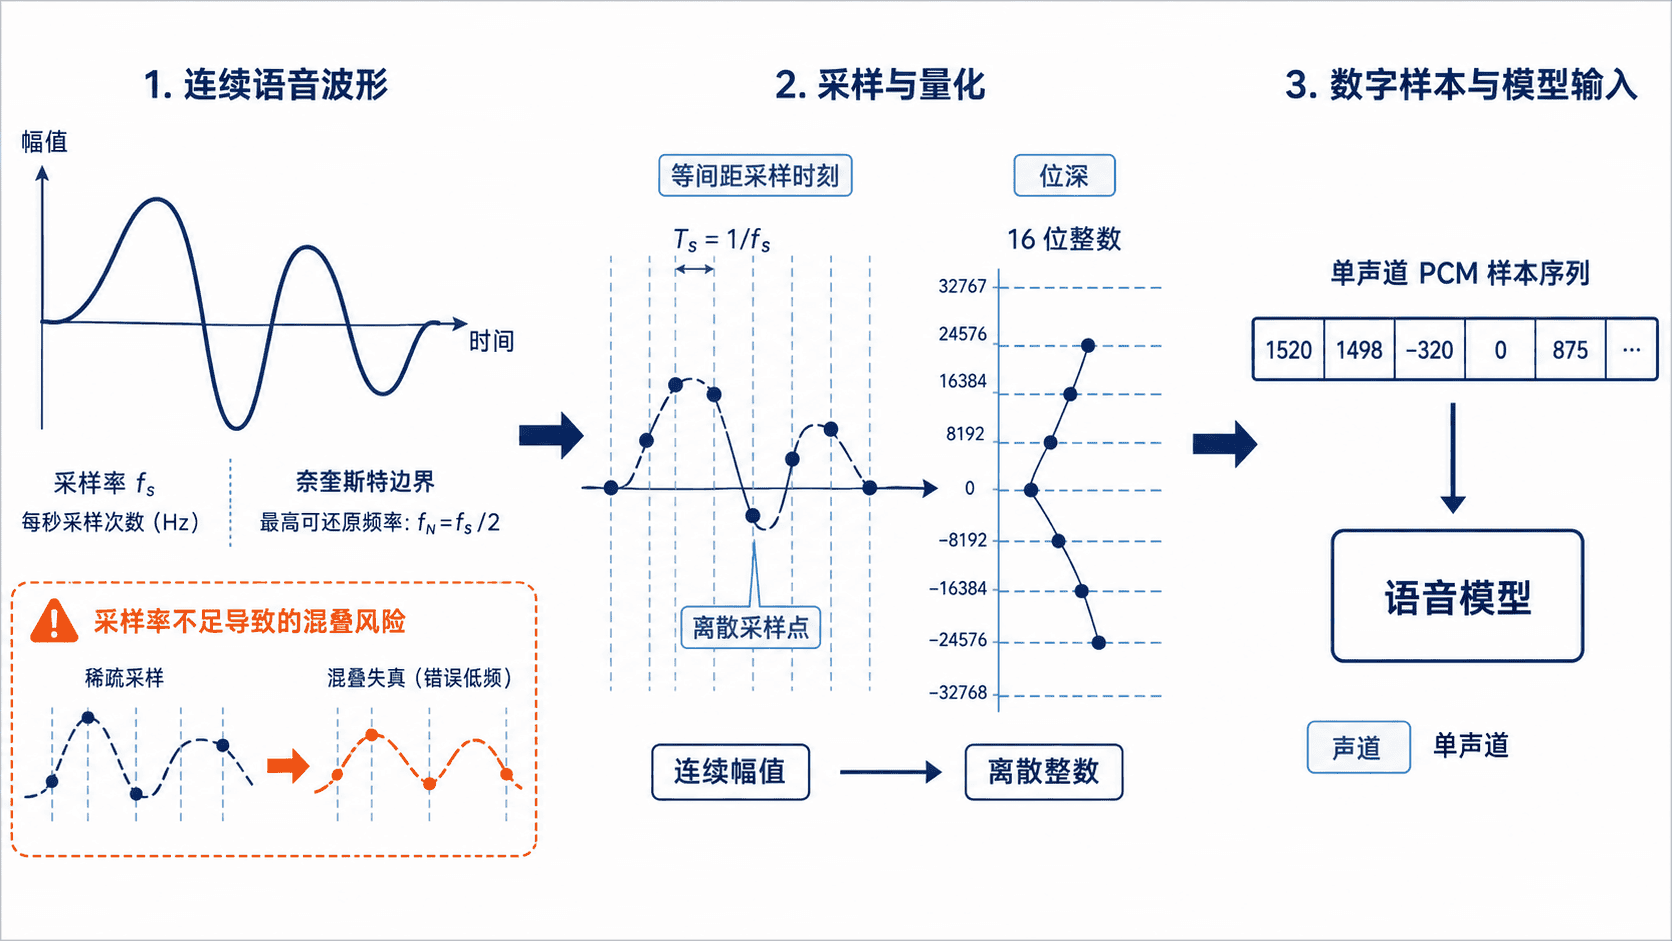
数字人系统接收的不是连续声波,而是一串按固定时间间隔记录的数字样本。本课从采样、量化和声道三个维度建立音频表示模型,并用可运行的 Python 程序生成与检查 PCM WAV 文件,帮助你判断素材是否符合语音识别、声音克隆或口型驱动模型的输入要求。
学习目标
- 解释采样率、位深、声道数与音频质量、数据量之间的关系。
- 区分 PCM、编码格式与容器格式,避免只看文件扩展名判断音频。
- 生成并检查标准的单声道 16 kHz、16 位 PCM WAV 文件。
采样、量化与声道
麦克风输出的是随时间连续变化的电信号。采样过程每隔固定时间读取一次幅度,采样率记为 ,单位为 Hz。16 kHz 表示每声道每秒 16000 个样本。一个采样帧包含同一时刻各声道的样本。对已限带信号,最高频率需严格低于 才能按理想采样模型重建。真实录音和降采样需要抗混叠低通,滤波过渡带也占用带宽。
量化把每个样本映射到有限整数范围。16 位有符号 PCM 常用范围为 -32768~32767,位深越高,可表示的幅度级数越多,量化噪声通常越低,但存储量也会增加。声道数描述同一时刻保存几组样本:语音模型常使用单声道。需要从立体声转换时,先确认哪一路承载语音和两路相位,再决定取有效声道还是混合。
未压缩 PCM 的理论数据率可用下式估算:
其中, 为采样率, 为位深, 为声道数。16 kHz、16 位、单声道音频的数据率为 256000 bit/s,即 32000 字节/秒或 31.25 KiB/s。同样参数的 10 秒语音,纯样本数据约为 312.5 KiB,文件还会包含少量头部信息。
模型输入与格式边界
语音模型通常要求固定的采样率、声道数和样本类型。参数不一致不一定让程序立刻报错,却可能改变频谱、音量或时间轴,使识别准确率、音色相似度和口型同步效果下降。进入模型前应读取真实流参数,而不是根据文件名猜测。
| 参数 | 常见语音输入 | 变化带来的影响 |
|---|---|---|
| 采样率 | 16 kHz、24 kHz 或模型指定值 | 过低会丢失高频信息,随意改高不会恢复已丢失细节 |
| 位深 | 16 位 PCM 或 32 位浮点 | 位深影响幅度精度,模型框架可能在加载后统一转换为浮点 |
| 声道 | 单声道 | 立体声直接取单侧可能丢失另一侧信息,应先按规则混合 |
| 编码 | PCM、FLAC 或模型明确支持的格式 | 有损编码可能引入压缩伪影,重复转码会继续累积损失 |
PCM 描述样本如何保存;WAV、AIFF 等是容器;AAC、MP3、Opus、FLAC 等是编码格式。WAV 文件内部既可以是 PCM,也可能封装其他编码,因此扩展名为 .wav 并不能证明它一定是 16 位 PCM。训练数据准备阶段宜保留无损母版,交付或传输时再根据系统能力选择压缩格式。
可运行示例与验证
下面的程序使用 Python 标准库生成 1 秒、440 Hz 的正弦波,将其编码为 16 kHz、16 位、单声道 PCM WAV,并重新读取文件验证关键参数。将代码保存为 audio_sampling_demo.py。
import math
import struct
import wave

SAMPLE_RATE = 16000
DURATION_SECONDS = 1
FREQUENCY_HZ = 440
AMPLITUDE = 0.8
OUTPUT_FILE = "voice_input.wav"

def create_pcm_wave() -> None:
    frame_count = SAMPLE_RATE * DURATION_SECONDS
    samples = []

    # 将 -1.0~1.0 的波形映射到 16 位有符号整数范围。
    for index in range(frame_count):
        phase = 2 * math.pi * FREQUENCY_HZ * index / SAMPLE_RATE
        sample = round(AMPLITUDE * 32767 * math.sin(phase))
        samples.append(sample)

    # WAV 中的 16 位 PCM 使用小端序,每个样本占 2 字节。
    pcm_bytes = b"".join(struct.pack("<h", sample) for sample in samples)

    with wave.open(OUTPUT_FILE, "wb") as wav_file:
        wav_file.setnchannels(1)
        wav_file.setsampwidth(2)
        wav_file.setframerate(SAMPLE_RATE)
        wav_file.writeframes(pcm_bytes)

def inspect_wave() -> None:
    # 重新读取文件头,验证落盘后的真实参数。
    with wave.open(OUTPUT_FILE, "rb") as wav_file:
        channels = wav_file.getnchannels()
        sample_width_bits = wav_file.getsampwidth() * 8
        sample_rate = wav_file.getframerate()
        frame_count = wav_file.getnframes()
        data = wav_file.readframes(frame_count)
        if (channels, sample_rate, sample_width_bits, frame_count) != (1, 16000, 16, 16000):
            raise ValueError("unexpected PCM parameters")
        if len(data) != frame_count * channels * (sample_width_bits // 8):
            raise ValueError("truncated PCM samples")
        duration = frame_count / sample_rate

    print(f"sample_rate={sample_rate} Hz")
    print(f"channels={channels}")
    print(f"sample_width={sample_width_bits} bit")
    print(f"frames={frame_count}")
    print(f"duration={duration:.3f} s")

if __name__ == "__main__":
    create_pcm_wave()
    inspect_wave()
使用 Python 3 运行:
python audio_sampling_demo.py预期输出如下,同时当前目录会生成 voice_input.wav:
sample_rate=16000 Hz
channels=1
sample_width=16 bit
frames=16000
duration=1.000 s
此例使用普通 PCM WAV。Python 3.11 的 wave 只支持未压缩 PCM,支持的 WAV 变体随 Python 版本变化。其他编码可先用 FFprobe 确认后再解码。检查真实素材时,还应确认是否削波。若大量样本等于 32767 或 -32768,通常说明录音增益过高;若波形长期接近零,则可能存在过低电平、静音段过长或声道读取错误。修改采样率前应使用重采样算法,不能只改文件头中的数值,否则播放速度和音高都会变化。
本课总结
- 采样率控制时间离散精度,位深控制幅度离散精度,声道数决定每个时刻保存几组样本。
- PCM、编码格式和容器是不同层次,模型输入必须以实际流参数为准。
- 统一格式时要执行真正的重采样与声道混合,并在处理后重新读取参数验证。
下一课预告
下一课将学习“音频预处理与响度归一化”,把不同来源的录音统一为稳定的模型输入,并完成重采样、静音裁剪、基础降噪和响度控制。