
AI 内容创作 / 系统课时
音频与语音链路排障
音频与语音链路排障
本课建立一套从采集、编码、传输、识别、合成到播放的排障顺序,并通过可运行的 WAV 诊断脚本检查采样率、声道、位深、音量、削波和截断风险,减少凭感觉反复试错。
学习目标
- 按音频链路阶段定位故障,而不是同时修改多个参数。
- 识别采样率、设备占用、低音量、截断、延迟和卡顿的典型信号。
- 使用脚本输出可复现的音频质量基线。
先确定故障所在阶段
同一个“听不清”可能来自麦克风输入过低、编码元数据错误、网络分片丢失、ASR 排队、TTS 文本规范化错误或播放器缓冲不足。排障时先固定测试语句和设备,再逐段保存中间产物;哪一段首次出现异常,根因通常就在该段或它的直接输入。
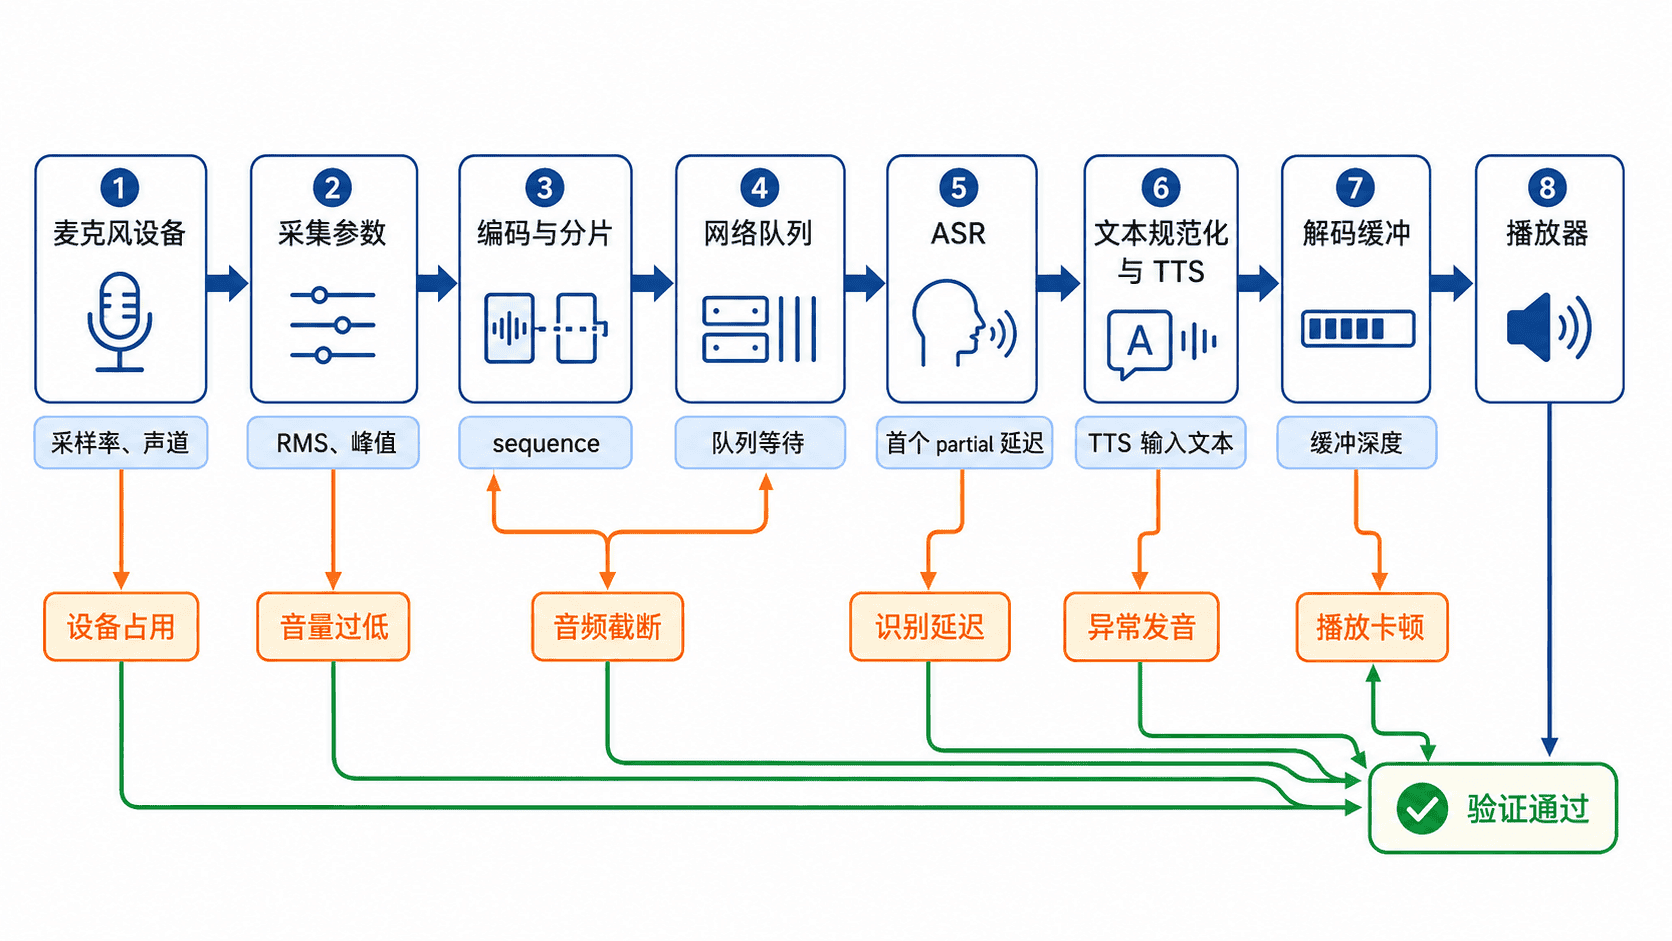
建议为每次请求贯穿同一个 traceId,并记录采集开始、最后音频分片、ASR 首个增量结果、TTS 首包和播放器首帧时间。同一进程内用单调时钟计算耗时;跨进程按 traceId 对齐各自测得的阶段耗时和传输证据,不能直接相减不同机器的单调时钟。
四类基线指标
| 阶段 | 首要检查 | 常见异常信号 | 优先处理 |
|---|---|---|---|
| 采集 | 设备、采样率、声道、RMS、峰值 | NotReadableError、静音、削波 |
释放设备、确认权限、调整增益 |
| 传输 | 分片大小、sequence、队列长度 |
序号缺口、尾包缺失、积压增长 | 有界队列、补充结束标记、背压 |
| 识别与合成 | 首个结果延迟、输入文本、语言与发音词典 | 首字慢、数字或多音字读错 | 分离排队、VAD、模型和文本问题 |
| 播放 | 解码耗时、缓冲深度、waiting 事件 |
卡顿、速度或音调异常 | 校验采样率、预缓冲、降低分片抖动 |
脚本中的 -35 dBFS、0.98 峰值比例和 0.2 s 时长只是筛查阈值,不是所有业务的统一验收线。团队应先用正常样本建立分布,再用 p50、p95 和失败样本确定告警边界。
完整可运行诊断脚本
下面的 Python 程序只使用标准库。它先生成一段 16 kHz、单声道、16 bit PCM 的测试音,再读取 WAV 头和样本,计算峰值、RMS、削波数量与时长。运行时传入待测 WAV 路径以只读诊断,或用 --demo 在临时目录生成测试音。示例面向短 PCM 文件,超过 64 MiB 的数据应换用流式分析。
import argparse
import math
import struct
import wave
from pathlib import Path
from tempfile import TemporaryDirectory

SAMPLE_RATE = 16000
DURATION_SECONDS = 1.0
FREQUENCY_HZ = 440
AMPLITUDE = 0.30

def write_demo_wav(path: Path) -> None:
    sample_count = int(SAMPLE_RATE * DURATION_SECONDS)
    samples = [
        int(32767 * AMPLITUDE * math.sin(2 * math.pi * FREQUENCY_HZ * i / SAMPLE_RATE))
        for i in range(sample_count)
    ]
    frames = struct.pack(f"<{len(samples)}h", *samples)

    with wave.open(str(path), "wb") as wav_file:
        wav_file.setnchannels(1)
        wav_file.setsampwidth(2)
        wav_file.setframerate(SAMPLE_RATE)
        wav_file.writeframes(frames)

def analyze_wav(path: Path) -> None:
    with wave.open(str(path), "rb") as wav_file:
        channels = wav_file.getnchannels()
        sample_width = wav_file.getsampwidth()
        sample_rate = wav_file.getframerate()
        frame_count = wav_file.getnframes()
        if sample_width != 2 or wav_file.getcomptype() != "NONE":
            raise ValueError("示例诊断器只接受 16 bit PCM WAV")
        expected = frame_count * channels * sample_width
        if not 0 < expected <= 64 * 1024**2:
            raise ValueError("音频为空或超过 64 MiB 教学处理上限")
        raw = wav_file.readframes(frame_count)
        if len(raw) != expected:
            raise ValueError("WAV 头部声明的帧数与实际 PCM 字节数不符")
    samples = struct.unpack(f"<{frame_count * channels}h", raw)

    peak = max(abs(sample) for sample in samples)
    rms = math.sqrt(sum(sample * sample for sample in samples) / len(samples))
    peak_ratio = peak / 32768
    rms_dbfs = 20 * math.log10(rms / 32768) if rms else float("-inf")
    full_scale_samples = sum(sample in (-32768, 32767) for sample in samples)
    duration = frame_count / sample_rate

    issues = []
    if sample_rate not in {16000, 24000, 48000}:
        issues.append("采样率不在常用语音链路集合中")
    if channels != 1:
        issues.append("识别上行建议转换为单声道")
    if rms_dbfs < -35:
        issues.append("平均音量过低")
    if peak_ratio > 0.98 or full_scale_samples:
        issues.append("接近或达到满幅,检查连续平顶与削波风险")
    if duration < 0.2:
        issues.append("音频较短,需核对预期录音时长与尾包")

    print(f"文件: {path.name}")
    print(f"采样率: {sample_rate} Hz")
    print(f"声道数: {channels}")
    print(f"位深: {sample_width * 8} bit")
    print(f"时长: {duration:.2f} s")
    print(f"峰值: {peak_ratio:.4f}")
    print(f"RMS: {rms_dbfs:.2f} dBFS")
    print(f"满幅样本: {full_scale_samples}")
    print("诊断: " + ("PASS" if not issues else "; ".join(issues)))

if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    mode = parser.add_mutually_exclusive_group(required=True)
    mode.add_argument("--demo", action="store_true")
    mode.add_argument("--input", type=Path)
    args = parser.parse_args()
    try:
        if args.demo:
            with TemporaryDirectory() as folder:
                target = Path(folder) / "diagnostic.wav"
                write_demo_wav(target)
                analyze_wav(target)
        else:
            analyze_wav(args.input)
    except (OSError, EOFError, ValueError, wave.Error) as error:
        raise SystemExit(f"诊断失败: {error}") from error
运行脚本。
python3 audio_diagnose.py --demo预期输出:
文件: diagnostic.wav
采样率: 16000 Hz
声道数: 1
位深: 16 bit
时长: 1.00 s
峰值: 0.3000
RMS: -13.47 dBFS
满幅样本: 0
诊断: PASS
典型故障的修复顺序
设备占用或硬件读取失败可能返回 NotReadableError;用户拒绝、权限策略或非安全上下文可能导致权限错误;约束不被支持可能是 OverconstrainedError。先停止其他录音程序并枚举设备,再用最小约束申请麦克风,成功后逐项加入降噪、回声消除和指定采样率。
音量过低先看 RMS,再看峰值。RMS 低且峰值也低,通常是输入增益或距离问题;峰值接近满幅且存在大量削波,继续增益只会恶化识别。音频截断要检查分片 sequence 是否连续、停止录音后最后一个 dataavailable 是否发送,以及服务端是否收到明确的流结束事件。
识别延迟要拆成 VAD 结束等待、网络上传、队列等待、模型计算和结果回传。异常发音则先保存 TTS 的规范化后文本,检查数字、日期、缩写、多音字和标点,再核对音色、语言及采样率元数据。若整段语速或音调异常,优先怀疑播放器按错误采样率解释 PCM。
播放卡顿应同时观察网络到达间隔和播放器缓冲深度。到达抖动大时增加有限预缓冲;解码慢时降低编码复杂度或复用解码器;生产速度长期低于消费速度时,单纯扩大缓冲只会把卡顿变成更高延迟。
回归验证清单
修复后使用同一句测试文本、同一设备和同一网络条件复测,并保留原始采集、上传前音频、ASR 文本、TTS 音频与播放器事件日志。验收至少覆盖正常说话、短句、长句、静音、快速停止、断网恢复和连续多轮会话,确认修复没有引入新的截断或延迟回退。
对于偶发问题,按 traceId 汇总 p50、p95、失败率、分片缺口和缓冲欠载次数。只有指标恢复且故障样本可重复通过,才能关闭排障项。
本课总结
- 音频排障应沿采集、传输、识别、合成和播放逐段保存证据。
- 采样率、声道、RMS、峰值、序号和阶段时间点构成最小诊断基线。
- 修复必须通过固定样本和回归场景验证,不能只凭一次主观试听判断。
下一课预告
后续综合项目将把客户端与服务端观测数据串联起来,继续处理跨模块故障、容量瓶颈和端到端验收问题。