
AI 内容创作 / 系统课时
情感语音与韵律控制
情感语音与韵律控制
数字人的声音不仅要把文字读对,还要让语气符合角色身份、对话意图和当前场景。本课将把情感标签、参考音频、韵律参数与文本标记整理为一条可验证的控制链路,并通过可运行示例生成供应商无关的合成请求。
学习目标
- 区分情感标签、参考音频、韵律参数和文本标记的职责
- 设计稳定的控制优先级与参数边界
- 生成可校验、可映射到语音合成接口的分段请求
控制入口与优先级
情感语音通常同时接收角色基线、场景情绪、局部强调和参考音频。若这些来源没有明确优先级,同一句话可能出现语速忽快忽慢、音高突变或情绪覆盖角色设定的问题。工程上应先固定角色音色与基础说话风格,再叠加场景级情绪,最后处理局部停顿、重音和语速变化。
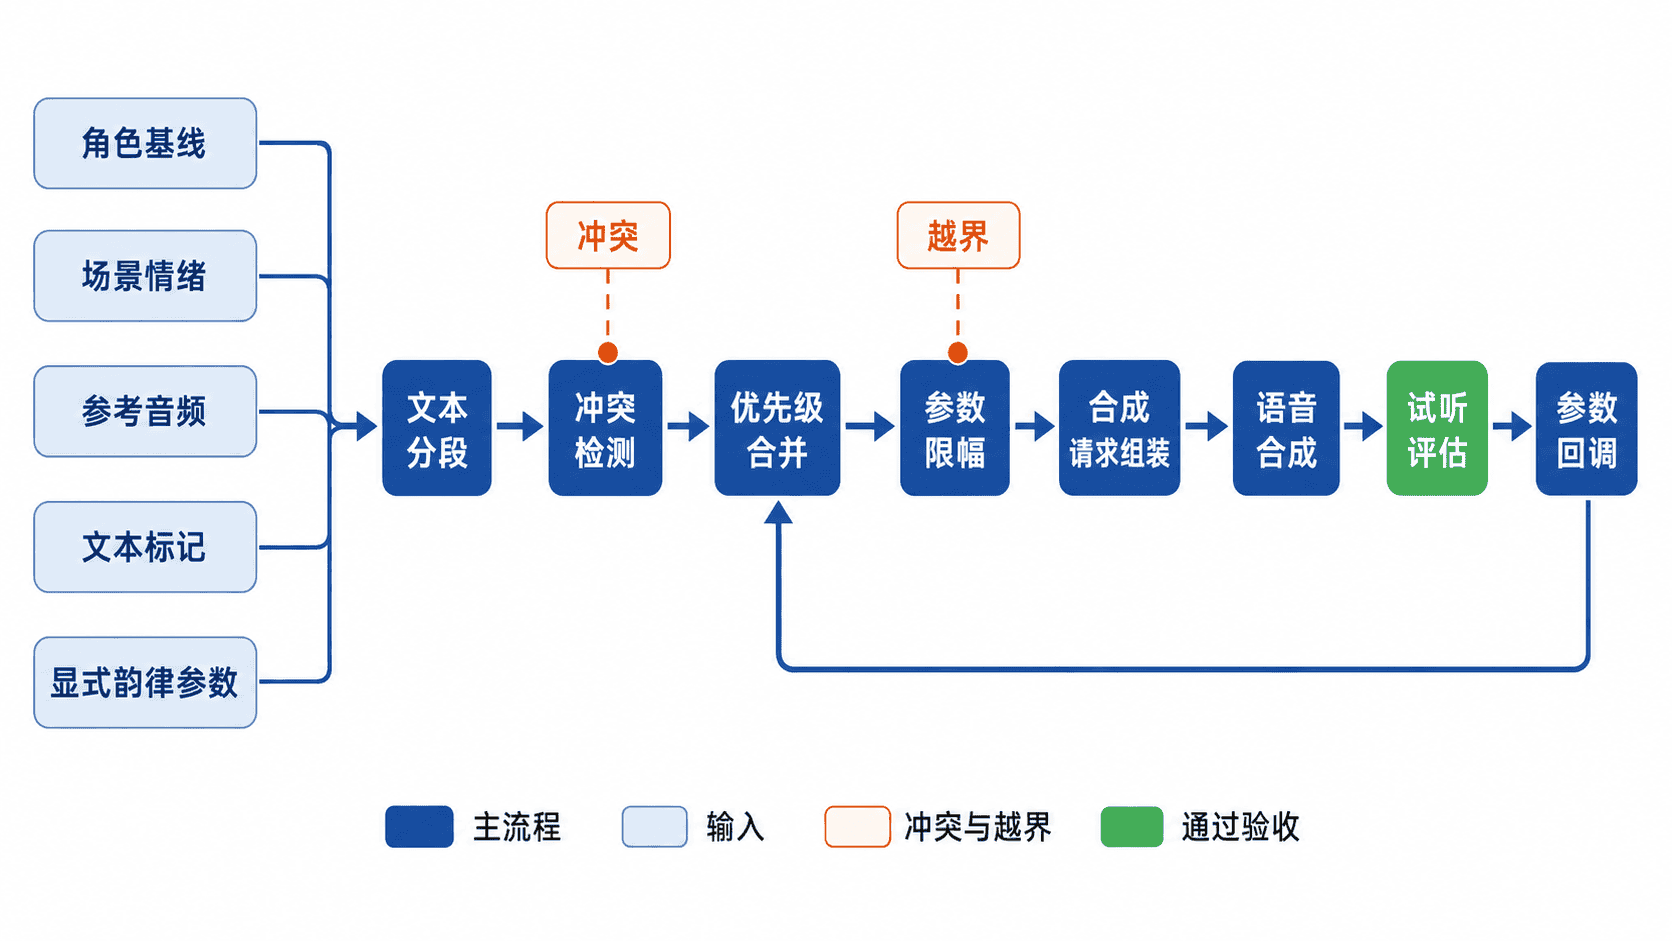
推荐的优先级是:发音词典与安全规则最高,文本语义和标点其次,角色基线高于临时情绪,局部强调只作用于目标片段。参考音频用于提供整体音色或风格时,也应经过相似度、噪声和授权检查,不能直接覆盖不可变的角色约束。
| 控制入口 | 主要作用 | 适合粒度 | 典型风险 |
|---|---|---|---|
| 情感标签 | 指定平静、严肃、兴奋等总体语气 | 句子或段落 | 标签过强导致表演夸张 |
| 参考音频 | 提供音色、节奏或表达风格 | 整段 | 噪声、内容泄漏、风格漂移 |
| 韵律参数 | 控制语速、音高、音量和停顿 | 片段 | 参数越界导致不自然 |
| 文本标记 | 标出重音、停顿和局部情绪 | 词语或短句 | 标记嵌套错误或切分破坏语义 |
韵律参数与文本标记
语速通常用相对倍率表示,1.0 代表基准速度;音高可用半音 st 表示;音量可用相对分贝表示;停顿使用毫秒更便于跨接口映射。服务型数字人应优先采用小范围调整,例如语速保持在 0.85 到 1.15,音高控制在约 -3 st 到 3 st,避免为了突出情绪而破坏可懂度。
文本标记应围绕语义边界放置。逗号、句号和问号先决定自然停顿,再由局部标签调整重音或情绪。参考音频更适合约束整体风格,局部文本标记更适合控制一句话内部的变化;两者冲突时,应保留角色基线并削弱局部参数。
完整可运行示例
下面的 Python 程序不调用特定语音供应商,而是把带标签文本转换为结构化请求。将代码保存为 emotion_prosody_demo.py;真实接入时核对每个声音和接口支持的参数,并为不支持的局部风格明确拒绝或降级。
from dataclasses import asdict, dataclass
import json
import re


@dataclass(frozen=True)
class Prosody:
    rate: float
    pitch_st: float
    volume_db: float
    pause_ms: int


PROFILES = {
    "neutral": Prosody(1.0, 0.0, 0.0, 100),
    "warm": Prosody(.96, 1.0, 0.0, 120),
    "serious": Prosody(.90, -1.5, .5, 180),
    "emphasis": Prosody(.88, 1.8, 1.5, 220),
}
TAG = re.compile(r"(\[/?[a-z]+\])")


def build_request(marked_text):
    if not isinstance(marked_text, str) or len(marked_text) > 2000:
        raise ValueError("invalid text")
    segments, active = [], None
    tag_start = 0

    def add(text, style):
        if text.strip():
            segments.append({"text": text, "style": style, "prosody": asdict(PROFILES[style])})

    for part in TAG.split(marked_text):
        if TAG.fullmatch(part):
            name = part.strip("[]")
            if name.startswith("/"):
                if active is None or name[1:] != active or tag_start == len(segments):
                    raise ValueError("invalid closing or empty style")
                active = None
            else:
                if active is not None or name not in PROFILES:
                    raise ValueError("unknown or nested style")
                active, tag_start = name, len(segments)
        else:
            if "[" in part or "]" in part:
                raise ValueError("malformed style markup")
            add(part, active or "neutral")
    if active is not None or not segments:
        raise ValueError("unclosed style or empty request")
    return {"voiceRole": "service-assistant", "sampleRate": 24000, "segments": segments}


if __name__ == "__main__":
    request = build_request("提示:[warm]您好。[/warm][emphasis]请核对订单状态。[/emphasis]")
    for segment in request["segments"]:
        print(json.dumps(segment, ensure_ascii=False))
运行 python emotion_prosody_demo.py。预期输出如下。
{"text": "提示:", "style": "neutral", "prosody": {"rate": 1.0, "pitch_st": 0.0, "volume_db": 0.0, "pause_ms": 100}}
{"text": "您好。", "style": "warm", "prosody": {"rate": 0.96, "pitch_st": 1.0, "volume_db": 0.0, "pause_ms": 120}}
{"text": "请核对订单状态。", "style": "emphasis", "prosody": {"rate": 0.88, "pitch_st": 1.8, "volume_db": 1.5, "pause_ms": 220}}
这一简化语法由应用生成,只允许平铺标签。用户自由文本应直接放进普通片段。情绪属于表达风格,强调只改变局部韵律。适配器需转义文本,并防止模型停顿、标点停顿和外加静音重复叠加。预置参数并不能保证主观情绪符合预期。
调参与验收## 调参与验收
调参时应使用固定文本做单变量对比:先锁定音色,只改语速;再锁定语速,只改音高或停顿。验收至少覆盖角色一致性、情绪匹配、可懂度、数字与专有名词发音、句间衔接五项,并保存文本、参数、模型版本和音频结果,保证问题可以复现。
常见错误包括把整段文本统一标成强情绪、同时大幅修改多个参数,以及使用包含背景音乐或混响的参考音频。修复时先退回中性基线,再逐项增加控制;若接口不支持局部参数,可按语义分段合成,再按需要插入停顿或做短淡入淡出。试听确认没有吞音、接缝或重复停顿。
本课总结
- 情感控制应以角色基线为中心,按场景情绪和局部韵律逐层叠加
- 参数必须限幅并围绕语义边界分段,避免情绪突变和可懂度下降
- 稳定交付依赖固定文本、单变量对比和可追溯的参数记录
下一课预告
下一课将学习“流式合成与语音质量评估”,把分句请求转换为连续音频块,并用首包延迟、实时率、自然度和异常发音等指标验证实际效果。