
AI 内容创作 / 系统课时
媒体数据质量检查
媒体数据质量检查
数字人训练与驱动素材即使能够正常播放,也可能包含削波、长静音、持续底噪、画面模糊、解码缺帧或人脸不可见等问题。本课建立一套可执行的检查流程,把主观观察转换为指标、阈值、失败规则和标准化 JSON 报告。
学习目标
- 理解音频与视频质量指标的计算方法和适用边界
- 使用 Python、FFmpeg、NumPy 与 OpenCV 完成自动化检测
- 生成可供数据清洗、人工复核和训练集准入使用的质量报告
质量维度与判定边界
质量检查不是寻找一个“万能分数”,而是把不同风险拆成独立规则。阈值必须围绕具体任务校准:录音棚语音、手机实拍和低带宽视频的合理范围并不相同。下面的阈值仅用于演示检查结构。
| 维度 | 示例指标 | 演示阈值 | 含义 |
|---|---|---|---|
| 音频削波 | clipping_ratio |
<= 0.001 |
接近满量程的样本占比 |
| 长静音 | silence_ratio |
<= 0.10 |
低于静音门限的时间占比 |
| 背景噪声 | noise_window_dbfs |
<= -45 dBFS |
已标注无语音区间的背景电平 |
| 视频模糊 | blur_ratio |
<= 0.10 |
拉普拉斯方差低于阈值的帧占比 |
| 解码缺帧 | frame_count_matches |
true |
与可信清单里的帧数核对;未知时进入复核 |
| 人脸遮挡风险 | face_missing_ratio |
<= 0.10 |
当前检测器未返回人脸的帧比例 |
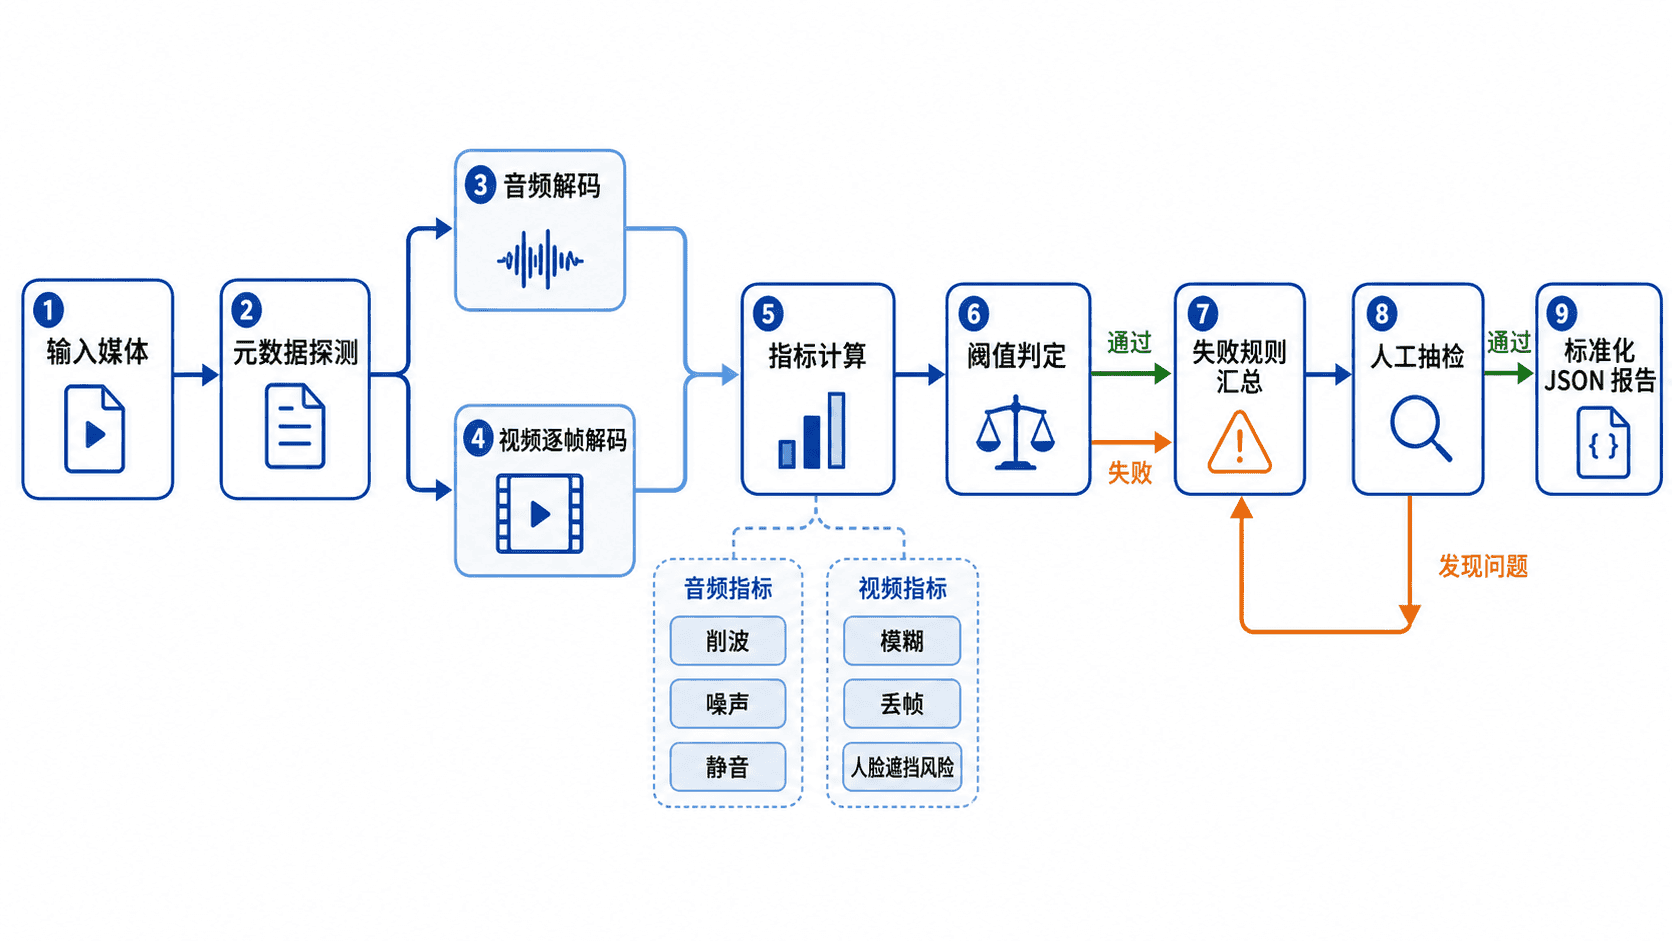
人脸检测失败只能表示“人脸不可用风险”,不能直接证明遮挡原因。生产系统通常还会结合人脸关键点、可见区域比例、头部姿态和连续帧稳定性。自动规则负责筛选与排序,边界样本仍应进入人工抽检。
检查流程
标准流程先读取媒体声明的时长、帧率、声道和采样率,再分别解码音频与视频。音频按固定窗口计算峰值、均方根和安静片段比例;视频逐帧计算清晰度分数、解码成功数与人脸可见性。所有指标统一写入报告,并保留触发的规则名称,便于后续定位和返工。
报告至少应包含文件标识、总体状态、音频指标、视频指标和失败规则。不要只输出 PASS 或 FAIL,否则无法判断问题来自素材本身、阈值设置还是解码环境。
完整可运行示例
示例只使用合成素材。环境为 Python 3.11、FFmpeg 8.0.1,并在虚拟环境安装 python -m pip install numpy==1.26.4 opencv-python-headless==4.11.0.86。保存为 media_quality_check.py,运行 python media_quality_check.py。程序在新目录保存测试素材及 JSON,不覆盖已有文件。
import json
import math
import subprocess
import wave
from pathlib import Path
from tempfile import mkdtemp

import cv2
import numpy as np


def create_fixture(audio, video):
    rate = 16000
    t = np.arange(4 * rate) / rate
    rng = np.random.default_rng(7)
    signal = 1.2 * np.sin(2 * np.pi * 440 * t)
    signal[: rate // 2] = rng.normal(0, 0.02, rate // 2)
    signal[2 * rate : 5 * rate // 2] = 0
    pcm = np.clip(np.rint(signal * 32768), -32768, 32767).astype("<i2")
    with wave.open(str(audio), "wb") as file:
        file.setparams((1, 2, rate, 0, "NONE", "not compressed"))
        file.writeframes(pcm.tobytes())

    subprocess.run([
        "ffmpeg", "-hide_banner", "-loglevel", "error", "-nostdin", "-n",
        "-f", "lavfi", "-i", "color=gray:size=640x360:rate=25:duration=4",
        "-i", str(audio), "-map", "0:v:0", "-map", "1:a:0",
        "-c:v", "ffv1", "-c:a", "pcm_s16le", str(video),
    ], check=True)


def max_channel_rms_dbfs(block):
    rms = float(np.sqrt(np.mean(block * block, axis=0)).max())
    return 20 * math.log10(max(rms, 1e-6))


def analyze_audio(path, noise_window=None):
    with wave.open(str(path), "rb") as file:
        if file.getsampwidth() != 2 or file.getcomptype() != "NONE":
            raise ValueError("expected 16-bit PCM")
        rate, channels, frames = file.getframerate(), file.getnchannels(), file.getnframes()
        payload = file.readframes(frames)
    if not frames or len(payload) != frames * channels * 2:
        raise ValueError("empty or incomplete audio")

    pcm = np.frombuffer(payload, dtype="<i2").reshape(-1, channels)
    clip = float(np.mean(np.abs(pcm.astype(np.int32)) >= 32760))
    signal = pcm.astype(np.float64) / 32768.0
    step = max(1, rate // 10)
    silent = 0
    for start in range(0, frames, step):
        block = signal[start : start + step]
        if max_channel_rms_dbfs(block) < -50:
            silent += len(block)

    noise = None
    if noise_window is not None:
        start, end = noise_window
        if not 0 <= start < end <= frames:
            raise ValueError("noise window out of bounds")
        noise = max_channel_rms_dbfs(signal[start:end])
    return {"clipping_ratio": clip, "silence_ratio": silent / frames, "noise_window_dbfs": noise}


def analyze_video(path, expected_frames=None):
    subprocess.run([
        "ffmpeg", "-v", "error", "-xerror", "-nostdin",
        "-i", str(path), "-map", "0:v:0", "-f", "null", "-",
    ], check=True)
    detector = cv2.CascadeClassifier(
        str(Path(cv2.data.haarcascades) / "haarcascade_frontalface_default.xml")
    )
    if detector.empty():
        raise ValueError("face detector unavailable")
    cap = cv2.VideoCapture(str(path))
    decoded = blurry = no_face = 0
    try:
        if not cap.isOpened():
            raise ValueError("video cannot be opened")
        while True:
            ok, image = cap.read()
            if not ok:
                break
            decoded += 1
            gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
            blurry += cv2.Laplacian(gray, cv2.CV_64F).var() < 80
            no_face += len(detector.detectMultiScale(gray, minSize=(80, 80))) == 0
    finally:
        cap.release()
    if decoded == 0:
        raise ValueError("no decoded video frames")
    return {
        "decoded_frames": decoded,
        "frame_count_matches": None if expected_frames is None else expected_frames == decoded,
        "blur_ratio": float(blurry / decoded),
        "face_missing_ratio": no_face / decoded,
    }


def report(audio_path, video_path, noise_window=None, expected_frames=None):
    try:
        audio = analyze_audio(audio_path, noise_window)
        video = analyze_video(video_path, expected_frames)
    except (ValueError, wave.Error, OSError, EOFError, subprocess.CalledProcessError, cv2.error):
        return {"status": "ERROR", "reason": "media_read_or_decode_failed"}

    rules = {
        "audio_clipping": audio["clipping_ratio"] > 0.001,
        "audio_silence": audio["silence_ratio"] > 0.10,
        "audio_noise": audio["noise_window_dbfs"] is not None and audio["noise_window_dbfs"] > -45,
        "video_frame_count": video["frame_count_matches"] is False,
        "video_blur": video["blur_ratio"] > 0.10,
        "face_missing": video["face_missing_ratio"] > 0.10,
    }
    failed = [name for name, triggered in rules.items() if triggered]
    unknown = [
        name for name, value in (
            ("background_noise", audio["noise_window_dbfs"]),
            ("expected_frames", video["frame_count_matches"]),
        ) if value is None
    ]
    return {
        "status": "FAIL" if failed else "REVIEW" if unknown else "PASS",
        "audio": audio, "video": video, "failed_rules": failed, "unknown_checks": unknown,
    }


if __name__ == "__main__":
    directory = Path(Path(mkdtemp(prefix="quality-demo-", dir=".")).name)
    audio, video = directory / "problem.wav", directory / "problem.mkv"
    create_fixture(audio, video)
    result = report(audio, video, noise_window=(0, 8000), expected_frames=100)
    (directory / "quality-report.json").write_text(
        json.dumps(result, ensure_ascii=False, allow_nan=False, indent=2) + "\n",
        encoding="utf-8",
    )
    print(result["status"])
    print(", ".join(result.get("failed_rules", [])))
预期输出
FAIL
audio_clipping, audio_silence, audio_noise, video_blur, face_missing
结果解读与工程边界
PCM 读写显式使用小端有符号 16 位。削波按各声道原值统计,先升位再取绝对值,避免 abs(-32768) 在 16 位整数里溢出,也避免下混抵消掩盖某一声道的削波。近满幅比例只是风险指标。静音用所有声道的窗口电平判断,末尾不满 100 ms 的窗口按实际样本数计入。背景电平只在确认无语音的区间计算。
FFmpeg 严格解码检查能发现许多解码错误;OpenCV 的帧数属性受后端影响,也无法证明拍摄时是否丢帧。课堂帧数来自受控生成设置。实拍素材结合时间戳、采集清单和预期时间线核查,未知时保留未核验状态。模糊阈值需按分辨率及内容标定,纯色帧是用来触发规则的合成样本。检测不到人脸可能由无脸、姿态、遮挡或光照引起。
排错与练习
若出现 ERROR,先分别核对输入流和解码器、检测器是否能加载。FAIL 表示至少一条业务阈值失败,REVIEW 表示当前没有触发失败规则但部分检查未完成。用自己拍摄且得到明确使用授权的素材复核阈值。应核对授权范围是否包含当前质检用途;若拟用于训练或发布,另核对这些用途的授权。示例的检测器仅统计检测结果,不执行身份识别。
可从上一课的提取步骤得到原视频实际音轨,再与同一视频进行联合检查,避免把另一个文件的音频指标误归到该视频。进一步记录不合格时间段、解码器版本和阈值配置,便于人工复核和复现。