
AI 内容创作 / 系统课时
语音活动检测
语音活动检测
语音活动检测负责从连续音频中找出真正包含人声的区间,避免把静音和环境噪声持续送入识别模型。本课将建立带迟滞和尾部等待的帧级状态机,并用可运行示例验证起点、终点与最短语音长度的判定结果。
学习目标
- 解释帧能量、起止阈值和迟滞机制的作用。
- 使用最短语音长度与尾部静音等待抑制抖动和截断。
- 根据延迟、漏检和误检现象调整 VAD 参数。
判定机制与关键参数
VAD 通常每 10~30 ms 分析一帧音频,并输出“语音概率”或二值结果。最简单的方法使用短时能量、过零率和频谱特征;神经网络 VAD 则能更好地区分人声、音乐、键盘声与稳定噪声。无论模型多复杂,工程层仍需要状态机把逐帧结果合并成连续语音片段。
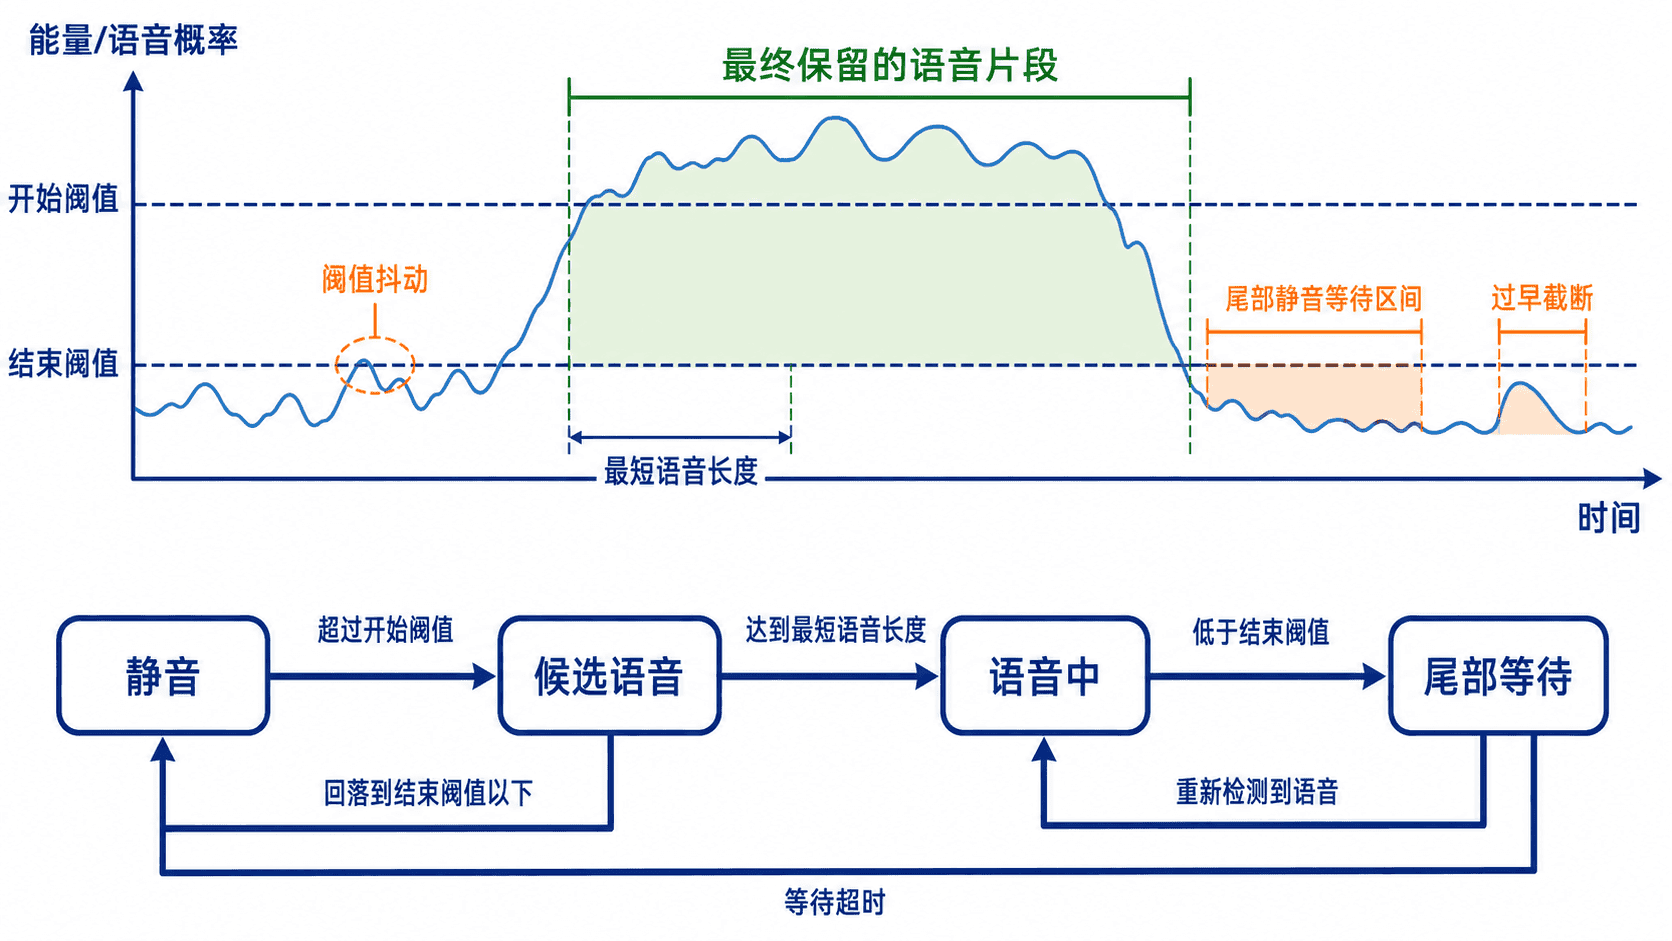
起始阈值应高于结束阈值。例如语音概率达到 0.65 才进入语音状态,而下降到 0.35 以下才开始结束计时。两个阈值形成迟滞区间,可避免概率在单一阈值附近波动时频繁开关。起点连续确认可滤除短暂冲击,仍可能把咳嗽判为语音。最短片段长度和尾部等待可作为不同参数。尾部等待确认是否结束;输出切片是否附带尾静音则单独控制。
| 参数 | 作用 | 设置过小的风险 | 设置过大的风险 |
|---|---|---|---|
| 开始阈值 | 确认语音开始 | 噪声误触发 | 句首漏检 |
| 结束阈值 | 判断语音减弱 | 片段拖长 | 弱音被截断 |
| 最短语音长度 | 过滤瞬时声音 | 咳嗽被当作语句 | 短回答被丢弃 |
| 尾部静音等待 | 确认语句结束 | 句尾截断 | 最终结果延迟增加 |
状态机与边界规则
一个稳定的 VAD 至少要区分静音和语音两个主状态,并用计数器表达候选语音与尾部等待。静音状态下,只有连续多帧超过开始阈值才确认起点;语音状态下,只有连续多帧低于结束阈值才确认终点。中间出现一帧低能量时不应立即结束,因为塞音闭塞、换气或词间停顿都可能产生短暂低谷。
对长度为 的帧序列,逐帧状态机的时间复杂度为 。如果只保存当前状态、连续帧计数和片段起点,额外空间为 ;若还要回放起点前的预卷音频,则需要一个固定长度环形缓冲区。实时数字人通常保留 100~300 ms 的预卷,以减少检测确认造成的句首丢失。
完整可运行示例
下面使用归一化帧能量模拟音频输入。程序设置较高的开始阈值、较低的结束阈值、连续两帧确认语音,以及连续两帧低能量确认结束。输出区间采用左闭右开形式,即 60-160 ms 表示包含 60 ms 时刻开始的帧,不包含 160 ms 时刻开始的帧。
from dataclasses import dataclass

@dataclass
class Segment:
    start_frame: int
    end_frame: int

def detect_speech(
    energies,
    start_threshold=0.06,
    stop_threshold=0.03,
    start_frames=2,
    tail_silence_frames=2,
):
    if not 0 <= stop_threshold < start_threshold <= 1:
        raise ValueError("invalid energy thresholds")
    if any(type(n) is not int or n < 1 for n in (start_frames, tail_silence_frames)):
        raise ValueError("frame counts must be positive integers")
    segments = []
    state = "silence"
    consecutive_speech = 0
    tail_silence = 0
    segment_start = None

    for index, energy in enumerate(energies):
        if not 0 <= energy <= 1:
            raise ValueError("invalid normalized energy")
        if state == "silence":
            # 连续达到开始阈值后,再回溯到候选区间的第一帧。
            if energy >= start_threshold:
                consecutive_speech += 1
                if consecutive_speech >= start_frames:
                    segment_start = index - start_frames + 1
                    state = "speech"
                    tail_silence = 0
            else:
                consecutive_speech = 0
        else:
            # 只有连续低于结束阈值,才确认语音真正结束。
            if energy < stop_threshold:
                tail_silence += 1
                if tail_silence >= tail_silence_frames:
                    speech_end = index - tail_silence_frames + 1
                    segments.append(Segment(segment_start, speech_end))
                    state = "silence"
                    consecutive_speech = 0
                    tail_silence = 0
                    segment_start = None
            else:
                tail_silence = 0

    # 输入结束时仍处于语音状态,需要提交最后一个片段。
    if state == "speech" and segment_start is not None:
        segments.append(Segment(segment_start, len(energies) - tail_silence))

    return segments

frame_ms = 20
energies = [
    0.01, 0.02, 0.01,
    0.08, 0.09, 0.07, 0.05, 0.04,
    0.02, 0.01, 0.02,
    0.07, 0.08, 0.06, 0.05,
    0.02, 0.01,
]

segments = detect_speech(energies)

for index, segment in enumerate(segments, start=1):
    start_ms = segment.start_frame * frame_ms
    end_ms = segment.end_frame * frame_ms
    print(f"片段 {index}: {start_ms}-{end_ms} ms")
将代码保存为 energy_vad_demo.py,运行命令如下。
python energy_vad_demo.py预期输出
片段 1: 60-160 ms
片段 2: 220-300 ms
结束确认等待两帧,但切片不包含确认用的尾静音。若 EOF 先到达,示例用同一规则去掉最后已观察到的尾静音。真实 VAD 可保留少量前后余量,再用源音频采样索引换算时间。示例按完整列表运行;跨音频块工作时,持久保存状态、绝对帧偏移与所需预卷。能量阈值只适用于此组归一化数据。真实 PCM 音频应先计算每帧 RMS 或模型语音概率,再根据设备增益和环境噪声校准阈值。固定能量法在风扇声、音乐和远场拾音中容易误判,生产系统通常使用噪声底估计或神经网络 VAD。
调参与验证
调参时不要只听单个样本。应准备安静近讲、远场说话、键盘声、背景音乐、短回答和长停顿等固定测试集,分别统计句首漏失、句尾截断、误触发次数和最终提交延迟。开始阈值主要控制误触发与句首漏检,尾部等待主要控制句尾完整性与响应速度。
若片段频繁断裂,先降低结束阈值或增加尾部静音帧数;若环境声经常触发,先提高开始阈值,再增加连续确认帧数。阈值不能替代输入质量治理,麦克风削波、自动增益突变和采样率错误应在 VAD 之前修复。最终还要检查 VAD 时间戳与 ASR 分块时间基是否一致。
本课总结
- VAD 把逐帧能量或语音概率合并为连续语音片段,是流式识别的入口控制器。
- 开始阈值高于结束阈值可形成迟滞,连续确认和尾部等待可抑制抖动与句尾截断。
- 参数必须用固定场景集验证,并在误触发、漏检和最终提交延迟之间取得平衡。
下一课预告
下一阶段将把 VAD 输出的语音片段接入实时识别与语义处理链路,重点关注分块缓存、时间戳连续性、临时文本与最终文本的协作方式。