
AI 内容创作 / 系统课时
综合项目需求与验收标准
综合项目需求与验收标准
本课把“做一个实时知识客服数字人”转化为可执行、可测量、可签字验收的项目契约。完成后,你将得到清晰的角色边界、知识范围、时延预算、质量门槛和验收报告结构,避免集成完成后才发现目标无法量化。
学习目标
- 将业务目标拆成角色、知识、交互和合规约束。
- 为端到端时延、回答质量、音画效果和稳定性定义可测指标。
- 使用机器可读的验收配置与脚本判断一次测试是否通过。
从业务目标收敛最小需求
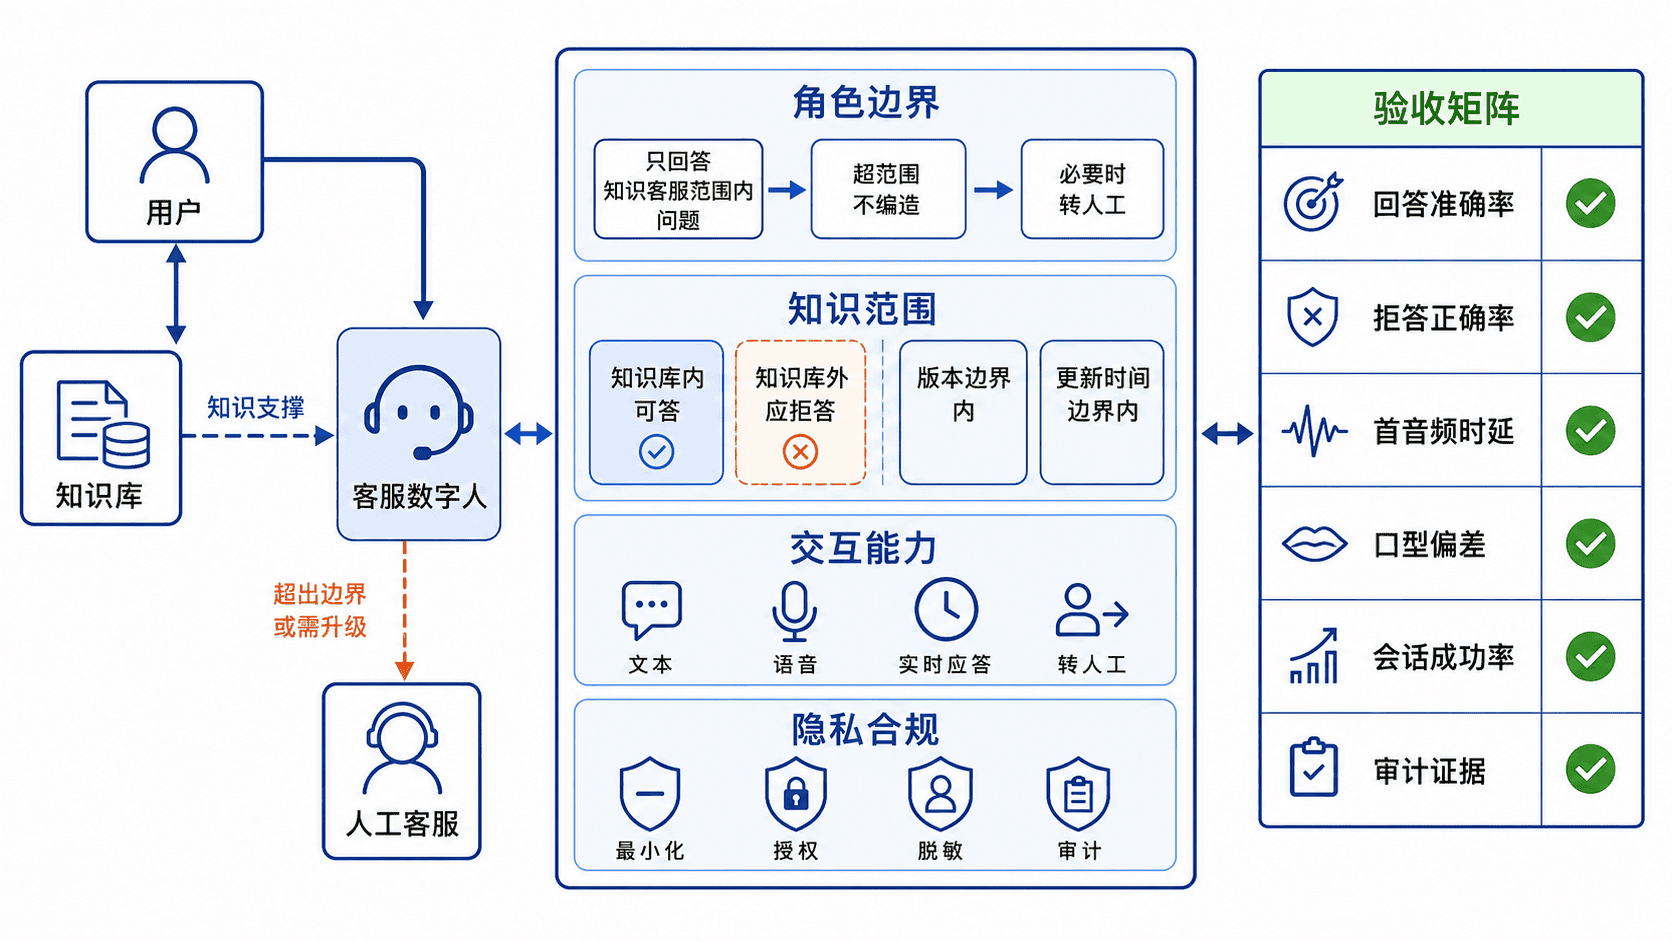
项目角色固定为“实时知识客服数字人”,首个版本只回答已经进入知识库且允许对外公开的内容。遇到知识库外问题、身份核验、退款审批或高风险建议时,系统必须明确拒答或转人工,不能为了提高回答率而猜测。
需求评审时应同时冻结四类边界:
| 维度 | 首版约束 | 验收证据 |
|---|---|---|
| 角色 | 只处理知识咨询,不执行审批 | 系统提示词、测试问题集 |
| 知识 | 仅使用指定知识库版本 | 文档版本号、引用来源 |
| 交互 | 支持语音输入、字幕和数字人播报 | 端到端录屏、链路日志 |
| 合规 | 不保存无关原始音频,不输出敏感数据 | 数据清单、审计记录 |
需求必须写成“输入条件、系统行为、可观察结果”的形式。例如:“当用户询问知识库外的退款审批时,系统在 2 秒内返回转人工提示,不生成虚构政策。”
建立可计算的验收指标
验收指标应覆盖用户感知、模型质量、媒体质量和工程稳定性。只写“响应快”“效果自然”无法执行,必须给出采样口径、统计方法、阈值和失败处理。
| 指标 | 建议口径 | 首版门槛 |
|---|---|---|
| 首音频时延 | 用户停说到设备实际播放首段回应的 p95 | 不高于 1500 ms,与第 12 章口径一致 |
| 端到端成功率 | 完成识别、回答、合成、渲染并正常结束的会话占比 | 不低于 99% |
| 知识回答正确率 | 标准问题集中答案事实正确且引用匹配的比例 | 不低于 90% |
| 越界拒答正确率 | 知识库外或高风险问题被正确拒答的比例 | 不低于 95% |
| 口型同步偏差 | 音素时间与口型关键帧时间差的绝对值 p95 | 不高于 120 ms |
| 会话恢复时间 | 有效恢复测试中,短暂断线到重新可交互的 p95 | 不高于 3 s,另报恢复失败比例 |
阈值不是孤立数字。测试报告还应记录测试集版本、模型版本、硬件、并发数、网络条件和样本量,否则不同轮次的数据无法比较。
用配置文件固化验收契约
将验收门槛保存为版本化 JSON,可以让测试脚本、流水线和人工评审读取同一份规则。下面的 acceptance_spec.json 是配置示例,字段分别描述比较方向和阈值。
{
  "project": "realtime-knowledge-customer-avatar",
  "version": "1.0.0",
  "metrics": {
    "first_audio_p95_ms": {
      "operator": "<=",
      "threshold": 1500
    },
    "session_success_rate": {
      "operator": ">=",
      "threshold": 0.99
    },
    "answer_accuracy": {
      "operator": ">=",
      "threshold": 0.9
    },
    "refusal_accuracy": {
      "operator": ">=",
      "threshold": 0.95
    },
    "lip_sync_p95_ms": {
      "operator": "<=",
      "threshold": 120
    },
    "recovery_p95_ms": {
      "operator": "<=",
      "threshold": 3000
    }
  }
}
配置生效后,任何阈值修改都应通过版本变更和评审记录完成,不能直接改测试报告中的判定结果。
运行一次自动化验收
下面的 Python 程序读取验收契约,使用代码内固定的测试结果逐项输出 PASS 或 FAIL。真实报告接入时还需校验数值类型、单位、样本量和未完成占比,并以进程退出码表示整体验收状态。将代码保存为 check_acceptance.py。
import json
import operator
import math
from pathlib import Path

OPERATORS = {
    "<=": operator.le,
    ">=": operator.ge,
}

def load_json(path: str) -> dict:
    return json.loads(Path(path).read_text(encoding="utf-8"))

def main() -> int:
    spec = load_json("acceptance_spec.json")
    report = {
        "first_audio_p95_ms": 1420,
        "session_success_rate": 0.992,
        "answer_accuracy": 0.93,
        "refusal_accuracy": 0.96,
        "lip_sync_p95_ms": 108,
        "recovery_p95_ms": 2100
    }

    rules = spec.get("metrics")
    if not isinstance(rules, dict) or set(rules) != set(report):
        print("overall: FAIL (验收项缺失或未知)")
        return 1
    all_passed = True
    for name, rule in rules.items():
        actual = report[name]
        if (not isinstance(rule, dict) or rule.get("operator") != ("<=" if name.endswith("_ms") else ">=")
                or type(rule.get("threshold")) not in (int, float)
                or not math.isfinite(rule["threshold"]) or rule["threshold"] < 0
                or (not name.endswith("_ms") and rule["threshold"] > 1)):
            print(f"{name}: FAIL (无效门槛)")
            all_passed = False
            continue
        passed = OPERATORS[rule["operator"]](actual, rule["threshold"])
        all_passed = all_passed and passed
        status = "PASS" if passed else "FAIL"
        print(f"{name}: {status} (actual={actual}, threshold={rule['operator']}{rule['threshold']})")

    print(f"overall: {'PASS' if all_passed else 'FAIL'}")
    return 0 if all_passed else 1

if __name__ == "__main__":
    raise SystemExit(main())
运行命令如下:
python check_acceptance.py预期输出如下:
first_audio_p95_ms: PASS (actual=1420, threshold=<=1500)
session_success_rate: PASS (actual=0.992, threshold=>=0.99)
answer_accuracy: PASS (actual=0.93, threshold=>=0.9)
refusal_accuracy: PASS (actual=0.96, threshold=>=0.95)
lip_sync_p95_ms: PASS (actual=108, threshold=<=120)
recovery_p95_ms: PASS (actual=2100, threshold=<=3000)
overall: PASS
组织验收与失败处理
正式验收至少分为功能、质量、性能和合规四轮。每轮都要保留原始样本、聚合结果和失败案例。指标未通过时先定位责任阶段,例如识别错误、检索缺失、回答幻觉、合成等待、渲染丢帧或播放器缓冲,再决定修复范围。
常见问题是只看平均时延、只测正常问题,或在测试中临时更换知识库。正确做法是同时观察 p50、p95 和最大值,加入越界问题、噪声语音、断网恢复与长会话,并冻结测试资产版本。
本课总结
- 可验收需求必须同时定义业务边界、测量口径、阈值和证据。
- 指标应覆盖回答质量、端到端体验、媒体同步和工程稳定性。
- 机器可读的验收契约能减少口头标准和报告判定不一致。
下一课预告
下一课将进入“端到端模块集成”,把语音识别、对话、语音合成、驱动、渲染和传输接入同一条带追踪标识的执行链路。