
AI 内容创作 / 系统课时
人像分割与背景处理
人像分割与背景处理
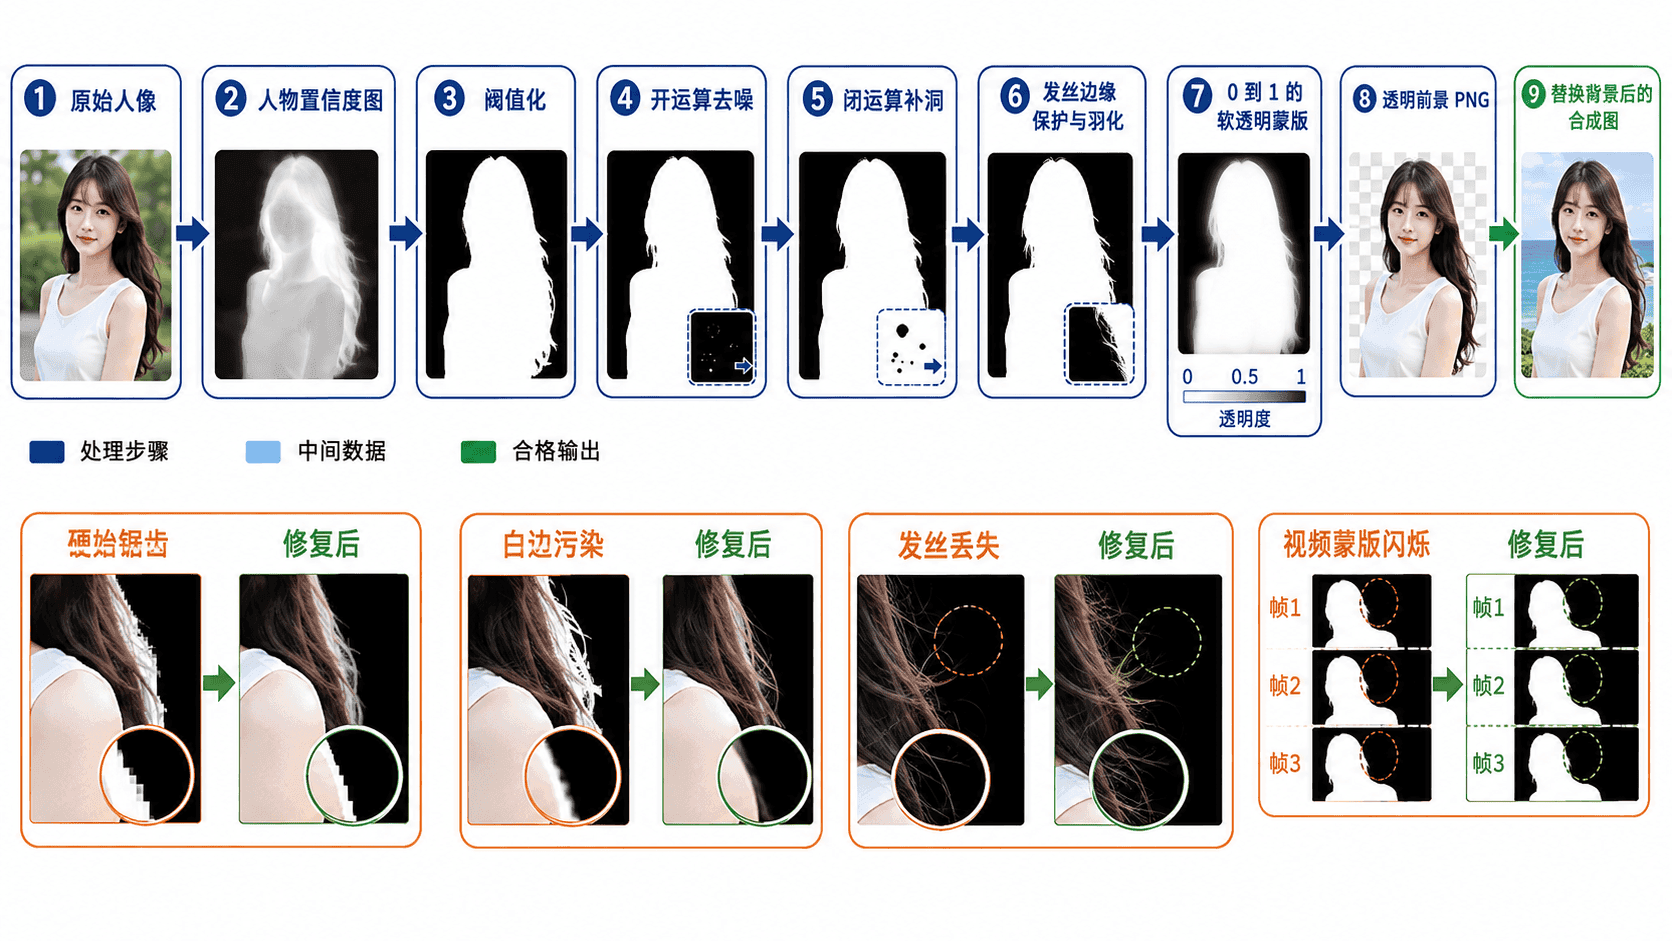
人像合成的质量往往由蒙版边缘决定,而不只由分割模型决定。本课将从人物区域出发,完成掩码清理、边缘羽化、透明通道生成与背景替换,最终输出可用于视频合成的透明前景图和可独立检查的灰度蒙版。
学习目标
- 理解二值分割掩码、置信度图和软透明蒙版之间的差异。
- 使用 OpenCV 完成人像前景提取、形态学清理、羽化和背景合成。
- 能够识别发丝丢失、边缘白边、时间闪烁和颜色溢出等典型问题。
分割与合成链路
分割模型通常输出类别索引或人物置信度,合成系统真正需要的是取值为 到 的透明度 。二值掩码只有“人物”和“背景”两种状态,适合粗定位;软蒙版可在边缘保留过渡,但分割模型的“属于人物”的置信度和像素的物理覆盖率是不同量。合成时需要估计 Alpha,发丝和半透明区域通常需要专门的抠图模型与前景颜色恢复。
假设背景完全不透明,在同一线性色彩空间使用 ,其中 是前景颜色, 是背景颜色, 是输出颜色。透明 PNG 通常保存直通透明度,也就是 RGB 保留原始前景颜色,Alpha 单独保存;若错误地先把边缘与白底混合,再换成深色背景,就会产生明显白边。
| 阶段 | 输入 | 输出 | 主要风险 |
|---|---|---|---|
| 分割 | 原始图像 | 类别掩码或置信度图 | 人物与背景颜色接近时漏分 |
| 掩码清理 | 粗掩码 | 去噪后的二值掩码 | 腐蚀过强会丢失发丝和手指 |
| 边缘优化 | 二值掩码与原图 | 软透明蒙版 | 羽化过大造成半透明光晕 |
| 合成 | 前景、背景与 Alpha | 新背景图或透明 PNG | 通道顺序和色彩空间错误 |
完整可运行示例
下面使用 OpenCV 的 GrabCut 作为可运行的教学基线。它适合单人居中、人物与背景有一定颜色差异的静态图像;生产系统可用语义分割生成粗掩码,或直接接入抠图模型估计 Alpha 和前景颜色。已有细节的软 Alpha 不应再次二值化。这里把源照片当作前景颜色的近似,会把旧背景的颜色带入某些边缘,输出透明 PNG 仅供教学预览。
准备 portrait.jpg 与 background.jpg,安装依赖:
python -m pip install opencv-python-headless numpy将代码保存为 portrait_composite.py:
import argparse
import math
from pathlib import Path

import cv2
import numpy as np

def resize_cover(image: np.ndarray, width: int, height: int) -> np.ndarray:
    """等比缩放并居中裁剪,使背景完整覆盖目标画布。"""
    source_height, source_width = image.shape[:2]
    scale = max(width / source_width, height / source_height)
    resized = cv2.resize(
        image,
        (math.ceil(source_width * scale), math.ceil(source_height * scale)),
        interpolation=cv2.INTER_LINEAR,
    )
    y1 = (resized.shape[0] - height) // 2
    x1 = (resized.shape[1] - width) // 2
    return resized[y1:y1 + height, x1:x1 + width]

def build_soft_alpha(
    image_bgr: np.ndarray,
    iterations: int,
    feather_size: int,
) -> np.ndarray:
    height, width = image_bgr.shape[:2]
    if min(height, width) < 8 or iterations < 1 or feather_size < 1:
        raise ValueError("图像至少 8×8,迭代次数和羽化尺寸须为正数")
    margin_x = max(1, round(width * 0.05))
    margin_y = max(1, round(height * 0.03))
    rect = (
        margin_x,
        margin_y,
        width - 2 * margin_x,
        height - 2 * margin_y,
    )

    # GrabCut 先依据矩形估计前景与背景,再迭代优化像素标签。
    labels = np.zeros((height, width), dtype=np.uint8)
    background_model = np.zeros((1, 65), dtype=np.float64)
    foreground_model = np.zeros((1, 65), dtype=np.float64)
    cv2.grabCut(
        image_bgr,
        labels,
        rect,
        background_model,
        foreground_model,
        iterations,
        cv2.GC_INIT_WITH_RECT,
    )

    binary = np.where(
        (labels == cv2.GC_FGD) | (labels == cv2.GC_PR_FGD),
        255,
        0,
    ).astype(np.uint8)

    # 小核开运算去除孤立噪点,闭运算填补人物内部的小孔洞。
    kernel = np.ones((3, 3), dtype=np.uint8)
    cleaned = cv2.morphologyEx(binary, cv2.MORPH_OPEN, kernel, iterations=1)
    cleaned = cv2.morphologyEx(cleaned, cv2.MORPH_CLOSE, kernel, iterations=2)

    if not np.any(cleaned) or np.all(cleaned):
        raise ValueError("蒙版无有效前景或背景,请调整框选或更换素材")
    if feather_size % 2 == 0:
        feather_size += 1
    softened = cv2.GaussianBlur(cleaned, (feather_size, feather_size), 0)
    return softened.astype(np.float32) / 255.0

def srgb_to_linear(image: np.ndarray) -> np.ndarray:
    c = image.astype(np.float32) / 255.0
    return np.where(c <= 0.04045, c / 12.92, ((c + 0.055) / 1.055) ** 2.4)

def composite_srgb(foreground: np.ndarray, background: np.ndarray, alpha: np.ndarray) -> np.ndarray:
    weight = alpha[:, :, None]
    linear = srgb_to_linear(foreground) * weight + srgb_to_linear(background) * (1.0 - weight)
    linear = np.clip(linear, 0.0, 1.0)
    encoded = np.where(linear <= 0.0031308, 12.92 * linear, 1.055 * linear ** (1 / 2.4) - 0.055)
    return np.round(encoded * 255.0).astype(np.uint8)

def main() -> int:
    parser = argparse.ArgumentParser()
    parser.add_argument("--input", required=True, help="输入人像路径")
    parser.add_argument("--background", required=True, help="替换背景路径")
    parser.add_argument("--output-dir", default="output")
    parser.add_argument("--iterations", type=int, default=5)
    parser.add_argument("--feather", type=int, default=9)
    args = parser.parse_args()

    portrait = cv2.imread(args.input)
    background = cv2.imread(args.background)
    if portrait is None:
        raise FileNotFoundError(f"无法读取输入人像: {args.input}")
    if background is None:
        raise FileNotFoundError(f"无法读取背景图像: {args.background}")

    height, width = portrait.shape[:2]
    background = resize_cover(background, width, height)
    alpha = build_soft_alpha(portrait, args.iterations, args.feather)
    # 教学示例假定两张输入均已转换为 sRGB。
    composite = composite_srgb(portrait, background, alpha)

    transparent = cv2.cvtColor(portrait, cv2.COLOR_BGR2BGRA)
    transparent[:, :, 3] = np.round(alpha * 255).astype(np.uint8)
    mask = np.round(alpha * 255).astype(np.uint8)

    output_dir = Path(args.output_dir)
    output_dir.mkdir(parents=True, exist_ok=True)
    mask_path = output_dir / "mask.png"
    foreground_path = output_dir / "foreground.png"
    composite_path = output_dir / "composite.jpg"

    if not cv2.imwrite(str(mask_path), mask):
        raise OSError(f"无法写入蒙版: {mask_path}")
    if not cv2.imwrite(str(foreground_path), transparent):
        raise OSError(f"无法写入透明前景: {foreground_path}")
    if not cv2.imwrite(str(composite_path), composite):
        raise OSError(f"无法写入合成图: {composite_path}")

    coverage = float(np.mean(alpha >= 0.5) * 100.0)
    print(f"人物覆盖率: {coverage:.1f}%")
    print(f"灰度蒙版: {mask_path}")
    print(f"透明前景: {foreground_path}")
    print(f"背景合成: {composite_path}")
    return 0

if __name__ == "__main__":
    raise SystemExit(main())
运行程序:
python portrait_composite.py --input portrait.jpg --background background.jpg --output-dir output --iterations 5 --feather 9预期输出如下,覆盖率取决于人物在画面中的占比。
人物覆盖率: <RATIO>%
灰度蒙版: output/mask.png
透明前景: output/foreground.png
背景合成: output/composite.jpg验收时应同时打开三份文件:mask.png 用于检查孔洞和噪点,foreground.png 用于检查 Alpha 是否真实存在,composite.jpg 用于检查边缘在新背景上是否出现白边、黑边或过度模糊。
边缘质量与练习
发丝处理的关键不是无限增加羽化,而是让模型保留细小前景概率,再使用较小半径完成边缘过渡。粗掩码已经删除的发丝无法通过模糊恢复;此时应更换具备头发类别或抠图能力的模型,或增加高分辨率局部推理。手指、耳饰和透明纱料也应采用同样的“先保留、后平滑”原则。
视频中若每帧独立阈值化,蒙版面积会随置信度轻微变化而闪烁。可对置信度图做时间平滑,或在人物移动较小时复用上一帧蒙版并进行光流对齐。平滑必须设上限,快速挥手或转身时应允许边缘及时变化,否则会产生拖影。
常见错误包括把 Alpha 反相导致背景被保留、在 uint8 上直接计算混合造成截断、把 RGB 与 BGR 通道顺序混用,以及用过大的闭运算连接本应分离的区域。排查顺序应固定为“看灰度蒙版、看透明前景、看浅色背景合成、看深色背景合成”,不要只检查最终一张图。
练习一:分别使用 --feather 3、9 和 21 生成结果,在浅色与深色背景上比较边缘。验收条件是能指出锯齿、自然过渡和光晕分别对应哪组参数,并选择适合当前分辨率的值。
练习二:用人物置信度图产生粗掩码并比较硬边;再试抠图模型的 Alpha,直接接入合成步骤,比较发丝、半透明区域和边缘残色。输入应包含发丝和抬起的手指;验收条件是透明前景保留细小结构,内部无明显孔洞,连续 30 帧的蒙版边缘没有高频闪烁。
本课总结
- 分割结果只是起点,真正用于合成的是经过清理和边缘优化的软透明蒙版。
- 发丝质量取决于前景信息是否在模型输出阶段被保留,后处理不能恢复已经丢失的结构。
- 灰度蒙版、透明前景和双背景合成应分别验收,才能定位通道、边缘和颜色污染问题。
下一课预告
下一阶段将继续把人脸与人像资产接入数字人驱动链路,重点关注素材规范、时序稳定性和合成输出的一致性,使静态处理结果能够可靠地扩展到连续视频。