
AI 内容创作 / 系统课时
自动语音识别工作原理
自动语音识别工作原理
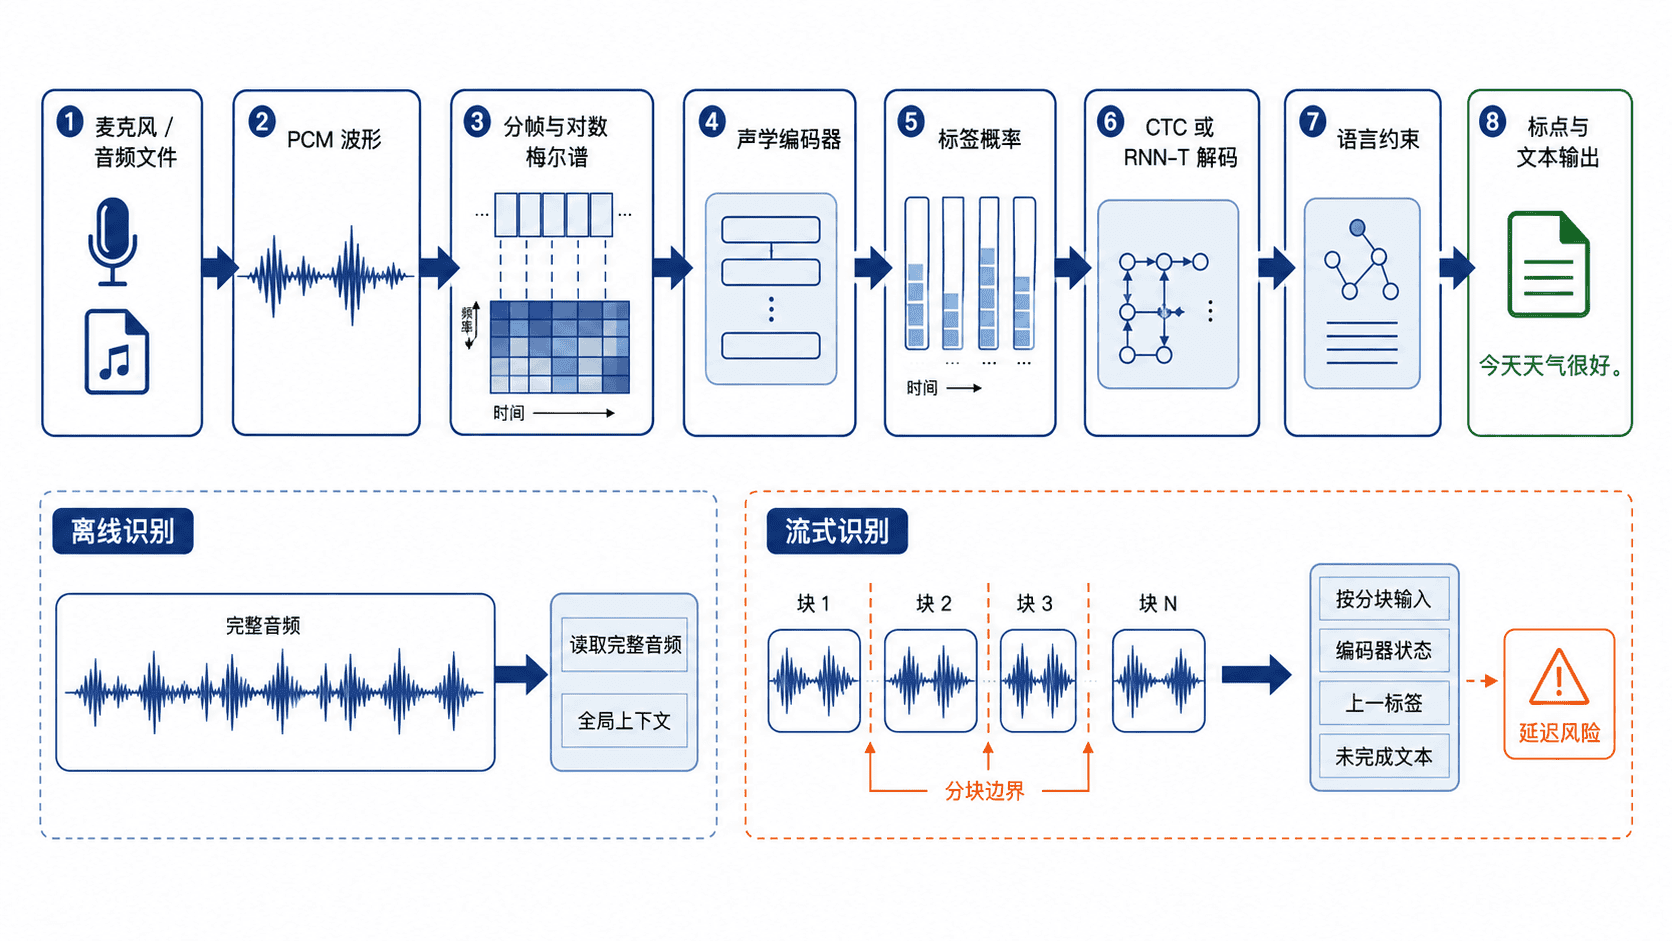
自动语音识别把连续声波转换为可读文本。本课从音频输入、声学表示、模型编码、解码到文本后处理梳理完整链路,并用一个可运行的 CTC 折叠示例说明离线识别与流式识别为什么需要不同的状态管理。
学习目标
- 说明自动语音识别从波形到文本的主要处理阶段。
- 理解 CTC、解码器与语言约束在文本生成中的作用。
- 比较离线识别和流式识别在上下文、延迟与状态管理上的差异。
识别链路与核心表示
识别系统首先接收采样率、声道数和位深明确的 PCM 音频。音频通常被切成 10~30 ms 的短帧,再转换为对语音频谱更稳定的对数梅尔谱;部分端到端模型也会直接学习波形前端。编码器随后把每帧映射为高层声学表示,并输出字符、子词或音素等标签的概率。
解码阶段不是简单选择每帧概率最大的字符。CTC 将路径中的连续相同标签先折叠,再去除空白标签。空白分隔的同一标签应保留两次。贪心选择的最优单一路径也未必对应概率最高的转写,后者可由多条路径共同贡献概率。RNN-T 会结合历史输出逐步预测;带语言模型的解码器还会综合声学分数、语言概率、热词和业务约束。最后再进行标点恢复、数字规范化、敏感词处理和时间戳对齐。
从计算量看,帧数记为 时,大多数编码器的基础成本会随 增长;采用全局自注意力的模型还可能产生接近 的时间与显存开销。流式模型通过限制右侧上下文、缓存历史状态或采用分块注意力,换取更低延迟和更稳定的内存占用。
离线识别与流式识别
| 比较项 | 离线识别 | 流式识别 |
|---|---|---|
| 输入方式 | 完整音频一次提交 | 连续接收固定时长分块 |
| 可用上下文 | 可观察整段前后文 | 取决于模型的历史缓存和允许的有限向前观察 |
| 首字延迟 | 通常较高 | 通常较低 |
| 文本稳定性 | 结束后一次定稿 | 中间结果可能被修订 |
| 典型场景 | 录音转写、字幕生成 | 实时对话、数字人交互 |
流式识别最容易出错的地方是分块边界。编码器缓存、CTC 上一标签、解码器前缀和时间戳偏移都必须跨块保留;如果每个块都从空状态开始,同一个词可能被重复输出,跨块音节也可能被截断。工程上还要配合语音活动检测决定何时开始送入音频、何时提交最终文本。
最小可运行示例
下面的程序不加载真实声学模型,而是使用一组已经得到的逐帧最优标签,完整演示 CTC 贪心解码。逐帧记录上一个原始标签。若当前标签是非空白且不同于前一标签,就输出它。空白虽然不输出,也必须更新前一标签。
BLANK = "<blank>"

def decode_chunk(labels, previous_label=BLANK):
    """解码一个分块,并返回跨块需要保留的上一标签。"""
    output = []
    for label in labels:
        if label != BLANK and label != previous_label:
            output.append(label)
        previous_label = label
    return "".join(output), previous_label

frame_labels = ["你", "你", BLANK, "好", "好", BLANK, "吗"]

offline_text, _ = decode_chunk(frame_labels)
print("逐帧最优标签:", " ".join(frame_labels))
print("离线解码:", offline_text)

# 流式解码必须把上一帧标签传给下一个分块。
chunks = [frame_labels[:1], frame_labels[1:4], frame_labels[4:]]
stream_parts = []
state = BLANK

for index, chunk in enumerate(chunks, start=1):
    text, state = decode_chunk(chunk, state)
    stream_parts.append(text)
    print(f"流式块 {index}: {text or '<无新增字符>'}")

print("流式拼接:", "".join(stream_parts))
print("空白分隔重复字:", decode_chunk(["哈", BLANK, "哈"])[0])
将代码保存为 asr_ctc_demo.py,运行命令如下。
python asr_ctc_demo.py预期输出
逐帧最优标签: 你 你 <blank> 好 好 <blank> 吗
离线解码: 你好吗
流式块 1: 你
流式块 2: 好
流式块 3: 吗
流式拼接: 你好吗
空白分隔重复字: 哈哈这个示例展示了流式解码的最小状态:previous_label。真实系统还会保存编码器缓存、语言模型状态、候选路径和时间戳,因此不能只把每个音频块独立送入同一个离线接口。
工程边界与排查
输入格式错误往往比模型本身更常见。采样率声明与真实数据不一致会改变语速和频谱位置;立体声直接交错读取会破坏波形;削波、过低响度和长时间背景噪声都会降低声学特征质量。进入模型前应统一采样率、声道、样本格式和响度范围,并记录原始参数。
当流式结果出现重复字或漏字时,应按“音频分块是否连续、状态是否跨块保存、终点是否过早触发、解码前缀是否重复拼接”的顺序排查。中间结果只能视为暂定文本,下游需要不可变转写时,以识别协议的最终事件为准。VAD 的终点只能触发刷新,不等于识别器已经提交最终文本。
本课总结
- 自动语音识别由音频规范化、声学表示、模型编码、解码和文本后处理共同完成。
- CTC 解码必须处理空白标签、重复标签和跨分块状态,不能把逐帧标签直接拼接。
- 离线识别追求全局准确率,流式识别则要在延迟、上下文和结果稳定性之间权衡。
下一课预告
下一课将学习“语音活动检测”,用帧级判定区分语音与静音,并通过起止阈值、最短语音长度和尾部静音等待时间控制实时识别的输入边界。