
AI 内容创作 / 系统课时
开发硬件与性能预算
开发硬件与性能预算
数字人链路能否稳定运行,取决于算力、显存、内存、采集设备和网络是否共同满足目标帧率与延迟。本课将把业务指标转换为可测的资源预算,并用一个可运行脚本计算单帧时间、显存下限和性能余量。
学习目标
- 将目标帧率、端到端延迟和并发量转换为硬件与网络预算。
- 理解 CPU、GPU、显存、内存、摄像头、麦克风和带宽在链路中的职责。
- 使用统一测试方法验证端侧与云端部署是否满足验收门槛。
性能预算的组成
数字人系统通常包含采集、语音处理、对话生成、语音合成、动作驱动、渲染、编码和传输。预算不能只看单个模型速度,而要计算串行阶段的总延迟、并行阶段的峰值资源,以及长时间运行后的温度、缓存和内存波动。
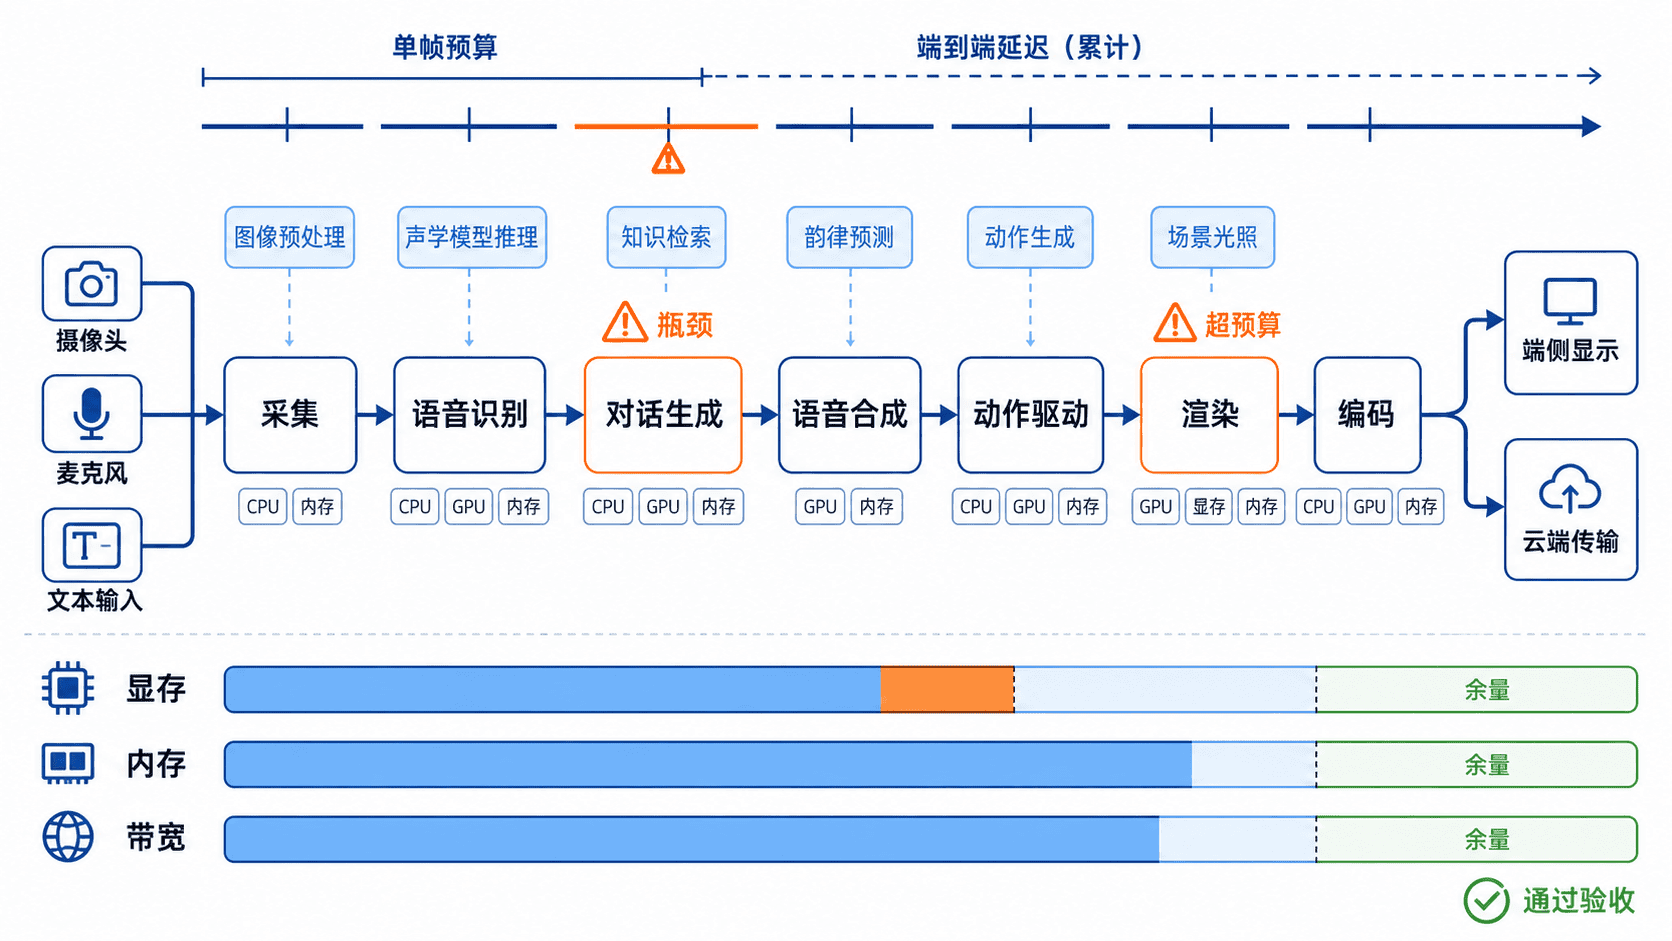
目标帧率决定渲染阶段的单帧上限。30 FPS 的理论单帧预算约为 33.33 ms,60 FPS 约为 16.67 ms。端到端对话延迟则包含网络往返、模型推理、语音合成、缓冲与播放,不能用单帧时间替代。
| 资源 | 主要职责 | 常见瓶颈信号 | 验证方式 |
|---|---|---|---|
| CPU | 音视频采集、解码、调度、部分推理 | 单核长期满载、音频断续 | 记录各线程占用与处理队列长度 |
| GPU | 模型推理、动画计算、实时渲染 | 帧时间抖动、推理排队 | 分别测量推理时间与渲染时间 |
| 显存 | 模型权重、激活、纹理、帧缓冲 | 加载失败、频繁换页、速度骤降 | 记录峰值占用并保留安全余量 |
| 内存 | 音视频缓冲、模型缓存、业务进程 | 长时运行后交换或崩溃 | 进行持续压测并观察峰值 |
| 摄像头 | 人脸、姿态或背景采集 | 曝光波动、拖影、帧率不足 | 固定光照后检查实际采集帧率 |
| 麦克风 | 语音识别与唇形驱动输入 | 噪声触发、丢字、延迟漂移 | 在目标环境测试信噪比与丢包 |
| 网络 | 云端推理、流媒体与控制信令 | 首帧慢、卡顿、重连 | 测量上行、下行、抖动与丢包 |
建立端侧预算
端侧预算应先确定目标,再分配余量。建议把平均负载控制在可持续范围,不要以短时间峰值作为稳定能力。显存预算至少要覆盖模型权重、运行时工作区、纹理与帧缓冲,并额外保留安全空间,避免分辨率变化或并发任务触发内存不足。
下面的 Python 脚本把单帧串行阶段与显存构成汇总为最小预算报告,同时单独核对整轮响应延迟。单帧阶段只包含每一帧重复执行的动画、渲染和编码等工时;语音识别和对话生成应进入端到端链路。它是可运行的估算工具,实际项目仍需用目标模型、素材和设备进行基准测试。
from dataclasses import dataclass
from math import isfinite

@dataclass(frozen=True)
class PerformanceBudget:
    target_fps: int
    frame_stage_ms: tuple[float, ...]
    reply_p95_ms: float
    reply_limit_ms: float
    model_weights_gb: float
    runtime_workspace_gb: float
    render_buffers_gb: float
    safety_margin_gb: float

def build_report(budget: PerformanceBudget) -> None:
    if budget.target_fps <= 0 or budget.reply_limit_ms <= 0 or not budget.frame_stage_ms:
        raise ValueError("目标帧率、回复延迟上限和帧阶段必须有效")
    values = (*budget.frame_stage_ms, budget.reply_p95_ms, budget.reply_limit_ms,
              budget.model_weights_gb, budget.runtime_workspace_gb,
              budget.render_buffers_gb, budget.safety_margin_gb)
    if any(not isfinite(value) or value < 0 for value in values):
        raise ValueError("时间和显存须为有限的非负数")
    frame_budget_ms = 1000 / budget.target_fps
    serial_latency_ms = sum(budget.frame_stage_ms)
    latency_headroom_ms = frame_budget_ms - serial_latency_ms
    required_vram_gb = (
        budget.model_weights_gb
        + budget.runtime_workspace_gb
        + budget.render_buffers_gb
        + budget.safety_margin_gb
    )

    frame_ok = latency_headroom_ms >= 0
    reply_ok = budget.reply_p95_ms <= budget.reply_limit_ms
    print(f"目标帧率: {budget.target_fps} FPS")
    print(f"单帧预算: {frame_budget_ms:.2f} ms")
    print(f"单帧串行估算: {serial_latency_ms:.2f} ms")
    print(f"单帧余量: {latency_headroom_ms:.2f} ms")
    print(f"端到端回复 p95: {budget.reply_p95_ms:.0f} ms,上限 {budget.reply_limit_ms:.0f} ms")
    print(f"建议显存下限: {required_vram_gb:.2f} GB")
    print(f"帧工时: {'通过' if frame_ok else '超限'};响应时延: {'通过' if reply_ok else '超限'}")

if __name__ == "__main__":
    budget = PerformanceBudget(
        target_fps=30,
        frame_stage_ms=(5.5, 3.0, 6.5, 8.0),
        reply_p95_ms=860,
        reply_limit_ms=700,
        model_weights_gb=6.0,
        runtime_workspace_gb=1.5,
        render_buffers_gb=1.0,
        safety_margin_gb=1.5,
    )
    build_report(budget)
运行命令:
python performance_budget.py预期输出:
目标帧率: 30 FPS
单帧预算: 33.33 ms
单帧串行估算: 23.00 ms
单帧余量: 10.33 ms
端到端回复 p95: 860 ms,上限 700 ms
建议显存下限: 10.00 GB
帧工时: 通过;响应时延: 超限
示例中单帧预算有余量,整轮回应仍然超过上限。流水线允许帧间重叠时,整帧延迟、连续产帧间隔与共享资源排队都要分别测量。端到端 p95 应从每次完整请求的测量值求出,不能将各阶段各自的 p95 简单相加。显存相加是初估,实测要包含模型并发、分配器、上下文和渲染缓冲峰值。
云端与网络预算
云端部署把部分算力压力转移到服务器,但增加了网络与并发管理。端到端延迟可以拆为上行传输、排队、推理、下行传输和播放缓冲。任何一个阶段波动,都可能让声音、口型和画面失去同步。
带宽按方向估算,可用“单路设计峰值码率 × 并发路数 × 安全系数”。如每路下行 2 Mb/s、10 路、系数 1.25,得到 25 Mb/s 的初步下行预算;上行和网络共享另算。安全系数用于覆盖码率波动、协议开销和重传。部署前应分别测试稳定带宽、往返时延、抖动和丢包,因为高带宽并不代表低延迟。
摄像头预算应关注实际帧率、快门、曝光、低照度噪声和接口稳定性;麦克风预算应关注信噪比、回声消除、采样稳定性与多设备时钟漂移。设备参数达到标称值并不代表链路可用,必须在真实光照、距离、背景噪声和网络条件下联合验证。
最终验收至少记录平均帧率、最低帧率、高分位端到端延迟、GPU 峰值、显存峰值、内存峰值、网络抖动、丢包率和连续运行时长。端侧适合低延迟、离线或隐私敏感场景;云端适合集中管理、弹性扩缩和高算力模型;混合部署则需要明确哪些阶段必须本地完成。
本课总结
- 性能预算必须覆盖整条数字人链路,不能只比较 GPU 型号或模型平均速度。
- 帧率、端到端延迟、显存容量、网络抖动和长时稳定性需要分别测量。
- 端侧、云端与混合部署应依据隐私、延迟、并发和维护成本共同决策。
下一课预告
下一阶段将继续把系统认知转化为可运行工程,重点关注开发环境、依赖组件、输入输出链路与基准测试方法,逐步建立可重复验证的数字人开发流程。