
AI 内容创作 / 系统课时
记忆与用户画像
记忆与用户画像
对话系统只有在“记住什么、保存多久、何时删除”都可控时,用户画像才会真正提升体验。本课将把短期上下文与长期记忆拆开,设计提取、写入、检索、更新和删除流程,并通过置信度、冲突处理和审计记录避免错误记忆持续累积。
学习目标
- 区分会话上下文、长期记忆与用户画像的职责边界
- 设计可回滚的记忆写入、检索、更新和删除机制
- 使用最小可运行代码验证记忆冲突与低置信度过滤
记忆分层与边界
短期上下文服务于当前会话,通常保存最近若干轮消息、当前任务状态和临时变量。它强调时效性,会随着窗口滑动而淘汰。长期记忆保存跨会话仍有价值的信息,例如稳定偏好、已确认身份信息和长期目标,但必须经过明确提取与校验。
用户画像是对长期记忆的结构化视图,而不是原始对话的永久副本。画像字段应尽量稳定、可解释、可删除,例如 preferred_language、response_style 和 project_goal。情绪、临时计划和未经确认的推断不应直接写入长期画像。
| 数据类型 | 典型内容 | 建议保留时间 | 写入要求 |
|---|---|---|---|
| 短期上下文 | 当前任务、最近消息、临时参数 | 分钟到小时 | 自动写入,可随会话淘汰 |
| 长期记忆 | 稳定偏好、长期目标、已确认事实 | 天到长期 | 需要置信度与来源 |
| 用户画像 | 聚合后的结构化字段 | 持续更新 | 必须可解释、可删除 |
记忆生命周期
一个可靠的记忆系统至少包含六步:候选提取、敏感性检查、规范化、冲突判断、持久化和检索。删除不是附加功能,而是生命周期中的正式动作;用户撤回授权、事实失效或记录被判定错误时,都必须能够按键值或来源删除。
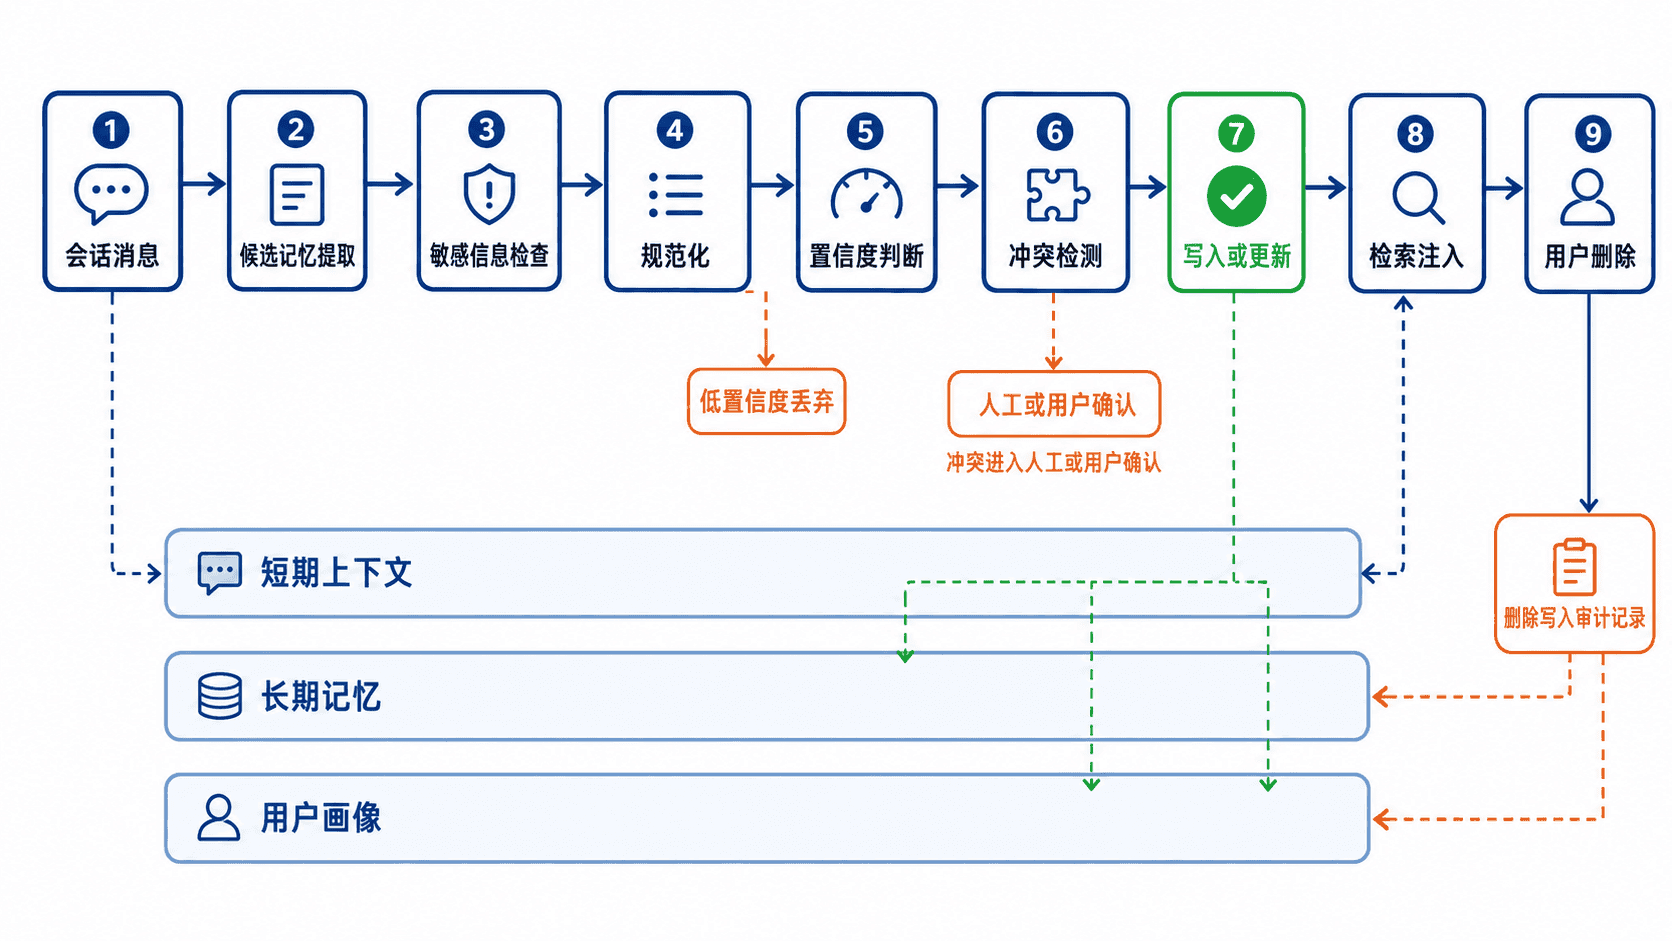
检索阶段不应把所有记忆都塞回提示词。可先按用户标识过滤,再按主题、时间和置信度排序,最后限制返回条数。这样既降低上下文噪声,也减少旧信息覆盖新事实的风险。
最小可运行实现
下面的 Python 示例使用内存字典模拟长期记忆。每条记录包含值、置信度、来源和版本号;低置信度记录会被拒绝,同一字段优先采用用户明确确认的值,同来源等级才按分值更新;用户再次明确确认时,以新选择为准。
from dataclasses import dataclass
from math import isfinite
from typing import Dict, List

@dataclass
class MemoryItem:
    value: str
    confidence: float
    source: str
    version: int = 1

class MemoryStore:
    def __init__(self) -> None:
        self._data: Dict[str, Dict[str, MemoryItem]] = {}

    def upsert(
        self,
        user_id: str,
        key: str,
        value: str,
        confidence: float,
        source: str
    ) -> str:
        if not isfinite(confidence) or not 0 <= confidence <= 1:
            return f"rejected:{key}:invalid-confidence"
        if confidence < 0.70:
            return f"rejected:{key}:low-confidence"

        profile = self._data.setdefault(user_id, {})
        current = profile.get(key)

        if current is None:
            profile[key] = MemoryItem(value, confidence, source)
            return f"created:{key}={value}"

        confirmed = source == "user-confirmed"
        old_confirmed = current.source == "user-confirmed"
        if not confirmed and (old_confirmed or confidence <= current.confidence):
            action = "confirmed" if current.value == value else "kept"
            return f"{action}:{key}={current.value}"
        if (value, confidence, source) == (current.value, current.confidence, current.source):
            return f"confirmed:{key}={current.value}"

        profile[key] = MemoryItem(
            value=value,
            confidence=confidence,
            source=source,
            version=current.version + 1
        )
        return f"updated:{key}={value}"

    def retrieve(self, user_id: str, min_confidence: float = 0.70) -> List[str]:
        profile = self._data.get(user_id, {})
        return [
            f"{key}={item.value} (v{item.version})"
            for key, item in sorted(profile.items())
            if item.confidence >= min_confidence
        ]

    def delete(self, user_id: str, key: str) -> bool:
        profile = self._data.get(user_id, {})
        return profile.pop(key, None) is not None

def main() -> None:
    store = MemoryStore()
    user_id = "user-001"

    print(store.upsert(user_id, "preferred_language", "中文", 0.95, "user-confirmed"))
    print(store.upsert(user_id, "preferred_language", "English", 0.60, "model-inferred"))
    print(store.upsert(user_id, "response_style", "简洁", 0.82, "user-message"))
    print(store.upsert(user_id, "response_style", "详细", 0.91, "user-confirmed"))

    print("profile:", store.retrieve(user_id))
    print("deleted:", store.delete(user_id, "preferred_language"))
    print("profile:", store.retrieve(user_id))

if __name__ == "__main__":
    main()
运行方式
将代码保存为 memory_profile_demo.py,然后执行:
python memory_profile_demo.py预期输出
created:preferred_language=中文
rejected:preferred_language:low-confidence
created:response_style=简洁
updated:response_style=详细
profile: ['preferred_language=中文 (v1)', 'response_style=详细 (v2)']
deleted: True
profile: ['response_style=详细 (v2)']
示例中的字典只用于演示规则。生产环境通常还需要数据库持久化、字段加密、租户隔离、访问审计和过期策略,但这些能力都应建立在同一组生命周期约束之上。
工程保护与练习
写入前应先判断内容是否敏感、是否由用户明确提供、是否会在未来仍然有用。对身份证件、健康信息、支付信息等高风险数据,应默认不写入;对模型推断出的偏好,按风险决定是否允许作为候选,并支持用户更正。示例中的分数是业务启发值,不是经过校准的概率。user-confirmed 来源应由受控交互产生,不能由模型或客户端自报。
调试时记录字段类型、拒绝原因、最终动作和来源编号,尽量避免记录具体值。源记录的删除和用户撤回还要同步到派生画像、检索索引与缓存。检索结果也应带来源和版本,便于发现旧记录为何被召回。
练习 1:为 MemoryStore 增加 expires_at 过期时间。验收条件是过期记录不会出现在 retrieve() 的返回值中。
练习 2:增加按来源删除的能力。输入用户标识和来源后,应删除该来源写入的全部记录,并返回删除数量。
本课总结
- 短期上下文解决当前任务,长期记忆保存跨会话价值,用户画像负责结构化呈现
- 可靠记忆必须覆盖提取、校验、冲突处理、检索、更新和删除完整生命周期
- 低置信度过滤、版本号、来源记录和审计日志是防止错误记忆累积的关键保护
下一课预告
下一课将学习“工具调用与内容安全”,把模型输出限制为可验证的结构化请求,并在执行前加入参数校验、权限控制和安全兜底。