
AI 内容创作 / 系统课时
离线语音识别接入
离线语音识别接入
本课把本地语音模型封装成稳定的离线识别服务:读取当前解码器支持的音频,统一解码为单声道 16 kHz 浮点样本,执行语音活动检测与模型推理,再输出文本、分段时间戳、词级时间戳和语言信息。完成后,该接口可直接接入数字人的字幕、语义理解与日志链路。
学习目标
- 设计与具体模型解耦的离线 ASR 输入、输出契约。
- 完成音频标准化、模型推理、时间戳提取和结果校验。
- 使用标准 JSON 保存可供后续模块消费的识别结果。
接入设计与处理链路
离线识别适合录制文件、批量素材和不允许上传云端的场景。接口不应只返回一段字符串,而应同时保留分段边界、词级时间戳、语言置信度和最终状态。这样,字幕生成可以使用时间轴,语义模块可以读取纯文本,排错日志也能定位到具体音频区间。
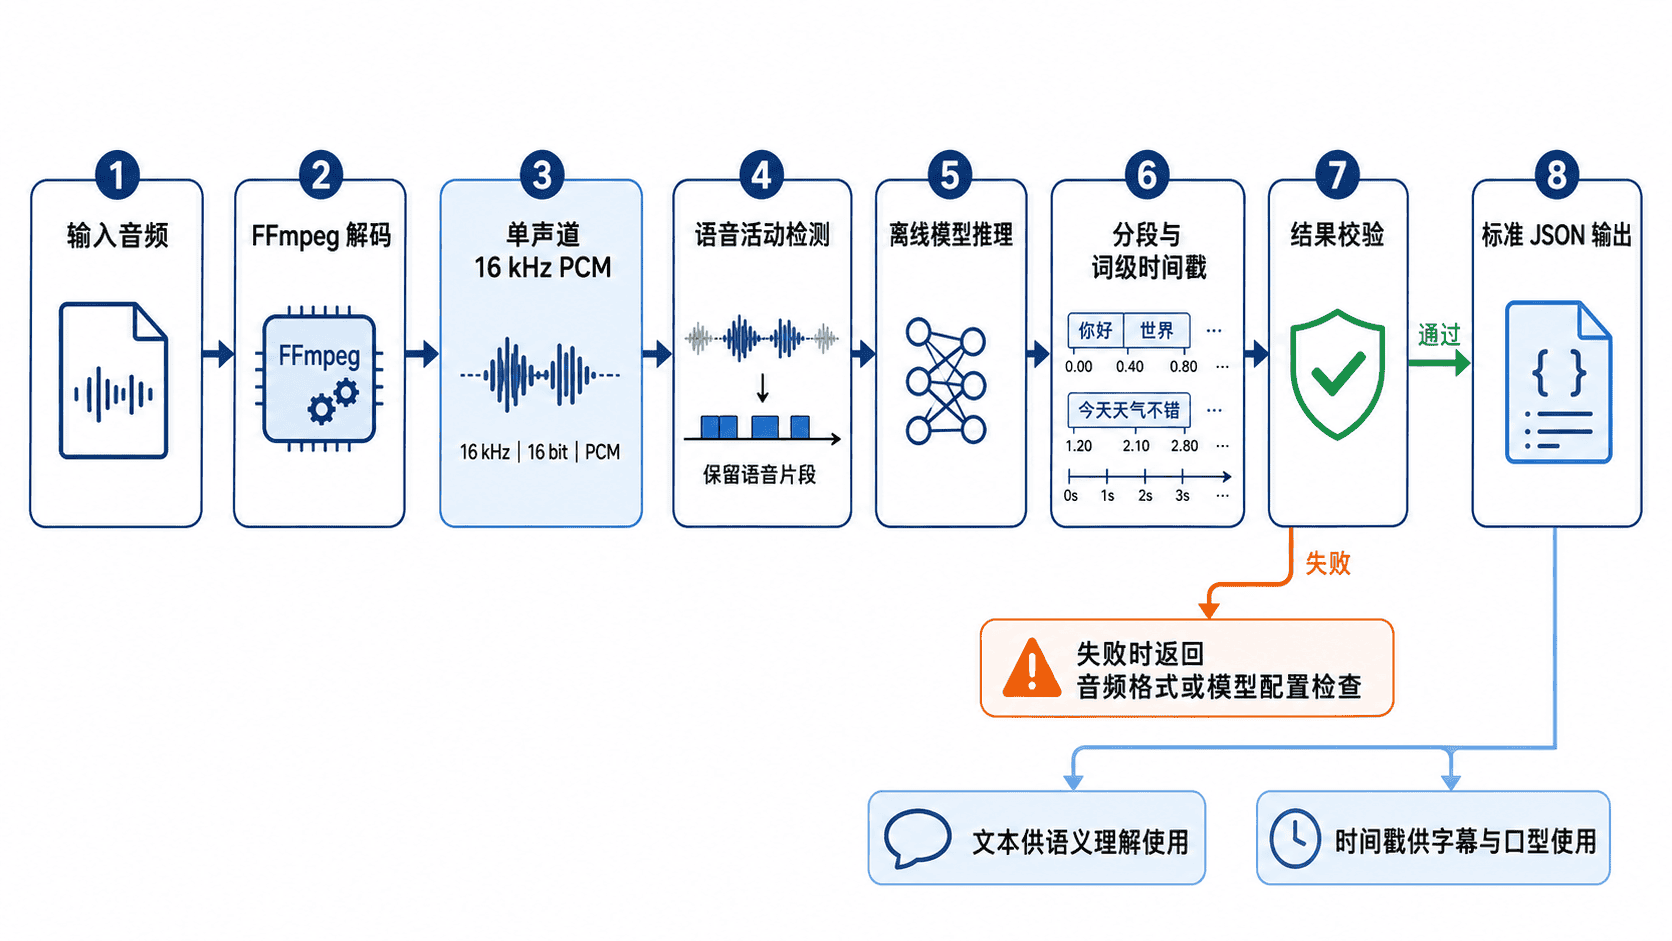
预处理阶段统一采样率、声道数和编码格式,避免模型后端分别处理 MP3、AAC、浮点 WAV 等差异。推理阶段启用 VAD 过滤长静音,并请求词级时间戳。标准化阶段将模型对象转成普通字典,同时检查 start <= end、时间非负以及片段顺序单调。
建议固定以下输出字段,并额外记录样本总时长、识别状态及时间轴定义。
| 字段 | 含义 | 后续用途 |
|---|---|---|
text |
合并后的最终文本 | 语义理解、检索、日志 |
segments |
片段文本与起止时间 | 字幕切分、问题定位 |
words |
可选的词级时间戳与模型分数 | 精细字幕、口型对齐 |
language |
检测或指定语言 | 路由多语言模型 |
isFinal |
是否为最终结果 | 区分离线结果与流式中间结果 |
完整可运行示例
用 Python 3.11 虚拟环境安装 python -m pip install faster-whisper==1.2.1。示例要求本地 CTranslate2 模型目录,含 model.bin、config.json 和 tokenizer.json。准备阶段可按模型卡从可信来源预下载,并记录版本和许可。运行阶段不接受仓库名,也不回退到在线 tokenizer。测试只使用获准录音或合成语音,明确录音和输出文本的留存用途。
将代码保存为 offline_asr.py。
import argparse
import json
import math
from pathlib import Path

from faster_whisper import WhisperModel
from faster_whisper.audio import decode_audio

RATE = 16000
REQUIRED = ("model.bin", "config.json", "tokenizer.json")


def local_model(path):
    if not path.is_dir() or any(not (path / name).is_file() for name in REQUIRED):
        raise ValueError("模型目录必须包含完整的本地权重、配置和 tokenizer")
    return WhisperModel(str(path.resolve()), device="cpu", compute_type="int8", local_files_only=True)


def valid_span(start, end, duration):
    return math.isfinite(start) and math.isfinite(end) and 0 <= start <= end <= duration + 0.08


def probability(value):
    if not math.isfinite(value) or not 0 <= value <= 1:
        raise ValueError("模型分数越界")
    return round(float(value), 4)


def transcribe_file(path, model, language=None):
    samples = decode_audio(str(path), sampling_rate=RATE)
    if samples.size == 0:
        raise ValueError("输入没有可解码的音频样本")
    duration = len(samples) / RATE
    stream, info = model.transcribe(
        samples, language=language, beam_size=5, vad_filter=True, word_timestamps=True,
    )
    segments, text_parts = [], []
    last_start = 0.0
    for segment in stream:
        if not valid_span(segment.start, segment.end, duration) or segment.start < last_start:
            raise ValueError("片段时间戳无效")
        last_start = segment.start
        words = []
        previous_word_start = segment.start - 0.08
        for word in segment.words or ():
            if (
                not valid_span(word.start, word.end, duration)
                or word.start < previous_word_start
                or word.end > segment.end + 0.08
            ):
                raise ValueError("词级时间戳无效")
            previous_word_start = word.start
            words.append({
                "start": round(word.start, 3), "end": round(word.end, 3),
                "text": word.word, "probability": probability(word.probability),
            })
        text_parts.append(segment.text)
        segments.append({
            "start": round(segment.start, 3), "end": round(segment.end, 3),
            "text": segment.text.strip(), "words": words,
        })

    text = "".join(text_parts).strip()
    language_probability = (
        probability(info.language_probability) if info.all_language_probs else None
    )
    return {
        "engine": "faster-whisper", "isFinal": True,
        "status": "ok" if text else "no_text", "text": text,
        "durationMs": round(duration * 1000), "language": info.language,
        "languageProbability": language_probability, "segments": segments,
    }


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--model", required=True, type=Path)
    parser.add_argument("--audio", required=True, type=Path)
    parser.add_argument("--output", required=True, type=Path)
    parser.add_argument("--language", default=None)
    args = parser.parse_args()
    if not args.audio.is_file():
        raise ValueError("输入必须是本地音频文件")
    result = transcribe_file(args.audio, local_model(args.model), args.language)
    with args.output.open("x", encoding="utf-8") as out:
        json.dump(result, out, ensure_ascii=False, indent=2, allow_nan=False)
    print(f"{result['status']}: {len(result['segments'])} 个片段")


if __name__ == "__main__":
    main()
示例命令。目录和音频路径换成实际值。英语单语模型使用 --language en,中文输入应选兼容的多语模型。
python offline_asr.py --model ./models/whisper --audio ./test.wav --language en --output result.json输出为 ok: N 个片段 或 no_text: N 个片段。no_text 表示此次没有返回文本,还需区分 VAD 未保留音频、输入失真或识别器漏识别。模型库通过 PyAV 解码,课堂只处理小型本地文件。实际接入应在解码前检查媒体大小、允许格式和时长预算。
时间戳以本次解码音频的起点为基准,VAD 过滤后会映射回该音频轴。示例允许 80 ms 的边缘估计余量,不把词时间当成采样级标签。durationMs 是解码样本总时长,最后一个词的结束只是最后识别位置。languageProbability 仅在返回了语言检测候选时保留,指定语言或固定语言模型可能为空。概率属于模型估计,未经校准时不可当作实际正确率。