
NoSQL 与搜索 / 系统课时
使用运维 API 建立集群基线
使用运维 API 建立集群基线
本课把 Elasticsearch 当前状态固化成一组可重复采集的基线文件。完成后,你能在任何调参、扩容或故障演练前记录集群、节点、索引与分片分配状态,并用同一套数据判断变更究竟让系统变好还是变差。
学习目标
- 区分 cluster、nodes、indices 与 allocation 信息各自回答的问题。
- 使用只读运维 API 一次性采集可比较的基线快照。
- 从健康状态、资源指标和未分配分片中提取后续调优线索。
基线要回答什么
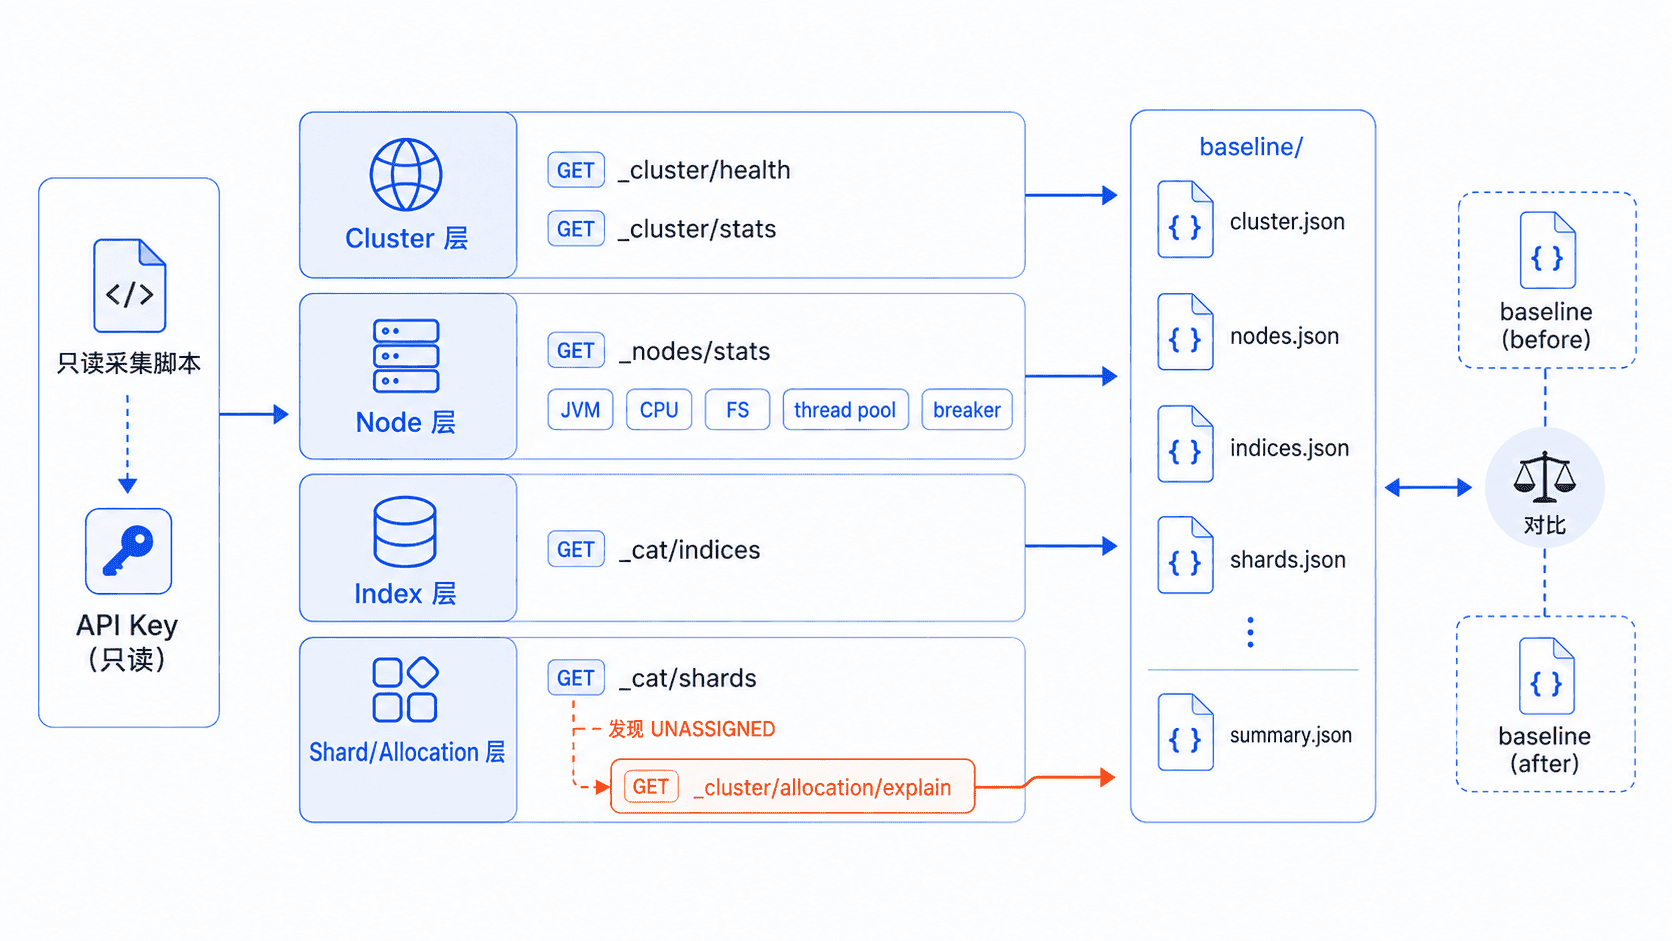
单看“集群是绿色”远远不够。_cluster/health 说明分片是否都已分配,_cluster/stats 给出节点、索引、文档与存储规模,_nodes/stats 展开到 JVM、CPU、文件系统、线程池、断路器和索引活动;索引与分片视图则用于回答“压力集中在哪里”。
当出现 UNASSIGNED 分片时,再调用 _cluster/allocation/explain 追问某个具体分片为什么不能分配。这样可以把“总体状态 → 节点资源 → 索引规模 → 分片原因”串成一条诊断链,而不是无目的地保存所有 API 响应。
准备采集环境
下面示例只依赖 curl、jq 和可访问 Elasticsearch 的终端。把地址和凭据放进环境变量,脚本中不要硬编码密钥。采集账号应只拥有读取集群监控信息和目标索引监控信息所需的权限。
export ES_URL="https://<HOST>:<PORT>"
export ELASTIC_API_KEY="<API_KEY>"
# 先用精简 health 请求验证地址、TLS 和权限是否可用。
curl -fsS -H "Authorization: ApiKey $ELASTIC_API_KEY" "$ES_URL/_cluster/health?filter_path=status,number_of_nodes,active_primary_shards,active_shards,unassigned_shards"
预期输出
{"status":"<STATUS>","number_of_nodes":<VALUE>,"active_primary_shards":<VALUE>,"active_shards":<VALUE>,"unassigned_shards":<VALUE>}<STATUS> 通常为 green、yellow 或 red,其余值取决于你的实验集群。这里先验证网络、TLS 与权限链路,确认成功后再做完整采集。
一次采集五类状态
将下面脚本保存为 collect_baseline.sh。它固定采集同一组 API,并把第一个未分配分片送入 allocation explain;若没有未分配分片,也会留下明确记录,因此两次基线的文件结构保持一致。
#!/usr/bin/env bash
set -euo pipefail

: "${ES_URL:?set ES_URL first}"
: "${ELASTIC_API_KEY:?set ELASTIC_API_KEY first}"

ES_URL="${ES_URL%/}"
OUT="${1:-baseline}"
mkdir -p "$OUT"

AUTH=(-H "Authorization: ApiKey $ELASTIC_API_KEY")
JSON=(-H "Content-Type: application/json")

# 所有 GET 请求走同一入口,避免各采集项使用不同认证参数。
get() {
  curl -fsS "${AUTH[@]}" "$ES_URL$1"
}

# 固定采集顺序和文件名,保证变更前后可以逐项比较。
get "/_cluster/health" > "$OUT/cluster-health.json"
get "/_cluster/stats" > "$OUT/cluster-stats.json"
get "/_nodes/stats/jvm,process,os,fs,indices,thread_pool,breaker,indexing_pressure" > "$OUT/nodes-stats.json"
get "/_cat/indices?format=json&bytes=b&h=health,status,index,pri,rep,docs.count,store.size,pri.store.size" > "$OUT/indices.json"
get "/_cat/shards?format=json&bytes=b&h=index,shard,prirep,state,node,unassigned.reason,store" > "$OUT/shards.json"

# allocation explain 只针对实际未分配的分片,避免无目标调用。
row="$(jq -r 'map(select(.state == "UNASSIGNED")) | first // empty | [.index,.shard,.prirep] | @tsv' "$OUT/shards.json")"
if [[ -n "$row" ]]; then
  read -r index shard prirep <<< "$row"
  primary=false
  [[ "$prirep" == "p" ]] && primary=true

  jq -n \
    --arg index "$index" \
    --argjson shard "$shard" \
    --argjson primary "$primary" \
    '{index:$index,shard:$shard,primary:$primary}' |
  curl -fsS -X POST "${AUTH[@]}" "${JSON[@]}" \
    --data-binary @- \
    "$ES_URL/_cluster/allocation/explain?include_disk_info=true" \
    > "$OUT/allocation-explain.json"
else
  printf '{"note":"no unassigned shard"}\n' > "$OUT/allocation-explain.json"
fi

# 额外生成紧凑摘要,便于先比较规模与总体健康状态。
jq -n \
  --slurpfile h "$OUT/cluster-health.json" \
  --slurpfile c "$OUT/cluster-stats.json" \
  '{
    cluster_status: $h[0].status,
    nodes: $c[0].nodes.count.total,
    indices: $c[0].indices.count,
    shards: $c[0].indices.shards.total,
    docs: $c[0].indices.docs.count,
    store_bytes: $c[0].indices.store.size_in_bytes
  }' | tee "$OUT/summary.json"
运行:
# 使用独立目录保存“变更前”快照,变更后换成 baseline-after。
chmod +x collect_baseline.sh
./collect_baseline.sh baseline-before
预期输出
{
  "cluster_status": "<STATUS>",
  "nodes": <VALUE>,
  "indices": <VALUE>,
  "shards": <VALUE>,
  "docs": <VALUE>,
  "store_bytes": <VALUE>
}
同时会生成 cluster-health.json、cluster-stats.json、nodes-stats.json、indices.json、shards.json、allocation-explain.json 和 summary.json。<VALUE> 随实验环境变化,但两次采集应保持文件集合与字段口径一致。
让基线真正可比较
基线是时间点快照,不是性能结论。变更前后应在相同数据规模、相近负载阶段和相同采集脚本下各取一次,例如把第二次结果写入 baseline-after,再比较节点 CPU/JVM、线程池拒绝、索引与搜索累计量、存储规模以及分片状态。
不要把 CAT API 的人类可读输出直接当长期监控协议;脚本已经用 JSON 格式保存它们,主要用于实验期检查索引和分片。真正自动化的健康采集应优先依赖稳定的结构化 REST API,并避免高频抓取体量很大的全量响应。
只要每次实验都先保存这套基线,再记录测试数据、负载参数和变更项,后续调优就能从“感觉更快”升级为可追溯的前后对比。