
NoSQL 与搜索 / 系统课时
使用 Node Shutdown API 迁移负载
使用 Node Shutdown API 迁移负载
Node Shutdown API 用“计划关闭”替代突然失联,让 Elasticsearch 在节点真正停止前处理 shard、persistent task 与插件相关清理。本课重点区分 restart、remove、replace 三种语义,并用状态 API 判断何时可以安全停进程。
学习目标
- 能根据临时重启、永久下线或一对一替换选择正确的 shutdown 类型
- 能注册 shutdown 计划并观察 shard 与 persistent task 的准备状态
- 能识别
COMPLETE、IN_PROGRESS、STALLED,避免把 API 调用成功误当成节点已经可停
先理解三种关闭语义
PUT /_nodes/{node_id}/shutdown 只登记并推进关闭准备,不会终止 Elasticsearch 进程。调用者需要 manage 集群权限;如果启用了 operator privileges,还必须具备 operator 身份。
三种类型解决的问题不同:
| 类型 | 适用场景 | shard 行为 |
|---|---|---|
restart |
短暂重启、升级或配置维护 | 预期节点会回来,因此不会为了重启主动把本地数据全部迁走,可设置 allocation_delay |
remove |
永久移除节点 | 在达到可关闭状态前把需要迁出的 shard 与任务转移到其他节点 |
replace |
用指定新节点一对一替换旧节点 | 将数据定向迁往 target_node_name,用于受控替换 |
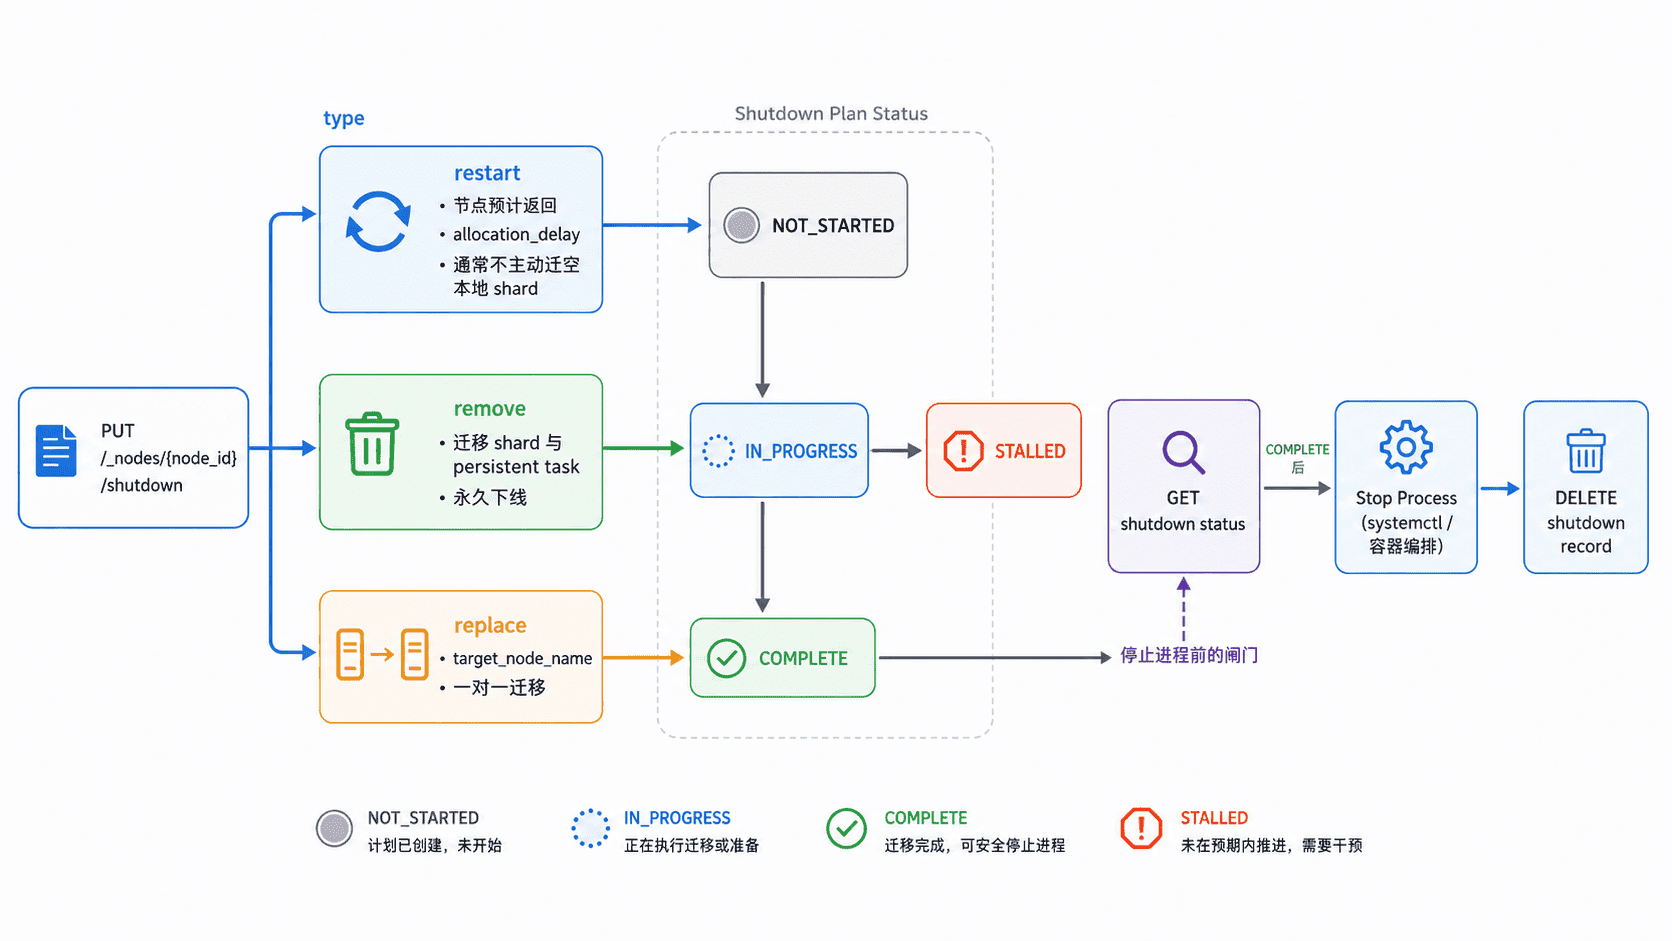
注册一个永久下线计划
下面演示 remove:先获取目标节点的完整 ID,再登记关闭计划。不要使用节点名替代 node_id 路径参数。
export ELASTICSEARCH_URL="https://es.example.com:9200"
export ELASTIC_API_KEY="<API_KEY>"
export NODE_ID="<ID>"

curl -sS -X PUT   -H "Authorization: ApiKey $ELASTIC_API_KEY"   -H "Content-Type: application/json"   "$ELASTICSEARCH_URL/_nodes/$NODE_ID/shutdown"   -d '{"type":"remove","reason":"planned hardware retirement"}'
预期输出
{"acknowledged":true}这个 acknowledged:true 只说明 shutdown 计划已经写入集群状态,不代表 shard 与任务已经迁移完毕,更不代表 Elasticsearch 进程已经停止。
用状态而不是时间判断能否停机
登记后查询该节点的 shutdown 状态。为避免输出过多字段,可以只保留总状态、shard migration 和 persistent task 状态。
curl -sS -H "Authorization: ApiKey $ELASTIC_API_KEY" "$ELASTICSEARCH_URL/_nodes/$NODE_ID/shutdown?filter_path=nodes.node_id,nodes.type,nodes.status,nodes.shard_migration.status,nodes.persistent_tasks.status"预期结果
{
  "nodes": [
    {
      "node_id": "<ID>",
      "type": "REMOVE",
      "status": "COMPLETE",
      "shard_migration": {
        "status": "COMPLETE"
      },
      "persistent_tasks": {
        "status": "COMPLETE"
      }
    }
  ]
}
实际准备过程中可能先出现 NOT_STARTED 或 IN_PROGRESS。如果状态变成 STALLED,不要继续停机,应结合返回中的 explanation、_cluster/allocation/explain、磁盘水位线、allocation filter、tier/awareness 约束与目标节点容量定位为何 shard 无处可去。
处理重启与一对一替换
短暂维护不要误用 remove。restart 允许通过 allocation_delay 告诉集群等待节点返回;一对一硬件替换则使用 replace 并指定目标节点名称。
curl -sS -X PUT -H "Authorization: ApiKey $ELASTIC_API_KEY" -H "Content-Type: application/json" "$ELASTICSEARCH_URL/_nodes/$NODE_ID/shutdown" -d '{"type":"restart","reason":"kernel maintenance","allocation_delay":"10m"}'预期输出
{"acknowledged":true}allocation_delay 只适用于 restart。若维护时间明显可能超过设定值,应重新评估延迟,而不是依赖节点永久离线后仍不重分配。replace 还需要 target_node_name,并且目标节点必须按替换计划准备好。
停止进程并清理 shutdown 记录
只有 shutdown status 达到符合计划的 COMPLETE 后,外部运维系统才负责真正停止节点。对于 systemd 自管主机,停止动作仍然是操作系统命令;API 本身不会执行它。
ssh <USER>@<NODE_HOST> 'sudo systemctl stop elasticsearch.service'

curl -sS -X DELETE   -H "Authorization: ApiKey $ELASTIC_API_KEY"   "$ELASTICSEARCH_URL/_nodes/$NODE_ID/shutdown"
预期输出
{"acknowledged":true}shutdown 记录不会因为节点离线而自动消失,因此在节点重新加入或永久离开后都要由负责该流程的平台显式清理。若使用 ECK、Elastic Cloud 等已经接管节点生命周期的环境,不要再并行写一套脚本抢着修改 shutdown 状态,否则控制器和人工动作可能互相覆盖。
Node Shutdown API 的价值在于把“能不能停节点”变成一个可观测状态,而不是固定等待若干分钟。真正安全的自动化应以 COMPLETE 为闸门,并在 STALLED 时停止流程、暴露原因,而不是继续执行 stop。