
NoSQL 与搜索 / 系统课时
监控 Thread Pool 与 Tasks
监控 Thread Pool 与 Tasks
线程池监控要回答两个不同的问题:请求是否已经排队或被拒绝,以及后台是否存在长期占用资源的任务。本课用 Thread Pool 统计识别拥塞,再用 Tasks API 找到具体执行者,形成从告警到定位的最短路径。
学习目标
- 正确解读
active、queue、rejected与completed,避免把“繁忙”误判成“拥塞”。 - 通过 Tasks API 找出长运行任务,并按
action区分交互请求与后台作业。 - 建立基于队列持续时间、拒绝增量和任务时长的告警与排查顺序。
用线程池指标区分忙和堵
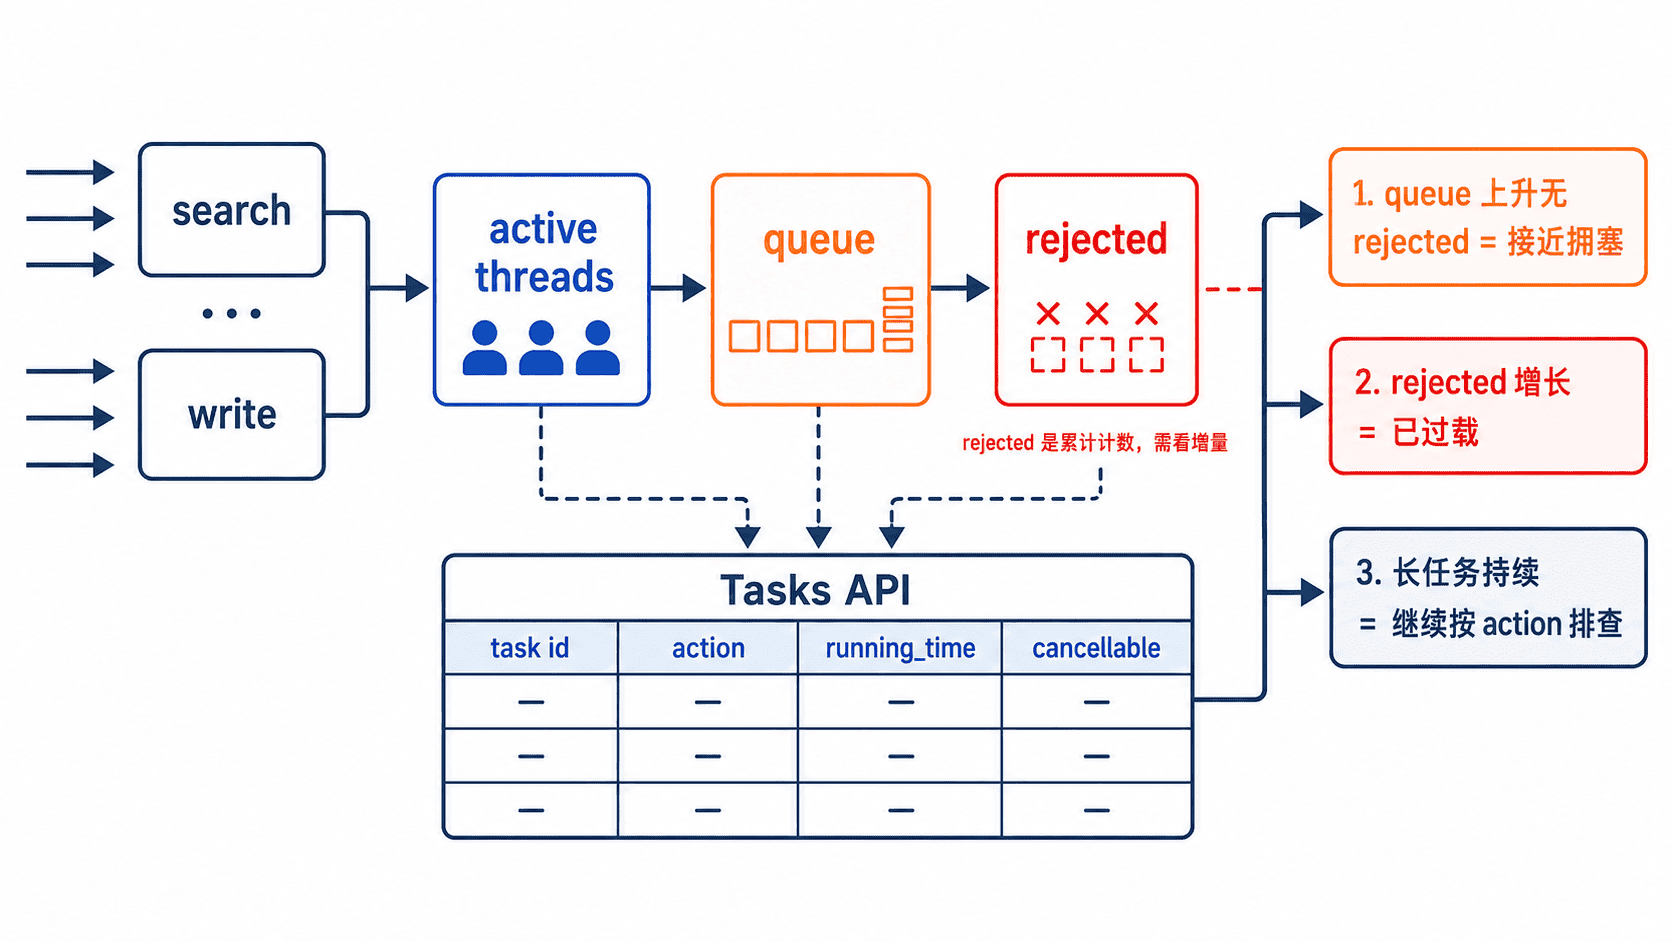
active 高只能说明线程池正在工作;真正需要告警的是队列持续堆积,或 rejected 在采样窗口内增长。rejected 与 completed 都是节点运行期间的累计计数,因此应监控增量,而不是总值。
请求进入固定或可伸缩线程池后,会先占用执行线程;固定线程池线程用满时才进入队列,队列也无法接收时才拒绝。Tasks API 则提供另一条视角:它告诉你哪些可观测任务正在执行以及已经运行多久。
采集关键 Thread Pool 状态
下面命令从所有节点读取线程池统计,并只展示常见请求路径相关的池。某些 Elasticsearch 版本可能没有 write_coordination,过滤表达式会自然忽略不存在的池。
curl --fail-with-body -sS \
  --cacert '<PATH>/http_ca.crt' \
  -u 'elastic:<PASSWORD>' \
  'https://<HOST>:9200/_nodes/stats/thread_pool?filter_path=nodes.*.name,nodes.*.thread_pool.*.active,nodes.*.thread_pool.*.queue,nodes.*.thread_pool.*.rejected,nodes.*.thread_pool.*.completed' \
| jq -r '
  .nodes[] as $node |
  $node.thread_pool |
  to_entries[] |
  select(.key | test("^(search|search_coordination|get|write|write_coordination)$")) |
  "node=\($node.name) pool=\(.key) active=\(.value.active) " +
  "queue=\(.value.queue) rejected=\(.value.rejected) completed=\(.value.completed)"
'
预期输出
node=es01 pool=search active=<VALUE> queue=<VALUE> rejected=<COUNT> completed=<COUNT>
node=es01 pool=write active=<VALUE> queue=<VALUE> rejected=<COUNT> completed=<COUNT>
node=es02 pool=search active=<VALUE> queue=<VALUE> rejected=<COUNT> completed=<COUNT>
一次 queue > 0 可能只是短突发;但队列连续多个采样周期不回落,说明到达速率已经超过处理速率。若同一窗口内 rejected 的增量大于 0,则说明请求已经越过线程池的可接受边界。
用 Tasks API 找出长期占用者
线程池只能告诉你“哪里堵”,Tasks API 用于继续回答“谁在跑”。detailed=true 会返回更丰富的任务描述,生产环境可先按 actions 收窄范围,避免在大型集群上拉取过多信息。
curl --fail-with-body -sS \
  --cacert '<PATH>/http_ca.crt' \
  -u 'elastic:<PASSWORD>' \
  'https://<HOST>:9200/_tasks?detailed=true&group_by=nodes&human=true' \
| jq -r '
  .nodes[]? |
  (.tasks // {}) |
  to_entries[] |
  (.value.description // "-") as $description |
  "task=\(.key) action=\(.value.action) running=\(.value.running_time) " +
  "cancellable=\(.value.cancellable) description=\($description)"
'
预期输出
task=<TASK_ID> action=<ACTION> running=<DURATION> cancellable=<BOOLEAN> description=<DESCRIPTION>
task=<TASK_ID> action=<ACTION> running=<DURATION> cancellable=<BOOLEAN> description=<DESCRIPTION>
长时间运行不等于异常。Reindex、snapshot、recovery 一类后台任务本来就可能持续很久;交互式 search 若显著超过自身历史 P99,才更值得立即调查。先看 action、持续时间和业务影响,再决定是否需要取消可取消任务。
建立从告警到定位的顺序
线程池告警可以从三层开始:队列连续 3~5 分钟高于正常基线作为预警;任意 5 分钟窗口出现 rejected 增量作为明确过载信号;交互型任务运行时间超过该类操作历史 P99 的 2~3 倍时触发长任务告警。后台任务应建立独立阈值,不能和在线搜索共用同一时长标准。
告警触发后先确认是单节点还是全局,再看具体线程池的 queue 与 rejected 增量,最后用 Tasks API 锁定长运行 action。这条顺序能避免只看一个大数字就调线程池参数,也能把“容量不足”和“某个任务拖住资源”快速分开。