
NoSQL 与搜索 / 系统课时
配置 Allocation Awareness
配置 Allocation Awareness
本课解决“节点很多但主副分片仍可能落在同一机架或可用区”的问题。你将给节点标记故障域,启用 Allocation Awareness,并进一步决定是否使用 Forced Awareness,让整个可用区失效时的副本行为符合容量与可用性预期。
学习目标
- 能使用节点属性和集群设置把分片副本分散到不同故障域
- 理解普通 awareness 与 forced awareness 在整域故障时的行为差异
- 能通过分片列表和 allocation explain 验证、排查跨域分配结果
把故障域变成分片约束
Elasticsearch 本来就不会把同一分片的 primary 与 replica 放到同一个节点,但“不同节点”不等于“不同故障域”。如果两台节点位于同一机架或同一可用区,一次机架断电仍可能同时带走两份数据。
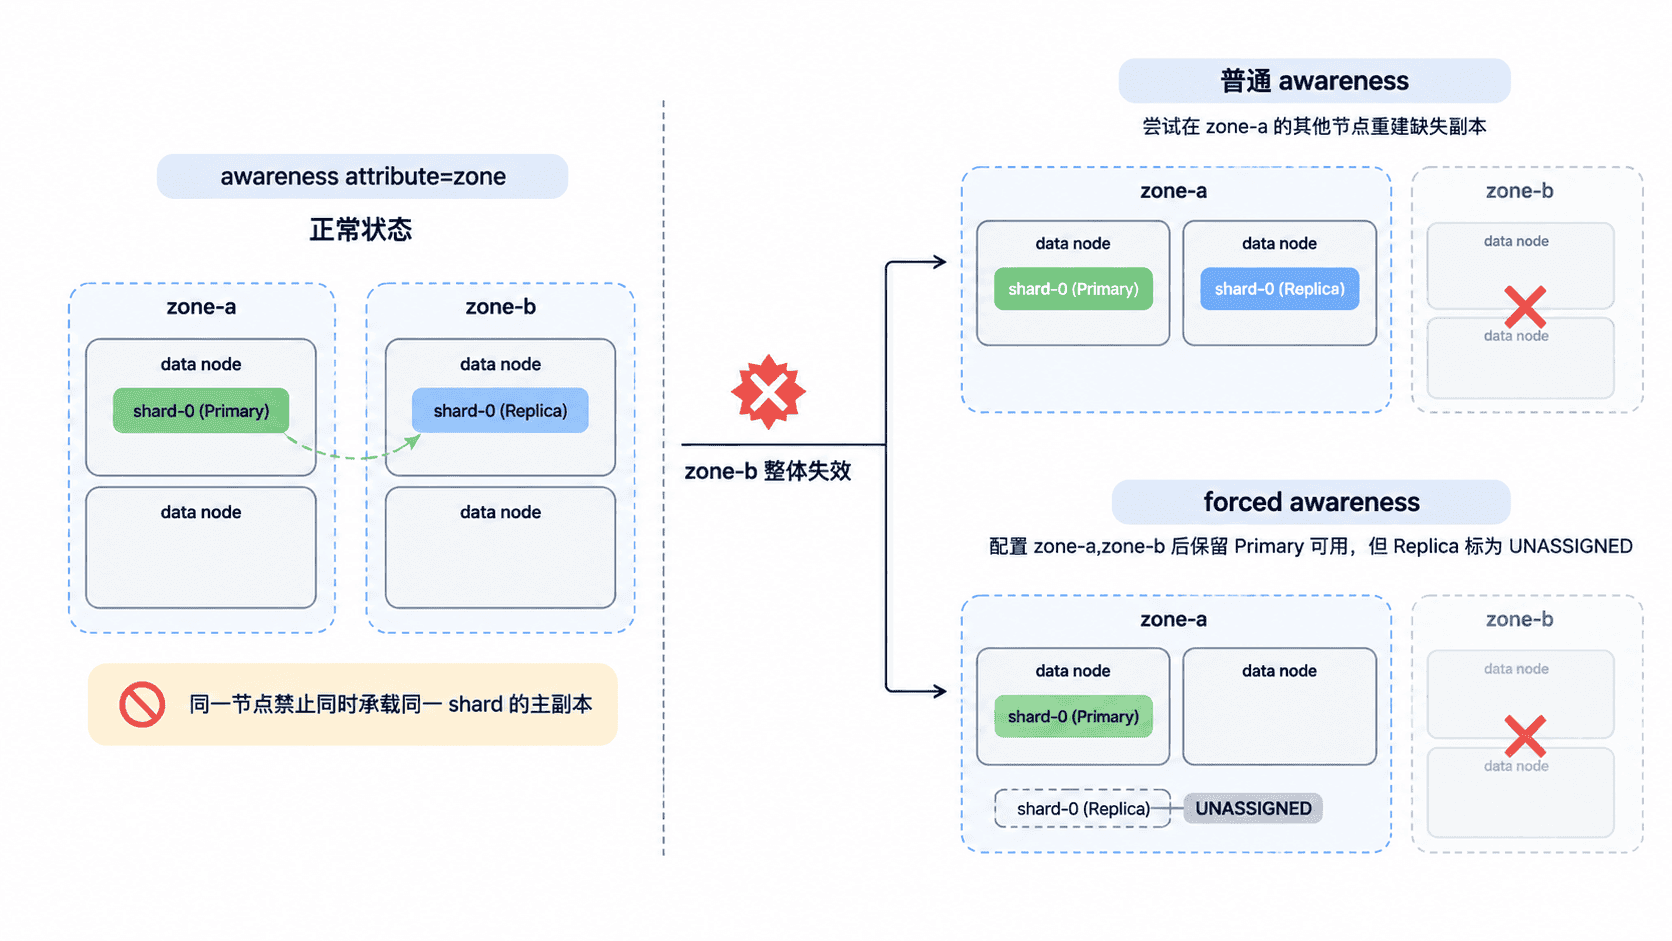
Awareness 通过类似 zone、rack_id 的节点属性告诉分配器物理边界。以两个可用区、每个主分片一个副本为例,理想布局是每个 shard copy 各占一个 zone;分配器仍会同时服从数据层、磁盘水位、index allocation filter 等其他约束。
标记节点并启用 awareness
先在每个数据节点的 elasticsearch.yml 中设置故障域属性。下面是片段示例;同一可用区内的节点使用相同值,不同可用区使用不同值。修改节点配置后需要按你的运维流程滚动重启节点。
# zone-a 中的数据节点
node.attr.zone: zone-a
生效行为:节点重新加入集群后,其节点属性中会出现 zone=zone-a。zone-b 节点应配置 node.attr.zone: zone-b,不能把所有节点都写成同一个值。
然后动态启用 awareness,并显式声明两个预期可用区。第二项就是 Forced Awareness:即使其中一个 zone 暂时消失,Elasticsearch 也不会假装只剩一个故障域并把缺失副本全部重建到另一边。
PUT _cluster/settings?flat_settings=true&filter_path=persistent
{
  "persistent": {
    "cluster.routing.allocation.awareness.attributes": "zone",
    "cluster.routing.allocation.awareness.force.zone.values": "zone-a,zone-b"
  }
}
预期结果应回显两项持久化设置。
{
  "persistent": {
    "cluster.routing.allocation.awareness.attributes": "zone",
    "cluster.routing.allocation.awareness.force.zone.values": "zone-a,zone-b"
  }
}
启用 awareness 后,参与这些分片分配的数据节点必须具备所声明的属性。生产变更前应先确认所有目标 data tier 在各个 zone 中都有足够节点,否则 awareness 与 tier/filter 约束叠加后可能让副本保持未分配。
验证主副分片是否跨域
创建一个只有 1 个主分片和 1 个副本的测试索引,再查看分片落点。以下操作应在有 zone-a、zone-b 节点的受控环境中执行。
PUT awareness-demo
{
  "settings": {
    "number_of_shards": 1,
    "number_of_replicas": 1
  }
}

GET _cat/shards/awareness-demo?v=true&h=shard,prirep,state,node

GET _nodes?filter_path=nodes.*.name,nodes.*.attributes.zone
预期结果:创建索引返回确认;随后同一个 shard 的 p 与 r 都是 STARTED,但对应节点的 zone 值不同。主分片可能位于任意一侧。
{"acknowledged":true,"shards_acknowledged":true,"index":"awareness-demo"}

shard prirep state   node
0     p      STARTED <ZONE_A_NODE>
0     r      STARTED <ZONE_B_NODE>

节点属性中:
<ZONE_A_NODE> 的 zone = zone-a
<ZONE_B_NODE> 的 zone = zone-b
如果两份 copy 没有跨域,先检查节点属性是否缺失或拼写不一致,再检查当前索引是否还有 _tier_preference、include/require/exclude filter 等更窄的候选节点集合。
选择普通还是 Forced Awareness
只配置 cluster.routing.allocation.awareness.attributes 时,某个 zone 整体失效后,Elasticsearch 会尝试把缺失副本重新分配到仍存活的 zone,只要能满足其他分配规则。这样更容易恢复为 green,但剩余区域必须有足够磁盘、CPU、I/O 和节点槽位承载额外副本。
Forced Awareness 则把允许的故障域集合固定下来。以上例的 zone-a,zone-b 为例,如果 zone-b 整体不可用,每个 shard 在 zone-a 仍有一份可用 copy,缺失的 replica 会保持 UNASSIGNED,索引通常呈 yellow,而不会为了变 green 把两份 copy 都塞进 zone-a。
在故障演练中,可以针对未分配副本请求解释结果:
GET _cluster/allocation/explain?filter_path=can_allocate,node_allocation_decisions.node_name,node_allocation_decisions.deciders
{
  "index": "awareness-demo",
  "shard": 0,
  "primary": false
}
预期结果:整域故障且 Forced Awareness 生效时,can_allocate 为 no,候选节点的 decider 中应能看到 awareness 给出拒绝决定;节点名称和具体解释文本会因集群状态而不同。
can_allocate = no
关键 decider = awareness
decision = NO
Forced Awareness 不是“更高可用”的开关,而是容量保护策略:它接受副本暂时未分配,以换取故障后不把剩余区域压到极限。若你的设计要求单区存活时仍快速恢复全部副本,就必须为单区承载全量副本预留容量,并评估是否只使用普通 awareness。