
NoSQL 与搜索 / 系统课时
控制 Aggregation 内存与 Bucket 成本
控制 Aggregation 内存与 Bucket 成本
聚合查询真正危险的往往不是命中文档多,而是产生了过多 bucket 和分片候选结果。本篇用一个可复现的 terms 嵌套聚合说明内存成本在哪里放大,并给出限制 bucket、控制候选集和改用分页聚合的判断方法。
学习目标
- 区分最终 bucket、分片候选 bucket 与协调节点 reduce 成本
- 用
size、shard_size、collect_mode和search.max_buckets控制风险 - 根据“Top N”与“遍历全部唯一值”选择
terms或composite
先定位 bucket 成本从哪里产生
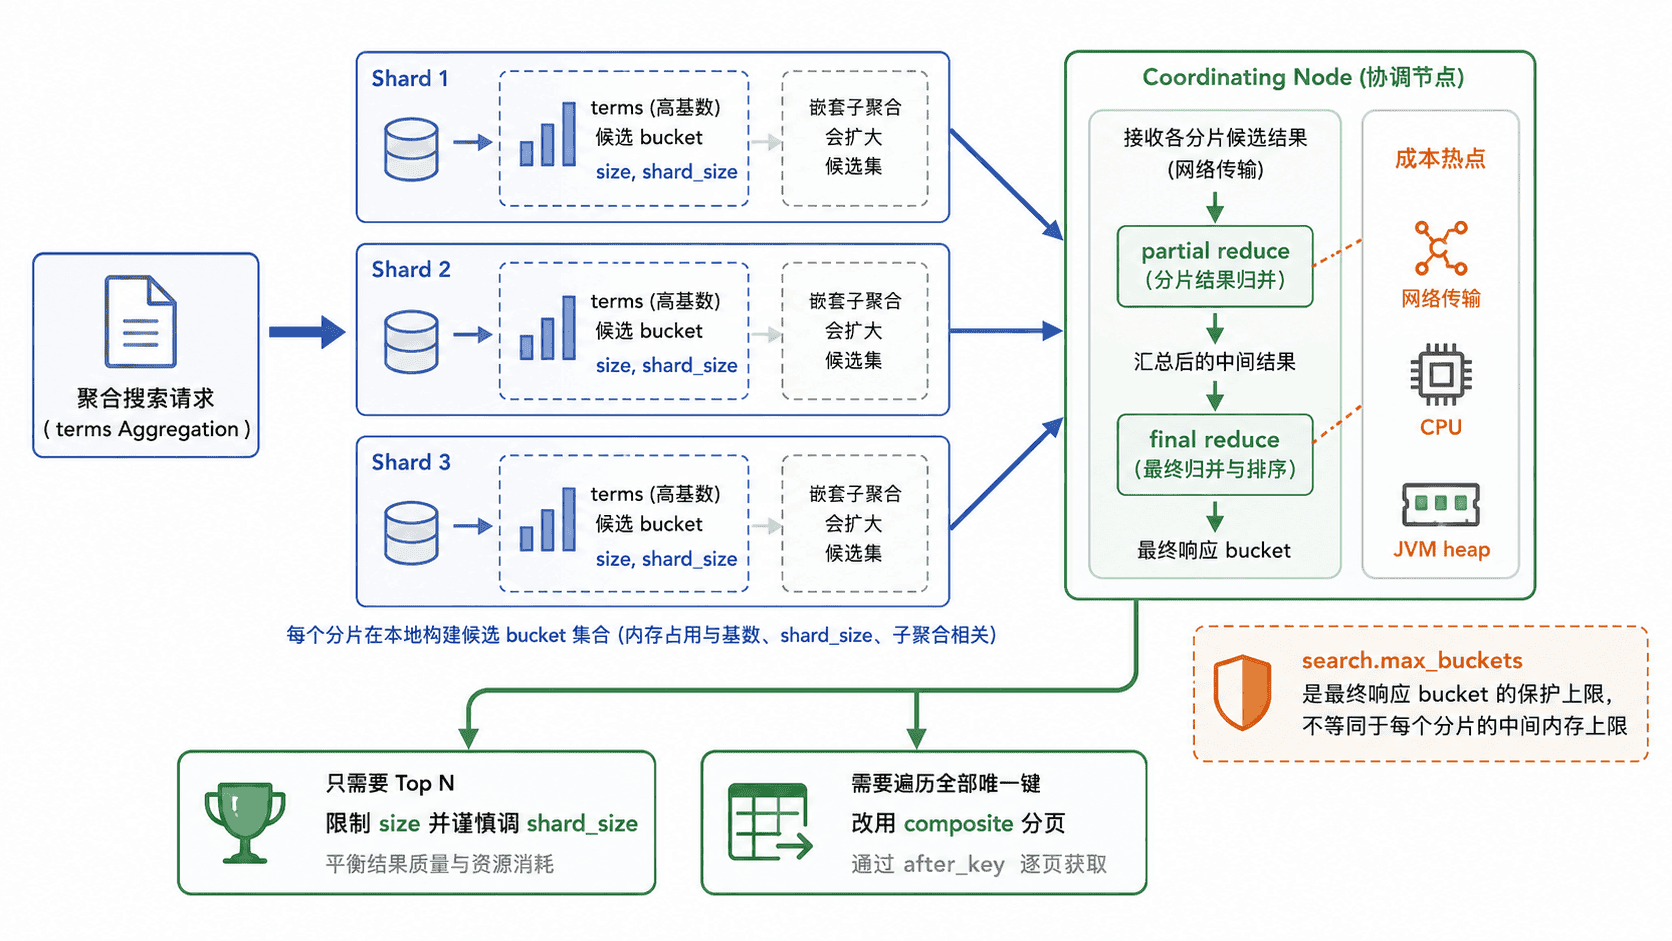
Bucket 聚合先在各目标分片本地收集结果,再把中间结果送到协调节点归并。嵌套聚合会让父 bucket 下继续展开子 bucket,因此成本取决于命中范围、字段基数、分片数、候选 bucket 数和子聚合复杂度,而不是只看最终响应里有多少行。
terms.size 控制最终希望返回的 Top N;为了避免某个全局热门值在单个分片上排名靠后而被漏掉,每个分片通常会返回更多候选值,shard_size 默认会大于 size。增大 shard_size 能改善默认按文档数降序时的准确性,但会增加分片到协调节点的网络字节和协调端暂存数据。
用可控样例观察 bucket 裁剪
下面示例创建单分片索引,故意让 tenant 有 3 个唯一值,但父聚合只取前 2 个。collect_mode: breadth_first 会先确定父层候选,再对保留下来的父 bucket 计算子聚合,适合“父字段高基数、最终只要少量 Top N、子聚合又较贵”的场景。
set -euo pipefail
: "${ES_URL:=https://localhost:9200}"
: "${ES_CA:?请设置 ES_CA 为 Elasticsearch CA 证书路径}"
: "${ES_PASSWORD:?请设置 ES_PASSWORD}"
AUTH=(--cacert "$ES_CA" -u "elastic:${ES_PASSWORD}")
# 重建独立实验索引,避免旧数据影响结果。
curl -fsS "${AUTH[@]}" -X DELETE "$ES_URL/agg-cost-demo" >/dev/null 2>&1 || true
curl -fsS "${AUTH[@]}" -H 'Content-Type: application/json' -X PUT "$ES_URL/agg-cost-demo" -d '{"settings":{"number_of_shards":1,"number_of_replicas":0},"mappings":{"properties":{"tenant":{"type":"keyword"},"status":{"type":"keyword"}}}}' >/dev/null
# 写入固定数据后刷新,保证后续聚合立即可见。
curl -fsS "${AUTH[@]}" -H 'Content-Type: application/x-ndjson' -X POST "$ES_URL/_bulk?refresh=true" --data-binary @- >/dev/null <<'NDJSON'
{"index":{"_index":"agg-cost-demo","_id":"1"}}
{"tenant":"tenant-a","status":"ok"}
{"index":{"_index":"agg-cost-demo","_id":"2"}}
{"tenant":"tenant-a","status":"ok"}
{"index":{"_index":"agg-cost-demo","_id":"3"}}
{"tenant":"tenant-a","status":"ok"}
{"index":{"_index":"agg-cost-demo","_id":"4"}}
{"tenant":"tenant-a","status":"fail"}
{"index":{"_index":"agg-cost-demo","_id":"5"}}
{"tenant":"tenant-b","status":"ok"}
{"index":{"_index":"agg-cost-demo","_id":"6"}}
{"tenant":"tenant-b","status":"ok"}
{"index":{"_index":"agg-cost-demo","_id":"7"}}
{"tenant":"tenant-b","status":"fail"}
{"index":{"_index":"agg-cost-demo","_id":"8"}}
{"tenant":"tenant-c","status":"ok"}
NDJSON
# 只返回聚合部分,避免 took 等动态字段干扰验证。
curl -fsS "${AUTH[@]}" -H 'Content-Type: application/json' -X POST "$ES_URL/agg-cost-demo/_search?filter_path=aggregations" -d '{"size":0,"aggs":{"top_tenants":{"terms":{"field":"tenant","size":2,"collect_mode":"breadth_first"},"aggs":{"by_status":{"terms":{"field":"status","size":2}}}}}}'
预期输出
{"aggregations":{"top_tenants":{"doc_count_error_upper_bound":0,"sum_other_doc_count":1,"buckets":[{"key":"tenant-a","doc_count":4,"by_status":{"doc_count_error_upper_bound":0,"sum_other_doc_count":0,"buckets":[{"key":"ok","doc_count":3},{"key":"fail","doc_count":1}]}},{"key":"tenant-b","doc_count":3,"by_status":{"doc_count_error_upper_bound":0,"sum_other_doc_count":0,"buckets":[{"key":"ok","doc_count":2},{"key":"fail","doc_count":1}]}}]}}}sum_other_doc_count: 1 说明还有文档落在未返回的父 bucket 中。生产环境里不要为了“把所有值都拿回来”不断增大 size;当唯一值很多且业务确实需要完整遍历时,应使用 composite 聚合按 after_key 分页,给每次请求设置有界的 bucket 数量。
选对降本手段
只做 Top N 时,先把 size 设成真正需要的数量,再根据准确性要求谨慎增加 shard_size;它通常比直接放大 size 更合适,但仍会增加网络与协调节点内存。若父聚合高基数且只保留少量父 bucket,可以评估 breadth_first,同时注意它会缓存匹配文档用于第二遍回放,并非无成本优化。
对 keyword 字段做 terms 通常能利用全局序数;不要为了聚合直接给高基数 text 字段开启 fielddata。多字段组合若是稳定业务维度,优先考虑写入时生成组合键,再对单个 keyword 字段聚合,而不是长期依赖更重的运行时组合。
把保护线和观测结合
search.max_buckets 是动态集群设置,默认值为 65536,限制单次响应允许返回的聚合 bucket 数。它是一条故障保护线,不是“安全预算”;分片侧候选数据和 reduce 中间结构仍可能在触发该上限前造成明显内存压力。
set -euo pipefail
: "${ES_URL:=https://localhost:9200}"
: "${ES_CA:?请设置 ES_CA 为 Elasticsearch CA 证书路径}"
: "${ES_PASSWORD:?请设置 ES_PASSWORD}"
AUTH=(--cacert "$ES_CA" -u "elastic:${ES_PASSWORD}")
curl -fsS "${AUTH[@]}" "$ES_URL/_cluster/settings?include_defaults=true&flat_settings=true&filter_path=transient.search.max_buckets,persistent.search.max_buckets,defaults.search.max_buckets"
预期结果
响应中会出现 search.max_buckets 的生效来源;未覆盖默认值时可见 65536,若集群已动态修改则实际值为 <VALUE>。出现 circuit_breaking_exception、协调节点 heap 持续抬升或聚合延迟随分片数明显增长时,优先缩小查询范围、减少 bucket 和候选集,而不是先调高 search.max_buckets 或 request breaker。只有把每次请求的中间结果规模压下来,聚合吞吐才会稳定。