
NoSQL 与搜索 / 系统课时
控制 Segment 数量与 Force Merge
控制 Segment 数量与 Force Merge
Force Merge 不是“定期把 segment 压到越少越好”的保养动作。本课从可合并对象、执行窗口和磁盘风险出发,完成一次只读索引的安全合并,并用 segment 数据验证结果。
学习目标
- 判断哪些索引适合执行 force merge,哪些活跃写入索引应交给自动 merge
- 在执行前确认写入状态、磁盘余量与集群健康,避免合并放大 I/O 风险
- 使用 Force Merge API 执行并验证 segment 数量和删除文档变化
先判断是否真的需要 Force Merge
Elasticsearch 的每个 shard 本质上是一个 Lucene 索引,内部由多个不可变 segment 组成。刷新会不断产生新 segment,后台 merge 会按策略自动把小 segment 合并,因此“segment 多”本身不是故障。
Force Merge 的价值主要出现在已经完成写入的时间序列索引、归档索引或 rollover 后的旧 backing index:这些 shard 后续几乎不再产生新 segment,此时减少 segment 可以降低长期搜索和文件管理开销,并回收部分已删除文档占用的空间。
如果索引仍持续更新或删除,不要反复把它强制合并到 1 个 segment。过大的 segment 后续可能不再参与常规 merge,软删除文档会继续累积,快照的增量效率也可能变差。低写入阶段若要执行,应先把目标索引切出写路径,形成明确的无写入窗口。
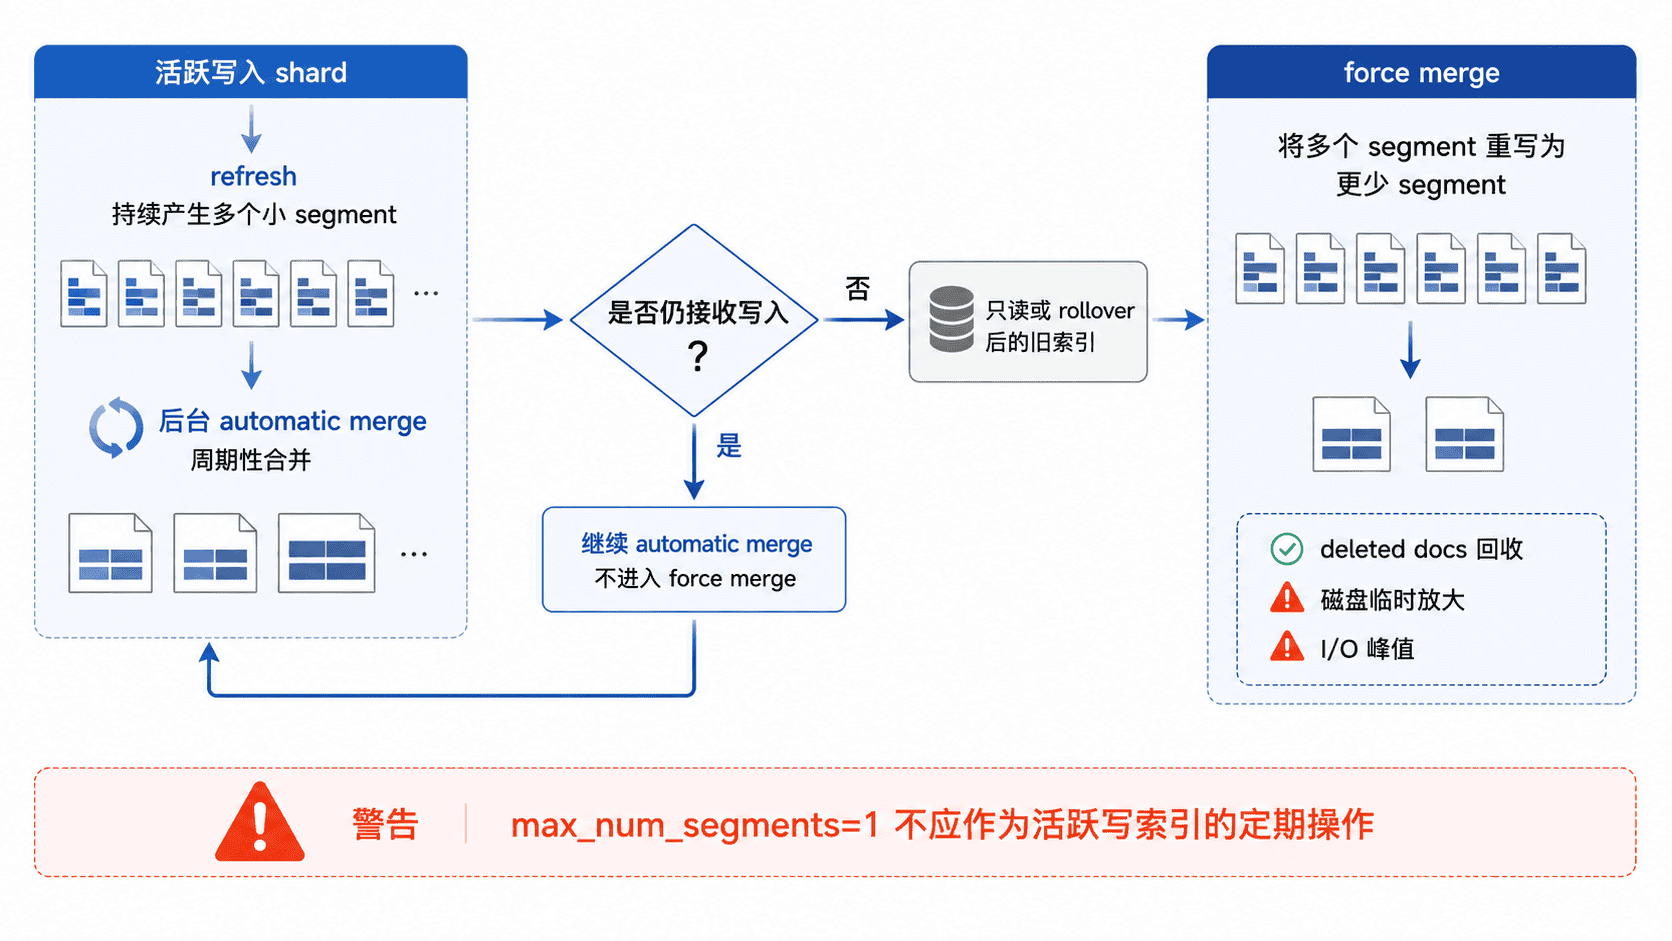
选择安全的执行窗口
执行前先把目标限定到一个明确索引,不要直接对通配符或整个集群发起合并。生产环境至少检查以下条件:
- 索引已经 rollover,写 alias 或 data stream 的写入目标不再指向它;必要时增加 write block
- 集群健康稳定,没有大规模 recovery、snapshot、reindex 或高峰批量写入同时争用磁盘
- 数据节点有充足空闲空间;当
max_num_segments=1时,单个 shard 的合并过程最坏可能临时需要接近原 shard 大小 3 倍的空间 - 已记录合并前的 segment 数量、
docs.deleted、磁盘使用与查询延迟,便于判断是否真正获益
执行一次只读索引合并
下面示例先给旧索引增加写阻断,再执行 max_num_segments=1,最后查看 primary 与 replica 上的 segment。把环境变量替换为你的集群地址、API Key 和已经停止写入的索引名。
export ES_URL="https://localhost:9200"
export ELASTIC_API_KEY="<VALUE>"
export INDEX="logs-archive-2026.08.25"

curl -fsS -X PUT \
  -H "Authorization: ApiKey $ELASTIC_API_KEY" \
  "$ES_URL/$INDEX/_block/write"
echo

curl -fsS -X POST \
  -H "Authorization: ApiKey $ELASTIC_API_KEY" \
  "$ES_URL/$INDEX/_forcemerge?max_num_segments=1"
echo

curl -fsS \
  -H "Authorization: ApiKey $ELASTIC_API_KEY" \
  "$ES_URL/_cat/segments/$INDEX?h=index,shard,prirep,segment,docs.count,docs.deleted,size"
预期输出如下;shard 数、segment 名称、文档数和大小都属于动态值,实际结果会不同。
{"acknowledged":true,"shards_acknowledged":true,"indices":[{"name":"logs-archive-2026.08.25","blocked":true}]}
{"_shards":{"total":<VALUE>,"successful":<VALUE>,"failed":0}}
logs-archive-2026.08.25 0 p _<ID> <VALUE> 0 <VALUE>
logs-archive-2026.08.25 0 r _<ID> <VALUE> 0 <VALUE>
...
如果操作可能持续很久,可以使用 wait_for_completion=false 让 API 返回 task ID,再通过 Tasks API 查询进度。但 force merge task 不可取消,因此异步执行只是避免客户端长时间阻塞,不是提供“撤销”能力。
验证收益而不是只看段数
合并成功后,先确认 _shards.failed 为 0,再比较合并前后的 segment 数量和 docs.deleted。目标是让只读 shard 的长期结构更稳定,而不是追求所有 shard 都机械地只剩一个 segment。
还要观察磁盘利用率、搜索 P95/P99、节点 I/O 和快照耗时。如果 segment 数下降却带来明显 I/O 峰值、磁盘水位压力或业务延迟抖动,这次优化的窗口或目标就选错了。
对于周期性时间序列数据,优先把 force merge 放进 rollover 之后的生命周期流程,让“停止写入 → 合并 → 进入更冷阶段”成为可重复策略。对仍活跃的索引,则让 Elasticsearch 的常规 merge policy 继续工作,通常比人工反复 force merge 更安全。