
NoSQL 与搜索 / 系统课时
恢复索引与 Feature State
恢复索引与 Feature State
恢复不是“把整个快照倒回去”这么简单。本课把恢复范围拆成业务索引、Cluster State 与 Feature State 三层,并用最小恢复范围完成业务数据和必要系统状态的重建,避免在生产集群里误覆盖认证、模板或生命周期策略。
学习目标
- 区分业务索引、Cluster State 与 Feature State 的恢复边界
- 使用 Snapshot Restore API 定向恢复索引或指定 Feature State
- 通过集群健康与 shard recovery 判断恢复是否真正可用
先确定恢复边界
业务索引和数据流承载应用数据;Cluster State 包含持久化集群设置、索引模板、Ingest Pipeline、ILM 策略和存储脚本等;Feature State 则封装 Security、Kibana、Fleet、GeoIP 等功能依赖的系统索引、系统数据流及相关配置。三者影响面不同,恢复时应从最小范围开始。
在 Elasticsearch 8.0 及之后,系统索引和系统数据流不能通过普通 indices 参数单独恢复,必须通过对应的 feature_states 恢复。include_global_state: true 的影响面很大,会把快照里的全局状态带回目标集群;除非做整集群灾难恢复,否则优先显式设置为 false。
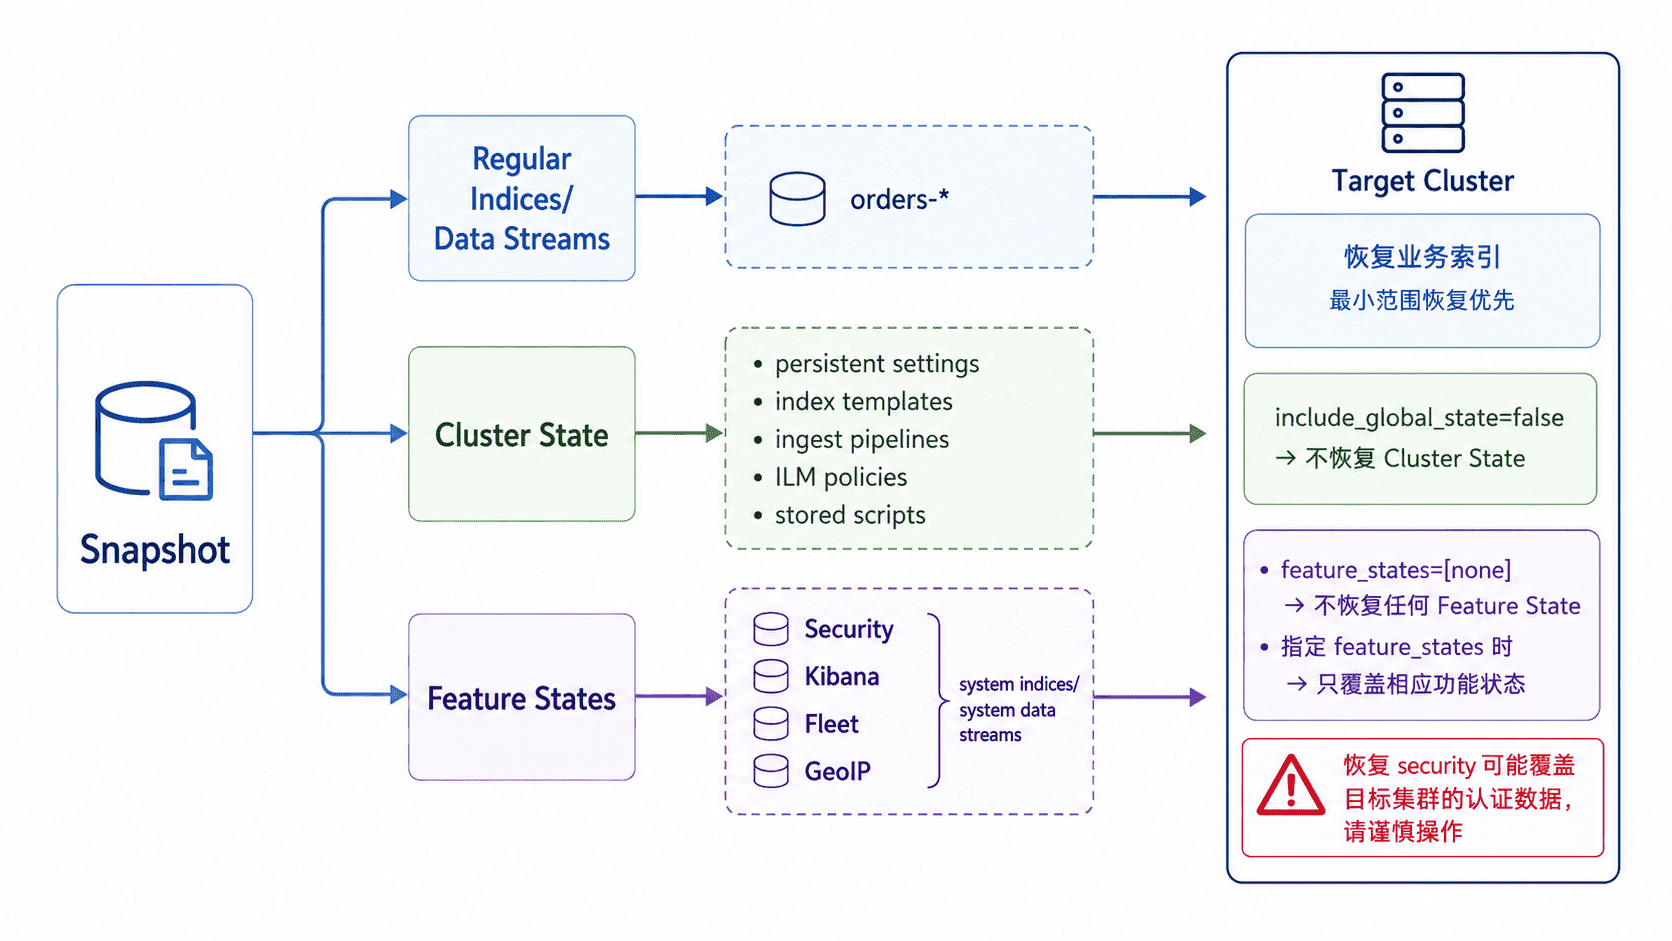
先看清快照里有什么
不要凭索引命名猜恢复内容。先查询快照,确认状态为 SUCCESS,再核对业务索引和 feature_states。Feature State 对应的底层系统索引会随版本变化,因此应读取快照返回的 feature_name,而不是硬编码系统索引名。
GET /_snapshot/prod-repo/snap-2026.08.27?filter_path=snapshots.snapshot,snapshots.state,snapshots.indices,snapshots.feature_states预期输出:
{
  "snapshots": [
    {
      "snapshot": "snap-2026.08.27",
      "state": "SUCCESS",
      "indices": [
        "orders-2026.08"
      ],
      "feature_states": [
        {
          "feature_name": "geoip",
          "indices": [
            "<INDEX>"
          ]
        }
      ]
    }
  ]
}
<INDEX> 是版本相关的系统索引名,实际值可能不同。跨集群恢复前还要确认目标 Elasticsearch 版本与快照、索引创建版本兼容;快照不能直接恢复到更早的 Elasticsearch 版本。
恢复业务索引而不碰系统状态
在已有集群中恢复业务数据时,最稳妥的做法通常是先改名恢复,再校验数据,最后由别名或应用配置切换。下面把 orders-* 恢复为 restore-orders-*,同时明确排除 Cluster State、Feature State 和原有别名。
POST /_snapshot/prod-repo/snap-2026.08.27/_restore?wait_for_completion=false
{
  "indices": "orders-*",
  "include_global_state": false,
  "feature_states": [
    "none"
  ],
  "include_aliases": false,
  "rename_pattern": "(.+)",
  "rename_replacement": "restore-$1"
}
预期输出:
{
  "accepted": true
}
异步请求返回 accepted: true 只表示恢复已初始化,不表示索引已经可用。改名恢复也能避免与现有同名开放索引冲突;确认文档数、关键查询和映射后,再决定是否切换别名或删除旧索引。
只恢复需要的 Feature State
如果业务索引已恢复,但某个 Elastic 功能的内部状态也必须重建,应单独指定 Feature State。下面只恢复快照中的 geoip,并显式排除普通索引和 Cluster State。
POST /_snapshot/prod-repo/snap-2026.08.27/_restore?wait_for_completion=false
{
  "indices": "-*",
  "include_global_state": false,
  "feature_states": [
    "geoip"
  ]
}
预期输出:
{
  "accepted": true
}
恢复 Feature State 时,Elasticsearch 会关闭并覆盖该功能现有的相关索引和数据流。像 Kibana、Fleet 这类功能还可能存在跨 Feature State 依赖,因此不能只看名字判断“恢复一个就够”,应先在演练环境验证完整功能路径。
用恢复进度而不是请求返回值验收
快照恢复通过 shard recovery 恢复主分片。主分片尚未完成时集群可能是 red;主分片完成而副本仍在恢复时常见 yellow;副本也完成后通常回到 green。因此验收至少要同时观察集群健康和目标索引的 recovery 状态。
GET /_cluster/health?filter_path=status,active_primary_shards,unassigned_shards预期输出:
{
  "status": "<VALUE>",
  "active_primary_shards": <VALUE>,
  "unassigned_shards": <VALUE>
}
<VALUE> 为动态值。真正的恢复完成条件应由业务定义:目标索引主分片已启动、关键查询结果正确、必要 Feature State 功能可用,并且没有未解释的恢复失败。不要把一次 Restore API 的成功响应等同于灾备恢复成功。