
NoSQL 与搜索 / 系统课时
搭建 Elasticsearch Rally 压测环境
搭建 Elasticsearch Rally 压测环境
这篇课时把 Rally 从“能安装”推进到“能重复跑出可比较结果”:你会固定 Rally 与 Elasticsearch 版本,用标准 Track 做一次最小验收,再把压测命令、标签和对比流程固化,避免把环境漂移误判成性能变化。
学习目标
- 安装并验证 Elasticsearch Rally 2.13.0,理解压测机与被测集群的边界
- 使用标准 Track 和
--test-mode完成一次可重复的基准验收 - 用 Race ID 与用户标签保存基线,并比较两次运行的性能差异
隔离压测机与被测集群
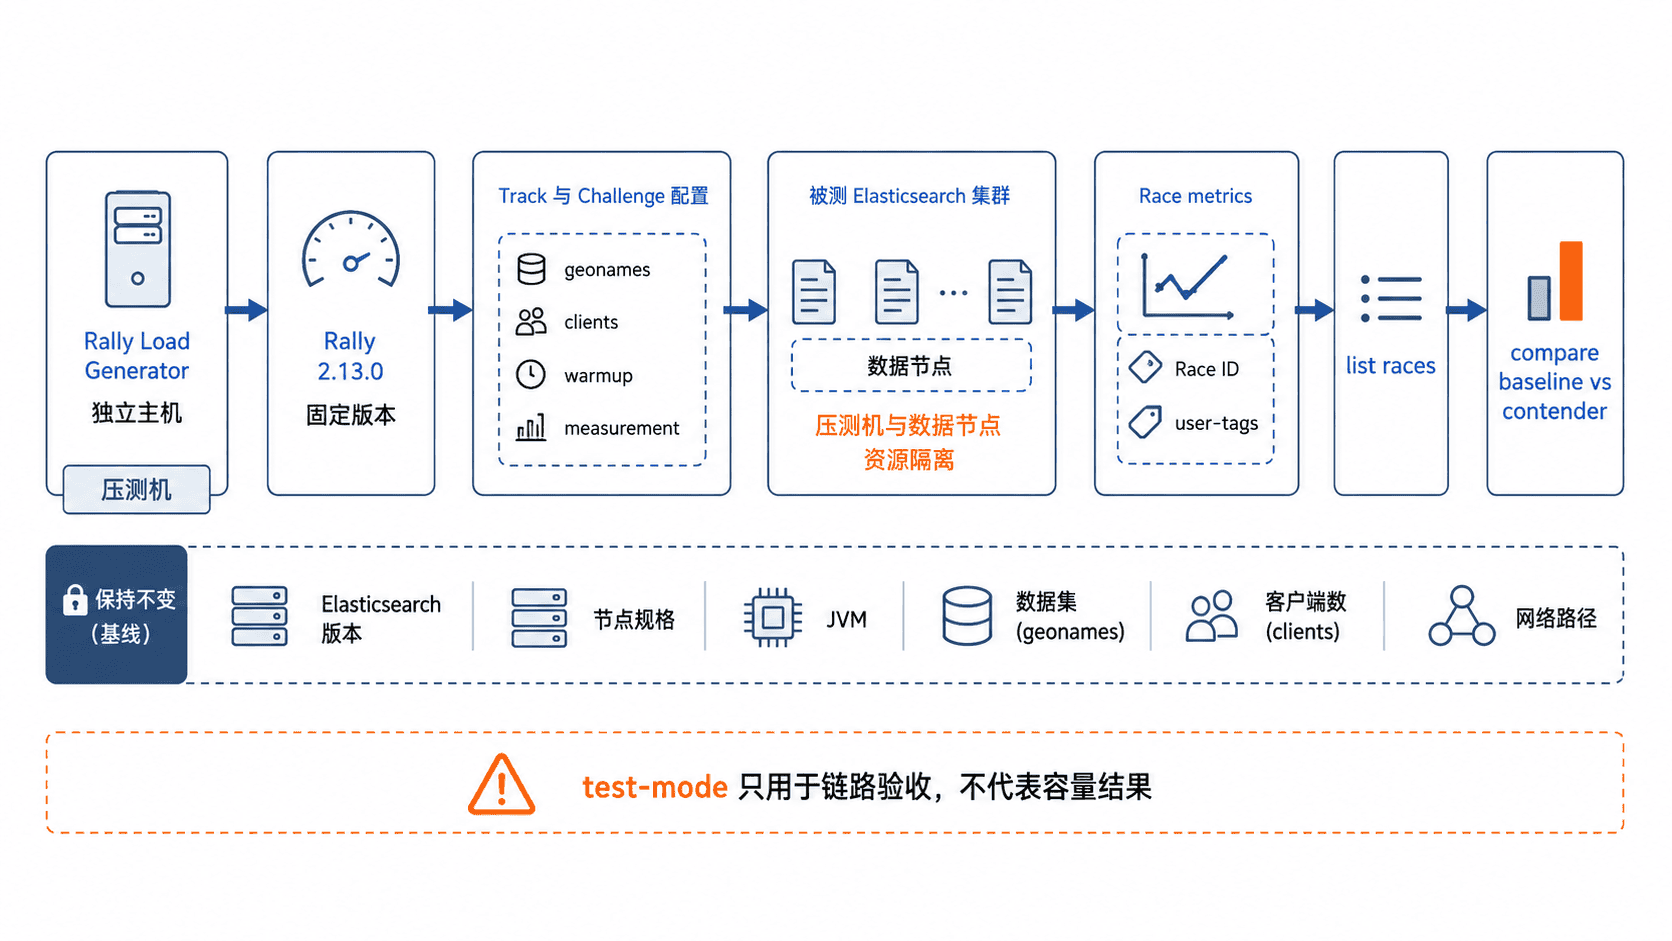
Rally 既是工作负载生成器,也是结果记录工具。正式压测时不要把 Rally 与 Elasticsearch 数据节点放在同一台机器上,否则 CPU、内存和磁盘竞争会污染结果。负载机优先使用 SSD,并确保网络路径固定;同一组对比测试还要保持 Track、Challenge、客户端数量、Elasticsearch 版本与节点规格一致。
本文使用 Rally 2.13.0。它支持 Python 3.10~3.13,并主要面向 Linux 与 macOS。先检查运行环境,再在独立虚拟环境中安装,避免系统 Python 的依赖变化影响后续复跑。
python3 --version
git --version
python3 -m venv .venv
source .venv/bin/activate
python3 -m pip install --upgrade pip
python3 -m pip install "esrally==2.13.0"
esrally --version
预期输出
Python 3.<MINOR>.<PATCH>
git version <VERSION>
...
Successfully installed esrally-2.13.0 ...
esrally 2.13.0<MINOR>、<PATCH> 与 <VERSION> 会随本机环境变化。若 python3 不在 3.10~3.13 范围内,应先切换解释器,不要强行绕过依赖约束。
跑通最小基准链路
第一次不要直接上长时间压测。Rally 的 --test-mode 会把任务缩短到适合验收的规模,用来确认 Track、下载、Elasticsearch 启动和指标收集链路是否可用。下面让 Rally 下载并启动 Elasticsearch 9.3.0,然后执行 geonames 的默认 Challenge。
esrally race \
  --distribution-version=9.3.0 \
  --runtime-jdk=bundled \
  --track=geonames \
  --test-mode \
  --user-tags="purpose:smoke,env:lab"
预期结果
...
------------------------------------------------------
    _______             __   _____
...
------------------------------------------------------
[INFO] SUCCESS (took <TIME>)
------------------------------------------------------
<TIME> 取决于下载缓存、磁盘和机器性能。测试成功只说明压测链路可用,不能把 --test-mode 的吞吐和延迟当成容量结论;正式基线应移除该参数,并在固定环境中完成预热与多轮测量。
固化正式基线与复跑条件
正式压测前,把“环境条件”写进测试记录,而不是只保存一条命令。至少记录 Elasticsearch 版本、节点角色与数量、堆大小、磁盘类型、Track revision、Challenge、客户端数和业务相关索引设置。一次配置变更只改一个变量,其他条件保持不变,才能把差异归因到该变更。
Rally 的 --user-tags 很适合标记实验意图。下面展示同一 Track 的两次运行;示例仍保留 --test-mode 以便快速练习,真实容量基线应移除它。
esrally race --distribution-version=9.3.0 --runtime-jdk=bundled \
  --track=geonames --test-mode \
  --user-tags="purpose:baseline,change:none"

esrally race --distribution-version=9.3.0 --runtime-jdk=bundled \
  --track=geonames --test-mode \
  --user-tags="purpose:contender,change:index-setting"

esrally list races
预期输出
Race ID                               Race Timestamp    Track      Challenge             ...
<ID>                                  <TIME>            geonames   append-no-conflicts   ...
<ID>                                  <TIME>            geonames   append-no-conflicts   ...
从列表中复制两次运行的 Race ID,再做对比:
esrally compare --baseline=<BASELINE_ID> --contender=<CONTENDER_ID>预期结果
Comparing baseline
  Race ID: <BASELINE_ID>
with contender
  Race ID: <CONTENDER_ID>

Metric                              Baseline    Contender    Diff
...
对比时优先看与目标一致的指标:写入场景关注 indexing throughput、merge/refresh 时间与尾延迟,查询场景关注吞吐以及 P90/P99 latency。若压测机 CPU 已满、磁盘读数据成为瓶颈或网络跑满,应先修复负载端瓶颈,再解释 Elasticsearch 的结果。
让基准结果可以被信任
一轮成功的 Race 不是结论。真正可复用的基线应满足三个条件:环境可还原、命令可复跑、差异可解释。生产级测试通常要先预热,再重复多轮并观察波动;如果同配置多轮结果差异明显,先排查资源抖动、后台任务、分片迁移和缓存状态,而不是急着宣布某项优化有效。