
NoSQL 与搜索 / 系统课时
诊断磁盘 I/O 饱和
诊断磁盘 I/O 饱和
磁盘告警不能只看“使用率高不高”。这一课把磁盘吞吐与延迟、Lucene merge、分片 recovery 和磁盘 watermark 串成一条诊断链,帮助你区分容量不足、后台合并、恢复流量和真实 I/O 饱和,并给出可验证的处置顺序。
学习目标
- 用节点与分片指标判断磁盘是否已经成为请求延迟的主瓶颈
- 区分 merge、recovery、容量水位引发的不同 I/O 压力
- 按“止血—定位—修复—复测”顺序处理磁盘饱和
先确认现象是不是磁盘瓶颈
磁盘瓶颈的核心不是“磁盘忙”,而是设备服务能力已经接近上限,新的读写只能排队。在 Elasticsearch 中,它通常同时表现为请求延迟抬升、merge 或 recovery 持续占用 I/O,以及文件系统可用空间下降。只看到 CPU 不高或磁盘使用率接近 100%,都不足以单独定性。
先采集同一时间窗口的节点文件系统、索引 merge、恢复任务和磁盘水位,避免把不同时间点的指标拼在一起判断。
ES="https://es01:9200"
AUTH="elastic:<PASSWORD>"
CA="<PATH>/http_ca.crt"

curl -sS --cacert "$CA" -u "$AUTH" \
  "$ES/_nodes/stats/fs,indices?filter_path=nodes.*.name,nodes.*.fs.total.available_in_bytes,nodes.*.fs.io_stats.devices,nodes.*.indices.merges.current,nodes.*.indices.merges.current_size_in_bytes,nodes.*.indices.merges.total_throttled_time_in_millis"

curl -sS --cacert "$CA" -u "$AUTH" \
  "$ES/_cat/recovery?v=true&active_only=true&h=index,shard,time,type,stage,source_node,target_node,files_percent,bytes_percent"

curl -sS --cacert "$CA" -u "$AUTH" \
  "$ES/_cluster/settings?include_defaults=true&flat_settings=true"
预期输出
{
  "nodes": {
    "<ID>": {
      "name": "es01",
      "fs": {
        "total": {
          "available_in_bytes": <VALUE>
        },
        "io_stats": {
          "devices": [
            {
              "device_name": "<DEVICE>",
              "operations": <VALUE>,
              "read_operations": <VALUE>,
              "write_operations": <VALUE>,
              "read_kilobytes": <VALUE>,
              "write_kilobytes": <VALUE>
            }
          ]
        }
      },
      "indices": {
        "merges": {
          "current": <VALUE>,
          "current_size_in_bytes": <VALUE>,
          "total_throttled_time_in_millis": <VALUE>
        }
      }
    }
  }
}
<active recovery rows or only the header>
{
  "persistent": { ... },
  "transient": { ... },
  "defaults": {
    "cluster.routing.allocation.disk.watermark.low": "<VALUE>",
    "cluster.routing.allocation.disk.watermark.high": "<VALUE>",
    "cluster.routing.allocation.disk.watermark.flood_stage": "<VALUE>",
    ...
  }
}
以上三段输出按命令顺序出现;第三段仅展示与磁盘水位相关的字段,其余默认设置已省略。实际数值、设备名和恢复行会随环境变化;某些平台无法提供设备级 fs.io_stats,此时要补看主机或云盘侧的 IOPS、吞吐和延迟指标。
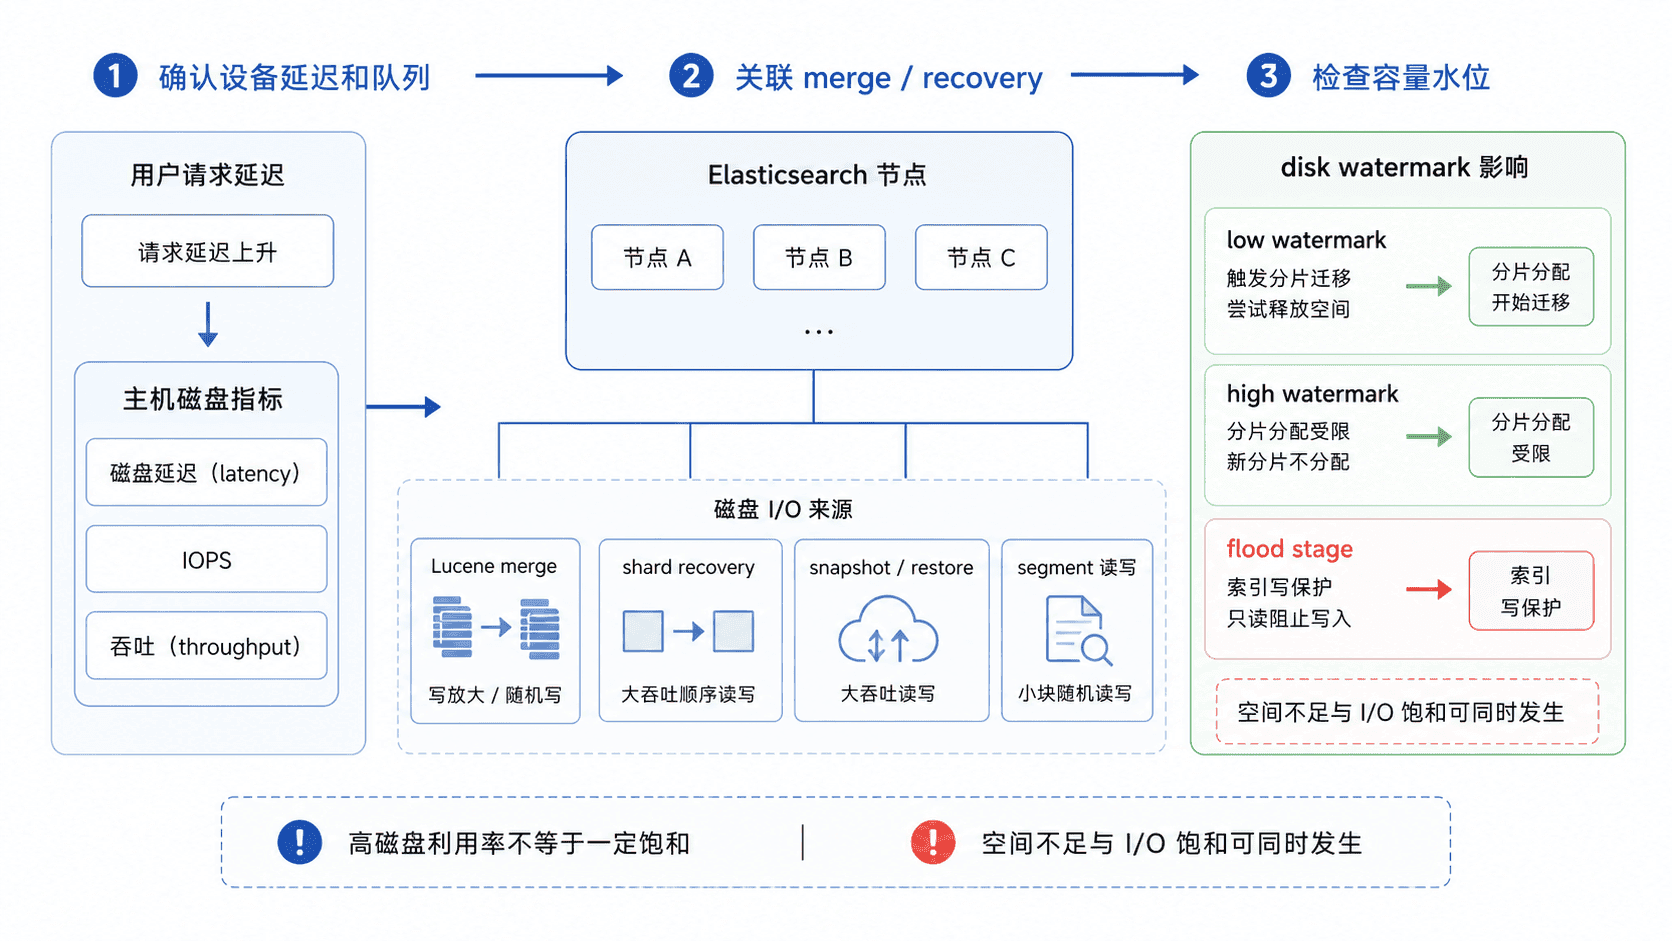
用变化率而不是单个累计值判断压力来源
operations、读写操作数、读写 KB 和 total_throttled_time_in_millis 都是累计计数。单次快照只能说明“到现在发生过多少”,不能说明“当前每秒发生多少”。应在固定间隔采两次,比较增量,再与同一窗口的磁盘延迟、搜索 P95/P99、写入延迟一起看。
如果设备延迟和队列明显升高,同时 merge 的 current_size_in_bytes 长时间较大,通常是段合并在持续消耗写带宽;如果活跃 recovery 的 bytes_percent 持续推进且目标节点写入量同步升高,压力更可能来自分片恢复或迁移。两者叠加时,前台查询和写入会一起受挤压。
把 watermark 与性能问题分开判断
磁盘 watermark 是容量保护机制,不是 I/O 饱和检测器。超过高水位后,分片分配器会尝试把分片迁离压力节点;达到 flood stage 时,受影响索引可能进入只读保护。此时 recovery/relocation 反而会增加额外磁盘和网络流量,让已经紧张的设备更忙。
因此看到 watermark 告警时,先回答两个问题:空间是否确实不足,以及设备延迟是否同时恶化。只有空间不足而延迟正常,优先扩容、清理或调整数据生命周期;空间和延迟同时恶化,则要避免盲目触发大规模迁移。
按影响面执行修复
短期止血应先减少会放大 I/O 的后台工作,例如暂停非必要的批量写入、降低恢复并发或等待高峰过去;不要一上来同时改 merge、recovery 和 watermark 参数,否则很难验证哪项改动有效。
长期修复要对应根因:容量不足就增加可用空间或优化保留策略;merge 压力长期过高就检查分片大小、写入模式和索引设计;recovery 经常把磁盘打满则检查节点替换、重平衡策略与恢复带宽;底层卷长期达到 IOPS 或吞吐上限,则需要更高性能存储或把热点分散到更多节点。
修复后重新采集相同窗口的设备延迟、搜索/写入延迟、merge 增量和 recovery 进度。只有前台延迟回落且后台 I/O 不再长期顶住设备上限,才能认为磁盘瓶颈已经解除。