
NoSQL 与搜索 / 系统课时
认识集群协调与 Cluster State
认识集群协调与 Cluster State
本篇解决一个生产运维中的核心判断:哪些变化必须经过集群协调,为什么一次看似普通的索引、分片或节点变化,可能让整个集群都感受到延迟。读完后,你能把 elected master、Cluster State 与数据读写路径分开看待,并用 API 做基础核验。
学习目标
- 说清 Cluster State 保存什么,以及 elected master 在其中承担什么职责
- 看懂一次 Cluster State 从计算、提交到各节点应用的发布过程
- 根据状态发布变慢的常见诱因,选择合适的观测入口
Cluster State 管的是集群事实
Cluster State 是 Elasticsearch 节点共同依赖的一份集群级元数据。它记录节点身份与属性、集群设置、索引 metadata(包括 mapping 与 settings),以及每个 shard copy 当前位于哪个节点、处于什么路由状态。文档内容本身不存放在 Cluster State 中。
只有当前 elected master 能修改 Cluster State。其他节点发现节点加入、分片故障或配置变更后,会把需要协调的事件交给 elected master;搜索与普通写入则通常直接在协调节点、数据节点和目标分片之间完成,并不会让 elected master 处理每一次数据请求。
状态发布是一次有提交点的协作
elected master 会串行处理一批批 Cluster State 更新。它先基于当前状态计算新状态,再把更新发布给其他节点;已有上一版本状态的节点通常接收差异,缺少基础版本的节点则需要完整状态。
发布并不是“master 发出去就算成功”。其他节点先接收新状态但暂不应用;当 elected master 收到 voting configuration 中足够多 master-eligible 节点的确认后,新状态才被视为 committed。随后 master 通知各节点应用已提交状态,各节点应用完成后再次确认。
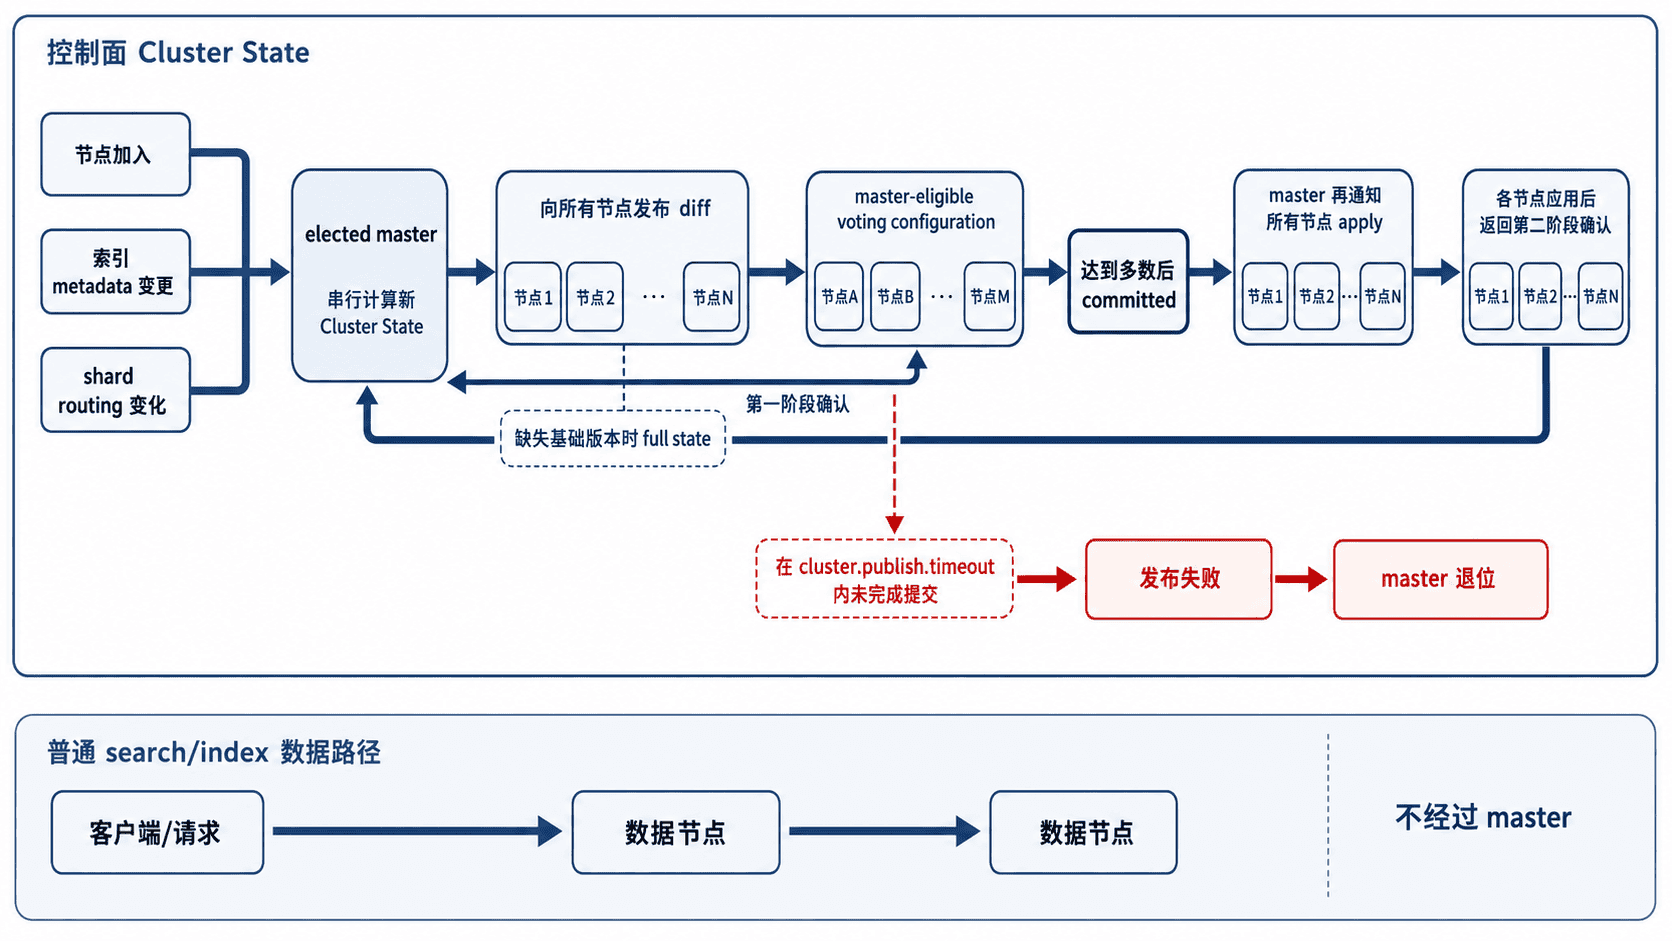
这套机制意味着 Cluster State 变化的关键瓶颈不只是 elected master 的 CPU。master-eligible 节点的持久化速度、节点间网络延迟,以及其他节点应用状态的速度都会影响一次发布。若新状态在 cluster.publish.timeout 内尚未提交,当前 elected master 会认为自己无法继续安全履职并退位;默认超时为 30 秒。
为什么状态变化会拖慢整个集群
生产环境里,最危险的不是“Cluster State 很大”这一句结论,而是状态大、变化频繁、发布链路又慢同时出现。大量索引与分片、持续膨胀的 mappings、频繁创建删除索引,以及节点反复加入离开,都会增加协调工作与发布压力。
当状态更新排队时,创建索引、修改 mapping、分配 shard 等依赖 Cluster State 的操作会直接变慢。与此同时,节点故障后的 shard 重新分配也需要新的 Cluster State,因此控制面迟滞会延长故障恢复窗口。普通搜索或写入未必立刻停止,但它们可能逐渐受到 shard 不可用、路由变化迟迟不能落地等二次影响。
排查时要把问题拆成三层:elected master 是否稳定、Cluster State 更新是否持续积压、各节点是否能及时接收并应用状态。只盯 green/yellow/red 健康颜色,无法说明协调链路本身是否健康。
用 API 核验当前 master 与状态版本
下面的命令适合在已有 Elasticsearch 集群上做诊断。先设置集群地址和有集群监控权限的 API Key,再只读取 Cluster State 中需要的少量字段,避免无目的拉取完整状态。
export ES_URL="https://<HOST>:<PORT>"
export ES_API_KEY="<API_KEY>"

curl -s \
  -H "Authorization: ApiKey $ES_API_KEY" \
  "$ES_URL/_cluster/state/master_node,nodes?filter_path=version,master_node,nodes.*.name"
预期输出类似:
{
  "version": 128,
  "master_node": "<ID_MASTER>",
  "nodes": {
    "<ID_MASTER>": {
      "name": "es-master-1"
    },
    "<ID_OTHER>": {
      "name": "es-data-1"
    }
  }
}
version 会随 Cluster State 成功更新而变化,节点 ID 和版本号以实际集群为准。master_node 指向当前 elected master;把它与 nodes 中的名称对应起来,就能确认当前由哪台节点承担协调职责。
当你看到 master 频繁变化、Cluster State 更新持续积压,或节点长期无法应用最新状态时,应先处理控制面的网络、存储与状态规模问题,而不是把它误判成单纯的数据节点查询性能问题。