
NoSQL 与搜索 / 系统课时
诊断 Cluster State 膨胀与 Master 压力
诊断 Cluster State 膨胀与 Master 压力
本课解决“master 看起来很忙,但究竟是元数据太大、变更太频繁,还是节点资源不足”的判断问题。你会用索引、分片、映射、pending tasks 与 master JVM/CPU 指标建立证据链,再决定应减元数据、降更新频率还是扩容。
学习目标
- 区分 Cluster State 体量膨胀与高频状态更新两类 master 压力。
- 用
_cluster/stats、_cluster/pending_tasks与节点统计定位瓶颈。 - 按“先减少元数据和变更,再评估资源”的顺序制定修复方案。
看懂压力是怎样形成的
Cluster State 保存节点信息、集群设置、索引 metadata 与 mapping、分片路由等内容。索引数量、分片副本数量和字段映射持续增加,会抬高所有节点持有状态的内存成本;动态 mapping、频繁建删索引、分片恢复等事件则会提高状态更新频率。
elected master 需要计算新的 Cluster State、发布变更、完成提交并让节点应用。状态很大会让单次处理更贵,状态变化很快会让更新排队;两者叠加时,常见表现是 pending tasks 数量与等待时间持续上升,master heap/CPU 抬升,管理类操作变慢,甚至伴随 master 不稳定。
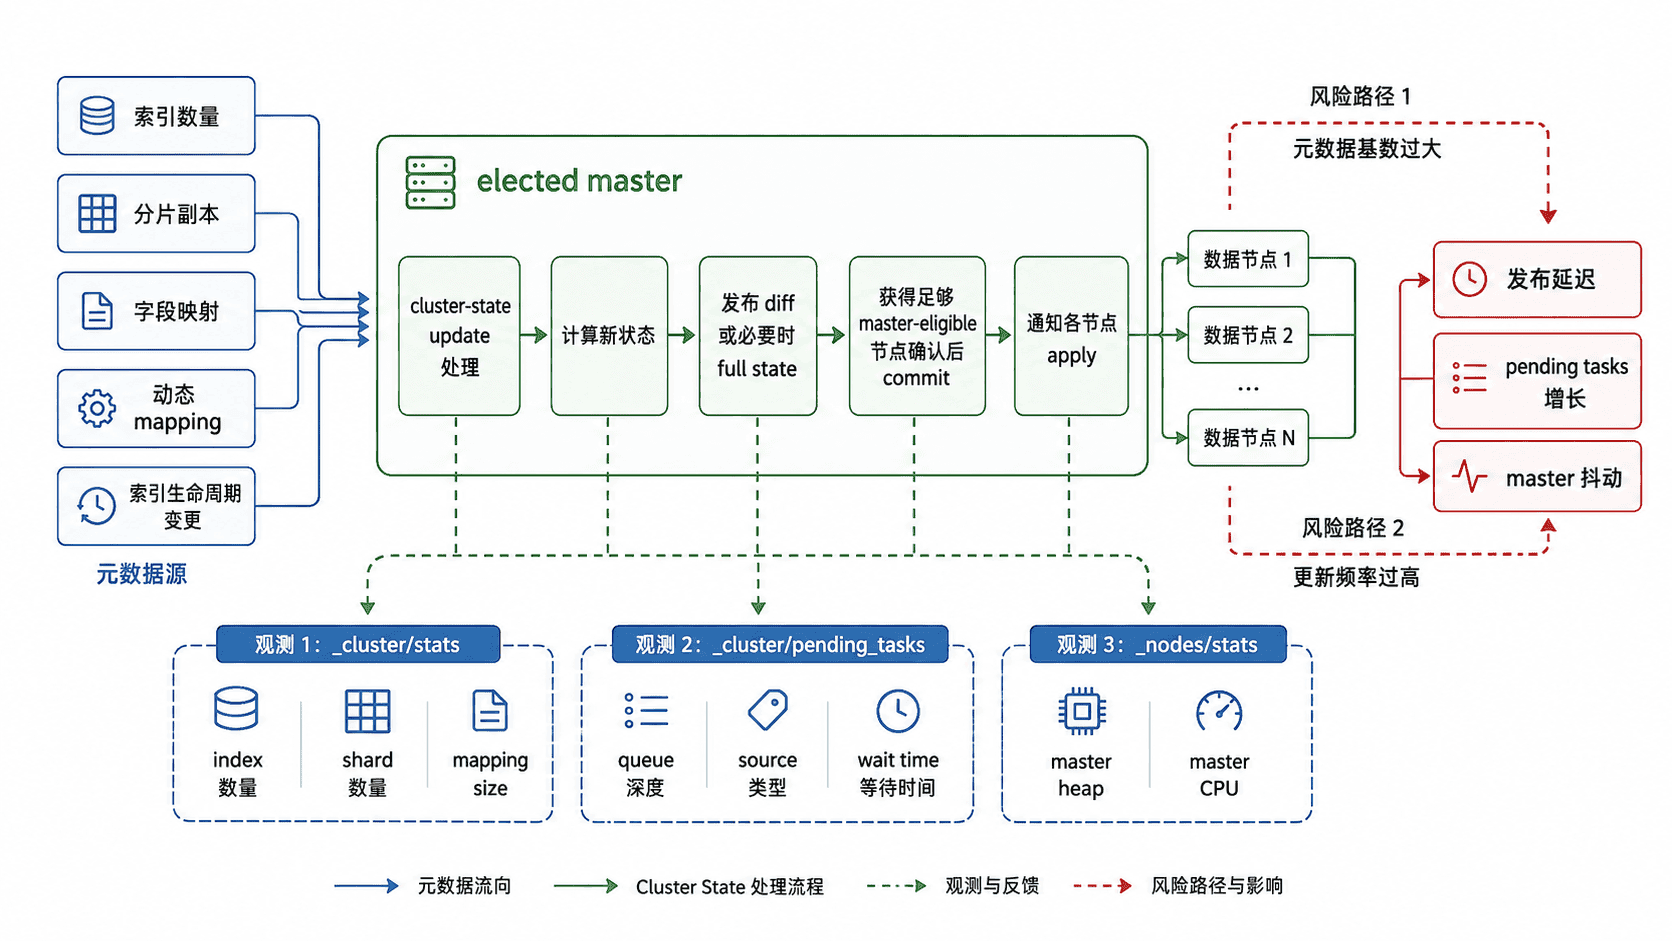
用三组指标确认是不是 Cluster State 问题
下面的只读命令适合在故障窗口采集一次快照。将 <PATH>、<PASSWORD> 等替换为实际值;账号需具备读取这些 Elasticsearch 监控 API 的权限。
ES_URL="https://localhost:9200"
CACERT="<PATH>/http_ca.crt"
ES_USER="elastic"
ES_PASSWORD="<PASSWORD>"
AUTH=(-u "$ES_USER:$ES_PASSWORD" --cacert "$CACERT")

curl -sS "${AUTH[@]}" "$ES_URL/_cat/master?h=id,host,ip,node"
curl -sS "${AUTH[@]}" "$ES_URL/_cluster/health?filter_path=status,number_of_pending_tasks,task_max_waiting_in_queue_millis"
curl -sS "${AUTH[@]}" "$ES_URL/_cluster/stats?human=true&filter_path=indices.count,indices.shards.total,indices.mappings.total_deduplicated_mapping_size,indices.mappings.total_deduplicated_mapping_size_in_bytes"
curl -sS "${AUTH[@]}" "$ES_URL/_cluster/pending_tasks?filter_path=tasks.insert_order,tasks.priority,tasks.source,tasks.executing,tasks.time_in_queue_millis"
curl -sS "${AUTH[@]}" "$ES_URL/_nodes/stats/jvm,process?filter_path=nodes.*.name,nodes.*.roles,nodes.*.jvm.mem.heap_used_percent,nodes.*.jvm.mem.heap_max_in_bytes,nodes.*.process.cpu.percent"预期输出结构如下,<VALUE>、<ID>、<IP> 会随集群变化:
<ID> <IP> <IP> es-master-1
{"status":"green","number_of_pending_tasks":<VALUE>,"task_max_waiting_in_queue_millis":<VALUE>}
{"indices":{"count":<VALUE>,"shards":{"total":<VALUE>},"mappings":{"total_deduplicated_mapping_size":"<VALUE>","total_deduplicated_mapping_size_in_bytes":<VALUE>}}}
{"tasks":[{"insert_order":<ID>,"priority":"HIGH","source":"<VALUE>","executing":false,"time_in_queue_millis":<VALUE>}]}
{"nodes":{"<ID>":{"name":"es-master-1","roles":["master"],"jvm":{"mem":{"heap_used_percent":<VALUE>,"heap_max_in_bytes":<VALUE>}},"process":{"cpu":{"percent":<VALUE>}}}}}
不要只看一次绝对值。更可靠的证据是:索引、分片或 mapping size 长期增长;pending tasks 在低峰期仍清不掉;最老任务等待时间持续扩大;当前 elected master 的 heap/CPU 同时偏高。若只有业务数据节点 CPU 高而 master 队列稳定,问题通常不在 Cluster State。
从 pending tasks 找到更新风暴
_cluster/pending_tasks 的 source 能说明 master 正在被什么类型的状态变更推动。反复出现 mapping 更新,通常要追查动态字段是否失控;大量 shard-started 往往与节点抖动、恢复或分片数量过多相关;ILM 相关任务长期堆积,则要检查生命周期操作与索引规模。
| 观察 | 更可能的含义 | 下一步 |
|---|---|---|
| mapping size 大且持续上升 | 字段或索引 schema 基数膨胀 | 检查动态 mapping、字段模型与模板 |
| 分片数远快于数据量增长 | 小分片、索引切得过细 | 合并索引策略、调整 rollover 与主分片数 |
| pending tasks 等待时间持续增大 | master 状态更新处理不过来 | 按 source 识别最频繁的变更 |
| master heap/CPU 高但元数据稳定 | 资源不足或其他管理负载 | 检查 hot threads、GC 与硬件容量 |
先减元数据与变更,再考虑扩容
修复顺序应从根因开始。字段爆炸时,优先修正上游字段模型,限制动态 mapping,必要时把任意键集合改为 flattened,并通过新索引与 reindex 清理历史 mapping。索引和分片过多时,应收敛时间分桶粒度、调整 rollover 条件、减少不必要的主分片和副本,并删除已经不需要的索引。
如果主要问题是更新频率,重点消除不断触发 cluster-state change 的事件,例如失控的动态字段、频繁建删索引、节点反复离开和加入。只有元数据规模与变更速率都已合理,master 仍长期资源紧张时,再增加 dedicated master 的 CPU/heap 或调整节点规格。
修复完成后,目标不是某个固定“安全分片数”,而是恢复稳定趋势:pending tasks 能快速清空或保持低位,最老任务等待时间不再增长,master heap/CPU 回到基线,索引创建、mapping 更新和分片分配不再出现明显延迟。