
NoSQL 与搜索 / 系统课时
理解 Query Cache 与 Request Cache
理解 Query Cache 与 Request Cache
Elasticsearch 同时存在 Query Cache 与 Shard Request Cache,但它们缓存的不是同一层结果。本课用一条重复聚合查询串起命中、失效与观测方法,最终能判断某类查询该依赖哪一种缓存,而不是看到“cache”就盲目扩容。
学习目标
- 区分 Query Cache 与 Request Cache 的缓存对象、作用范围和命中条件。
- 根据 refresh、segment 变化和请求内容判断缓存何时失效或难以复用。
- 使用节点统计验证命中率与淘汰情况,并据此选择优化方向。
两类缓存分别省掉什么
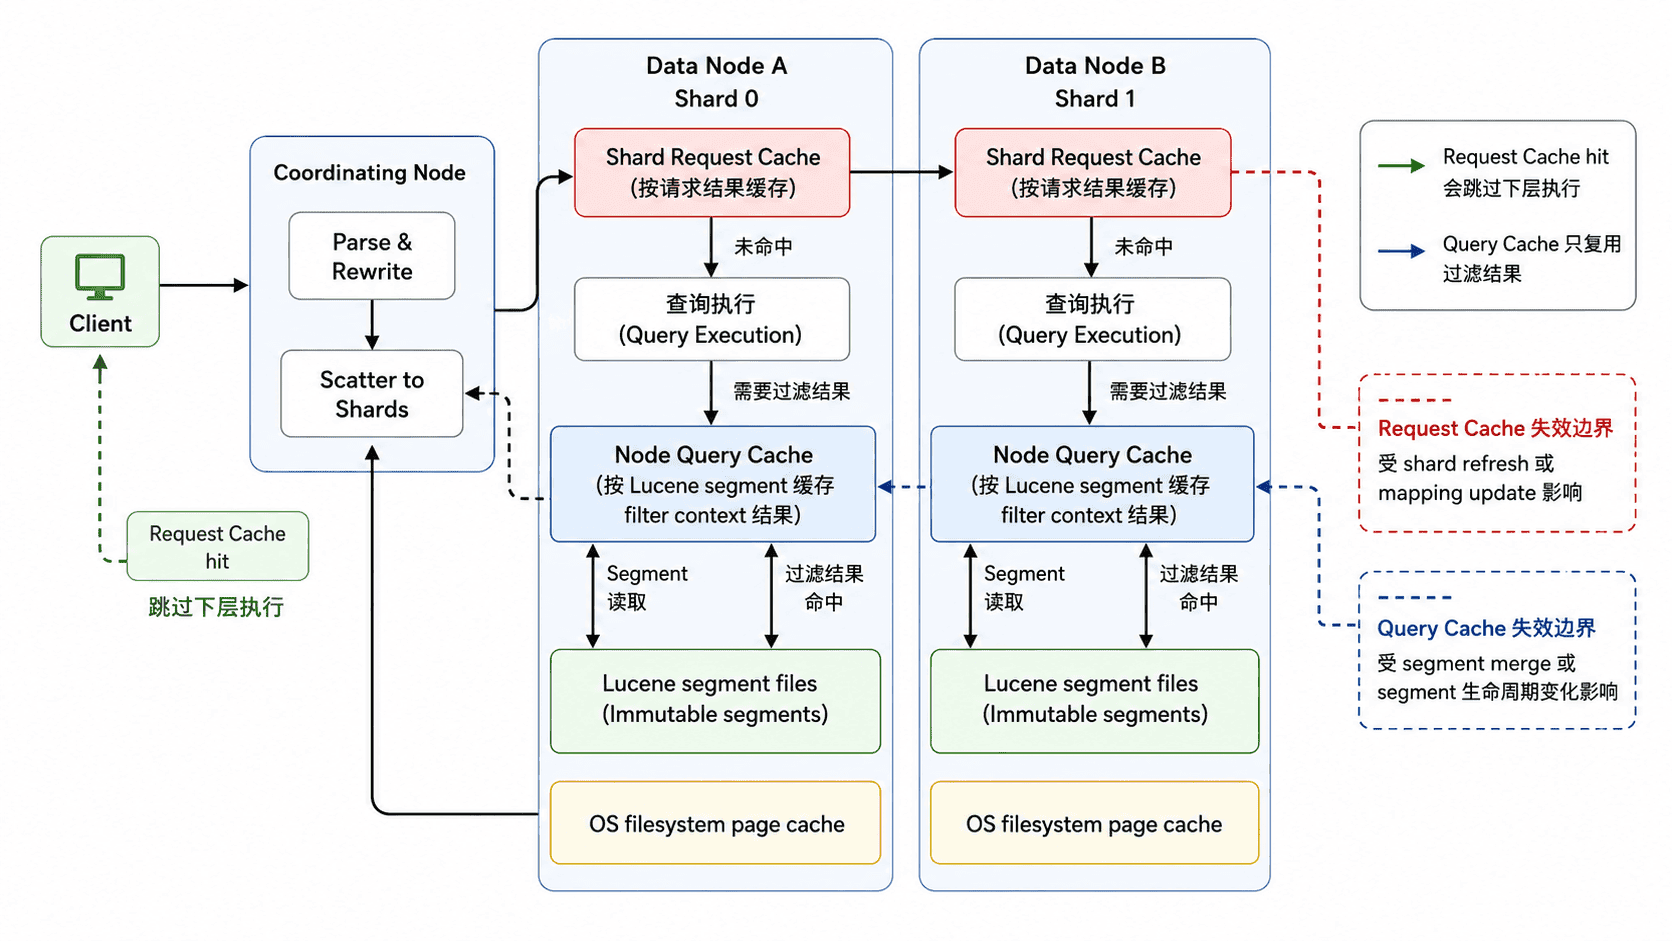
Query Cache 缓存的是 filter context 中可复用的查询结果。它在节点上共享给该节点承载的各个 shard,并按 Lucene segment 保存结果;是否真正缓存还取决于查询历史和内部策略,因此“放进 bool.filter”不等于下一次一定命中。查询不在 filter context 时不能使用这类缓存,一些本来就很便宜的查询也不会被缓存。
Shard Request Cache 位于更靠外的一层:每个 shard 可以缓存一次搜索在本 shard 上产生的完整局部结果,再由 coordinating node 汇总。默认最适合 size: 0 的统计、聚合和 suggestion;频繁重复、请求体稳定、数据不常变化的仪表盘查询通常受益最大。
| 维度 | Query Cache | Shard Request Cache |
|---|---|---|
| 缓存对象 | filter 的匹配结果 | shard-local 搜索结果 |
| 典型收益 | 少做过滤计算 | 少做整段查询与聚合 |
| 主要复用单位 | node 内的 Lucene segment | shard 上的请求 |
| 主要失效边界 | segment 被合并或退出生命周期 | shard refresh、mapping 更新 |
| 常见不命中原因 | 条件变化大、未进入 filter context、使用频率低 | 请求体变化、now、活跃写入导致频繁 refresh |
看清请求经过哪一层
同一条 size: 0 聚合请求可能同时经过两层缓存:Request Cache 若直接命中,下面的查询执行不会发生;Request Cache 未命中时,执行 filter 的过程中才可能复用 Query Cache。两者下面仍然是 Lucene 与操作系统文件页缓存,所以不能把“请求缓存没命中”直接等价为“必然读盘”。
用统计验证,而不是猜命中
下面的命令假设 <INDEX> 已有 @timestamp 与 service.name.keyword 字段,并使用固定 preference 让重复请求尽量落到同一组 shard copy。把 <START_TIME> 与 <END_TIME> 替换为不会随请求变化的固定时间边界,先重复相同聚合,再读取两类缓存统计;测试期间不要写入该索引,否则 refresh 会干扰 Request Cache 观察。
ES_URL="https://localhost:9200"
INDEX="<INDEX>"
CA="<PATH>/http_ca.crt"
AUTH="elastic:<PASSWORD>"

for i in 1 2 3; do
  curl -sS --cacert "$CA" -u "$AUTH" \
    -H 'Content-Type: application/json' \
    -X POST "$ES_URL/$INDEX/_search?request_cache=true&preference=cache-demo" \
    -d '{"size":0,"query":{"bool":{"filter":[{"range":{"@timestamp":{"gte":"<START_TIME>","lt":"<END_TIME>"}}}]}},"aggs":{"by_service":{"terms":{"field":"service.name.keyword","size":10}}}}' \
    >/dev/null
done

curl -sS --cacert "$CA" -u "$AUTH" \
  "$ES_URL/_nodes/stats/indices/query_cache,request_cache?filter_path=nodes.*.name,nodes.*.indices.query_cache.hit_count,nodes.*.indices.query_cache.miss_count,nodes.*.indices.query_cache.evictions,nodes.*.indices.request_cache.hit_count,nodes.*.indices.request_cache.miss_count,nodes.*.indices.request_cache.evictions"
预期输出
{"nodes":{"<ID>":{"name":"<VALUE>","indices":{"query_cache":{"hit_count":<VALUE>,"miss_count":<VALUE>,"evictions":<VALUE>},"request_cache":{"hit_count":<VALUE>,"miss_count":<VALUE>,"evictions":<VALUE>}}}}}实际计数取决于已有流量、segment 大小与缓存历史。小测试索引即使重复 filter,Query Cache 也可能暂时没有 hit;这不是故障,应在真实规模或受控压测中看趋势。
按查询模式选择缓存策略
稳定的结构化过滤条件适合让 Query Cache 自行工作,不要为了“强制命中”改写业务语义。历史只读索引上的固定聚合最适合 Request Cache;活跃写入索引若频繁 refresh,即使请求完全相同,Request Cache 也会不断失效。
如果查询每次都带未取整的 now、随机脚本、不同 JSON 序列化结果或高度变化的参数,Request Cache 很难复用。此时应先稳定请求形态、缩小查询范围或优化聚合,而不是简单增大 indices.requests.cache.size。同理,Query Cache 的 evictions 持续升高才值得评估容量;仅看一次低命中率不足以证明缓存太小。