
NoSQL 与搜索 / 系统课时
排查查询延迟突增
排查查询延迟突增
查询延迟突然升高时,最容易犯的错是立刻改查询或扩容。本课给出一条从端到端现象进入 Elasticsearch 内部,再逐层检查查询、分片、缓存、资源与后台任务的路径,目标是在尽量不扰动现场的前提下缩小根因范围。
学习目标
- 区分客户端端到端延迟与 Elasticsearch 搜索执行时间,避免把网络或排队问题误判成查询本身变慢
- 用节点、任务、分片和缓存指标判断延迟来自热点查询、数据倾斜还是资源争用
- 在定位到具体查询后安全使用 Profile,并用恢复后的基线验证修复效果
先固定故障窗口和比较基线
先记录“从什么时候开始慢、哪些操作慢、哪些索引受影响、P95/P99 增长多少、流量是否同步变化”。同一时间窗口内同时保留客户端端到端延迟与 Elasticsearch 的 took:took 包含协调节点收到请求后的跨节点通信、搜索线程池排队、执行和结果汇聚,但不包含请求发往 Elasticsearch、响应序列化和回传客户端的时间。两者差值异常增大时,应把网关、网络或响应体规模也纳入排查。:contentReference[oaicite:0]{index=0}
第一轮只做低扰动采集。下面的命令读取集群健康、搜索线程池、JVM、CPU、搜索累计时间以及两类缓存统计。生产环境应使用具备 monitor 权限的只读 API Key。
export ES_URL="https://localhost:9200"
export ES_API_KEY="<API_KEY>"

curl -sS -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/_cluster/health?filter_path=status,number_of_pending_tasks,active_shards_percent_as_number"

curl -sS -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/_nodes/stats/indices,thread_pool,jvm,os?filter_path=nodes.*.name,nodes.*.indices.search.query_current,nodes.*.indices.search.query_total,nodes.*.indices.search.query_time_in_millis,nodes.*.indices.query_cache.hit_count,nodes.*.indices.query_cache.miss_count,nodes.*.indices.query_cache.evictions,nodes.*.indices.request_cache.hit_count,nodes.*.indices.request_cache.miss_count,nodes.*.indices.request_cache.evictions,nodes.*.indices.merges.current,nodes.*.indices.refresh.total_time_in_millis,nodes.*.thread_pool.search.active,nodes.*.thread_pool.search.queue,nodes.*.thread_pool.search.rejected,nodes.*.jvm.mem.heap_used_percent,nodes.*.os.cpu.percent"
预期输出
两个请求都返回 JSON。
重点比较同一故障窗口前后的增量:
search.queue / search.rejected=<VALUE>
heap_used_percent / cpu.percent=<VALUE>
query_cache 与 request_cache 的 hit、miss、evictions=<VALUE>
search.query_total / search.query_time_in_millis=<VALUE>累计计数应比较固定时间间隔内的增量,search.queue、CPU 和堆使用率这类当前值则比较峰值与节点差异。如果只有少数节点的搜索队列、CPU 或查询时间明显抬升,优先怀疑热点分片或请求路由不均;如果所有节点同步变慢,再检查流量、查询形态和后台任务。
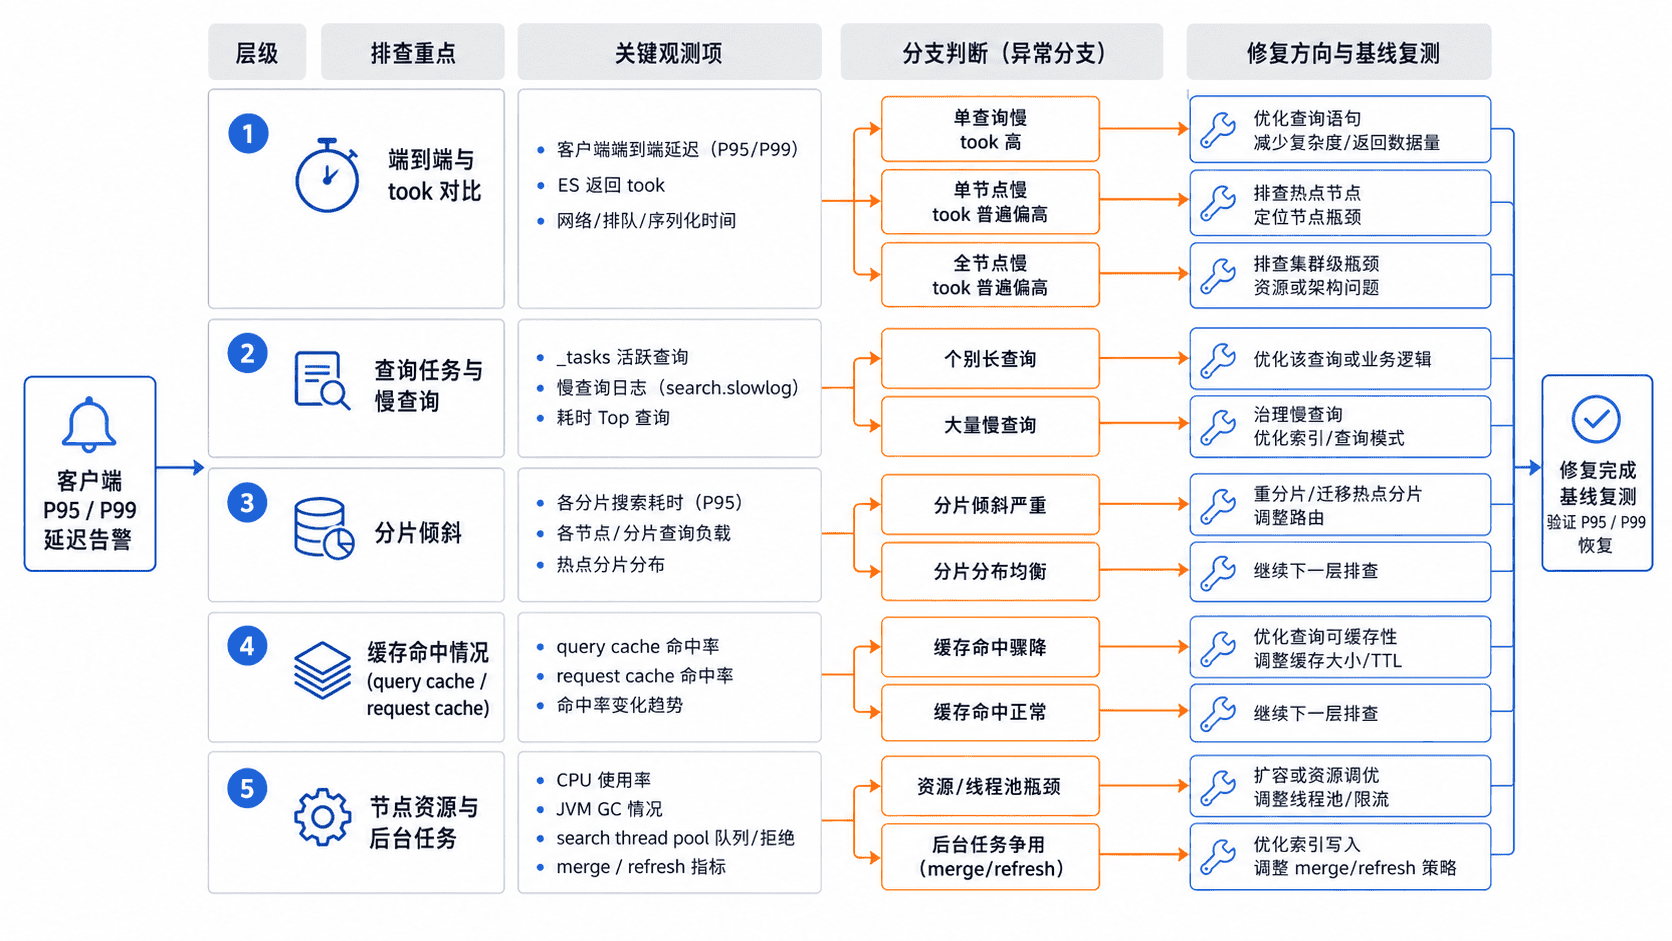
从查询和分片判断是不是局部热点
如果延迟是“突然”出现,先看当前是否有长时间运行的搜索任务,再看分片是否明显倾斜。Task API 能列出当前运行的搜索工作,detailed=true 会增加描述信息;它适合现场定位,但只代表仍在运行的任务。:contentReference[oaicite:1]{index=1}
curl -sS -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/_tasks?actions=*search&detailed=true&group_by=parents"

curl -sS -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/_cat/shards/<INDEX>?h=index,shard,prirep,state,docs,store,node&s=store:desc"
预期输出
_tasks:若存在在途搜索,返回对应 task;没有匹配任务时结果可能为空。
_cat/shards:按 store 从大到小列出 <INDEX> 的分片,可直接比较 docs、store 与 node 是否明显失衡。
任务长时间运行且集中在某个操作签名,先回溯调用方、参数和时间范围;分片大小或文档量明显偏斜,则继续检查 routing、时间分区和分片规划。若慢日志只集中在同一分片或节点,也要优先处理数据倾斜,而不是只重写 DSL。
把缓存和资源争用放在同一时间轴
缓存命中下降本身不一定是根因。查询条件或时间范围变化、刷新频率升高、请求被分散到不同 shard copy,都可能让历史命中率失效。应把 query_cache、request_cache 的 hit/miss/evictions 与搜索吞吐、CPU、堆、线程池队列同时对齐。
资源层重点看“谁在抢时间片”。搜索队列持续增长或 rejected 增加,说明搜索执行能力已经跟不上进入速率;CPU 高但搜索吞吐没有增长,要继续看热点线程;堆压力频繁升高则检查聚合、字段数据、并发和大结果集。后台 merge、refresh 或高强度索引也可能与查询争抢 CPU、磁盘和页缓存。
curl -sS -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/_nodes/hot_threads?threads=3&ignore_idle_threads=true"

curl -sS -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/_cluster/pending_tasks"
预期输出
hot_threads:返回各节点最热线程的纯文本采样;重点识别搜索、聚合、merge、GC 等重复栈。
pending_tasks:返回尚未完成的 cluster-state 更新;正常情况下不应长期堆积高等待任务。
Hot Threads 用于看节点当前最耗 CPU、等待或阻塞的线程;Pending Cluster Tasks 只表示尚未完成的集群状态更新,与普通搜索 Task API 不是同一类队列。:contentReference[oaicite:2]{index=2}
最后才对具体查询做 Profile
当证据已经指向某个稳定复现的查询时,再到隔离环境或低风险窗口使用 Profile。Profile 会显著增加执行开销,而且不统计网络延迟、请求排队或协调节点合并结果的等待,因此它适合比较查询组件的相对成本,不适合拿来当真实线上延迟。:contentReference[oaicite:3]{index=3}
curl -sS -X POST -H "Authorization: ApiKey $ES_API_KEY" -H "Content-Type: application/json" "$ES_URL/<INDEX>/_search?filter_path=took,profile" -d '{
  "profile": true,
  "size": 0,
  "query": {
    "term": {
      "status": "active"
    }
  }
}'
预期输出
HTTP 200,响应包含 took 与 profile。
profile 中可继续下钻到各 shard 的 query、collector、aggregation 等耗时明细;实际数值为 <VALUE>。
修复后不要只验证“这条查询变快了”。应回到最初故障窗口的同一组指标,确认 P95/P99、搜索队列、拒绝数、CPU/堆和缓存增量都恢复到可接受区间,并至少覆盖一个完整业务峰值或等价压测窗口。