
NoSQL 与搜索 / 系统课时
设计容量、延迟与可用性告警
设计容量、延迟与可用性告警
告警的目标不是把所有指标都设一个阈值,而是在用户受影响前识别容量与恢复风险,并在真正故障时给值班人员足够的定位证据。本课把资源水位、请求 SLI、分片状态和恢复进度组合成一套可行动的告警模型。
学习目标
- 区分用户可用性、集群风险和资源容量三类告警信号
- 用组合条件与持续时间降低单指标告警的噪声
- 通过 Elasticsearch API 为告警附带可直接排查的上下文
先把信号分成结果、风险和容量
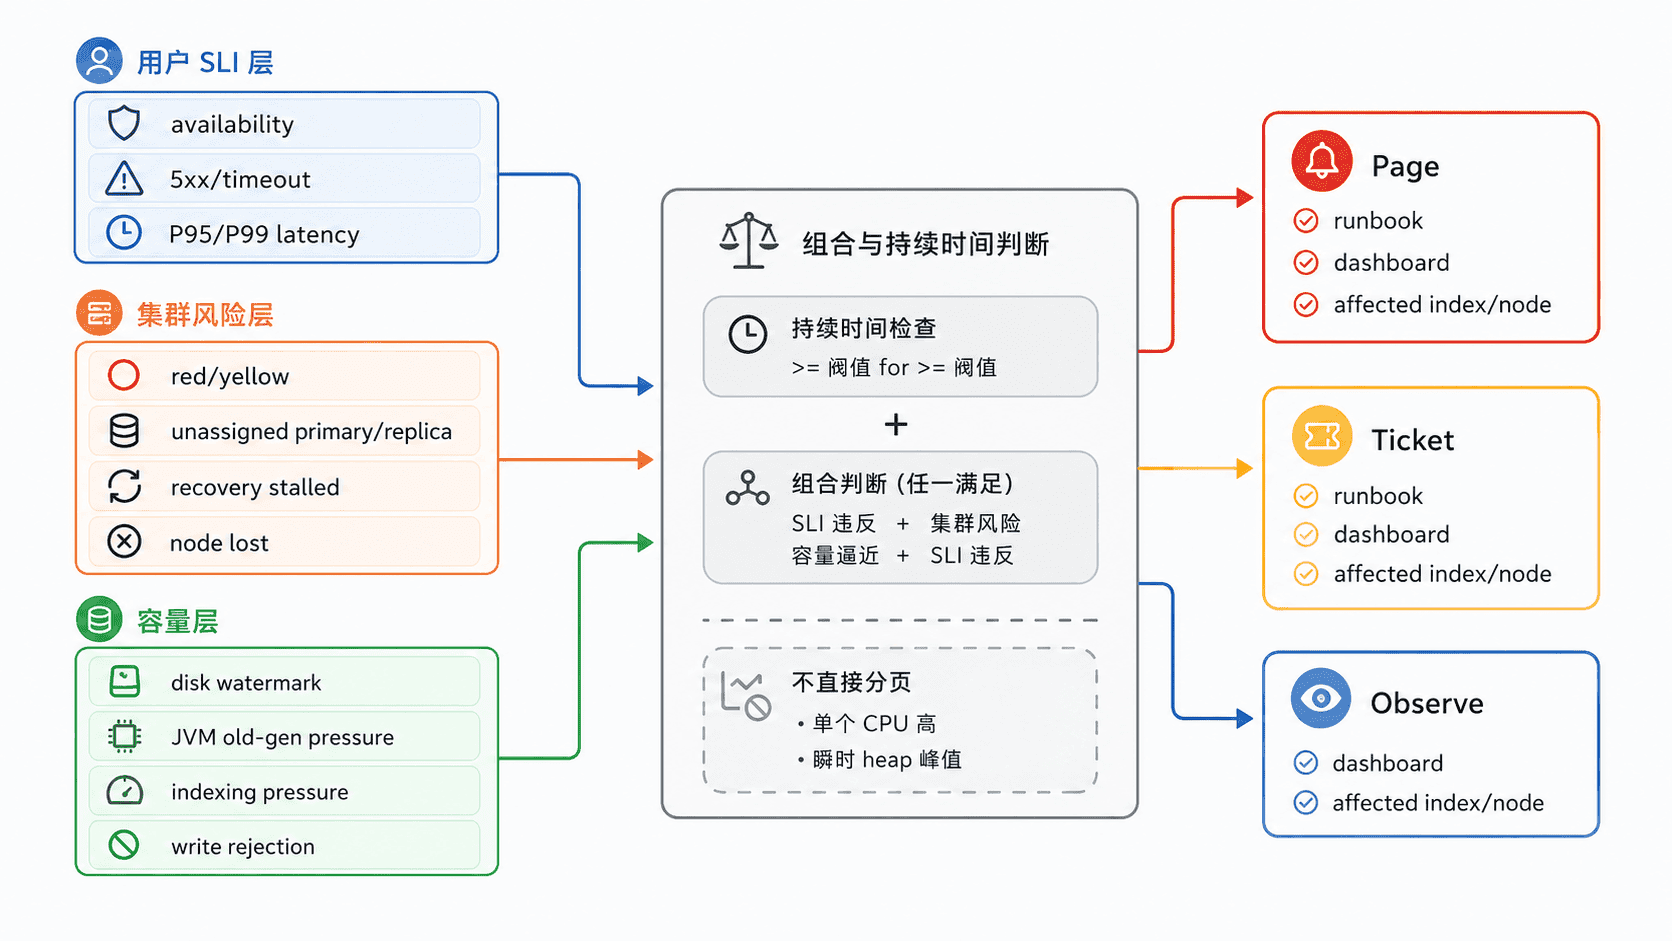
最需要叫醒人的信号通常不是 CPU 高,而是“请求已经失败”或“冗余已经失效”。因此应先按故障距离分层:用户结果层看错误率与 P95/P99 延迟,集群风险层看 red、持续 yellow、未分配分片和恢复停滞,容量层再看磁盘、JVM old 区压力、indexing pressure 与线程池拒绝。
Elasticsearch 默认磁盘水位可作为容量保护边界:low 约为 85% 已用、high 约为 90%、flood stage 约为 95%。它们是分配与写保护机制的默认触发点,不等于你的业务告警阈值;生产告警应在真正触发保护动作之前留出扩容和迁移时间。
| 告警族 | 主信号 | 需要关联的证据 | 建议动作 |
|---|---|---|---|
| 可用性 | 主分片不可用、请求 5xx/timeout 超过 SLO | red、受影响索引、节点变化 |
Page |
| 延迟 | P95/P99 持续超过业务目标 | 流量、429、GC、写入或搜索队列 | Page 或 Ticket |
| 恢复风险 | yellow 持续、未分配副本、恢复长期无进展 |
recovery、allocation explain、磁盘余量 | Ticket,风险扩大时 Page |
| 容量 | 磁盘逼近水位、old 区压力长期偏高、indexing pressure 拒绝增加 | 增长速率、热点节点、剩余容量 | Ticket 或扩容计划 |
用组合条件决定告警级别
阈值要与“持续时间、最小流量、故障范围”一起使用。下面是一组可作为起点的规则,而不是通用标准:red 或未分配主分片可直接进入高优先级;P99 超过 SLO 需要同时满足最小请求量,避免低流量抖动;持续 yellow 只有在副本长期无法恢复、节点持续缺失或磁盘阻止分配时才升级。
JVM 也不要只盯瞬时 heap 百分比。更有意义的是 old 区的持续内存压力,以及它是否伴随长 GC、circuit breaker 或请求拒绝。类似地,CPU 高但延迟稳定、队列为空时通常只是繁忙;CPU 高且 429、队列积压和延迟一起上升,才接近可行动的饱和事件。
采集能解释告警的证据
下面的命令一次采集集群健康、节点容量压力和当前恢复任务。需要具备 monitor 集群权限,并先设置 Elasticsearch 地址和 API Key。
export ES_URL="https://<HOST>:<PORT>"
export ES_API_KEY="<API_KEY>"

printf '=== cluster ===\n'
curl -sS -H "Authorization: ApiKey $ES_API_KEY"   "$ES_URL/_cluster/health?filter_path=status,number_of_nodes,unassigned_shards,unassigned_primary_shards,initializing_shards,relocating_shards,active_shards_percent_as_number"

printf '\n=== node pressure ===\n'
curl -sS -H "Authorization: ApiKey $ES_API_KEY"   "$ES_URL/_nodes/stats/fs,jvm,thread_pool,indexing_pressure?filter_path=nodes.*.name,nodes.*.fs.total.available_in_bytes,nodes.*.jvm.mem.pools.old,nodes.*.thread_pool.write.rejected,nodes.*.thread_pool.write_coordination.rejected,nodes.*.indexing_pressure.memory.current,nodes.*.indexing_pressure.memory.limit_in_bytes"

printf '\n=== recovery ===\n'
curl -sS -H "Authorization: ApiKey $ES_API_KEY"   "$ES_URL/_cat/recovery?active_only=true&format=json&h=index,shard,stage,source_node,target_node,bytes_percent"
预期输出
=== cluster ===
{"status":"yellow","number_of_nodes":3,"unassigned_shards":1,"unassigned_primary_shards":0,"initializing_shards":0,"relocating_shards":0,"active_shards_percent_as_number":<VALUE>}
=== node pressure ===
{"nodes":{"<ID>":{"name":"es01","fs":{"total":{"available_in_bytes":<VALUE>}},"jvm":{"mem":{"pools":{"old":{"used_in_bytes":<VALUE>,"max_in_bytes":<VALUE>}}}},"thread_pool":{"write":{"rejected":0},"write_coordination":{"rejected":0}},"indexing_pressure":{"memory":{"current":{"all_in_bytes":0},"limit_in_bytes":<VALUE>}}}}}
=== recovery ===
[]
实际节点 ID、容量和百分比会不同。这里的 yellow 示例表示主分片仍可用但存在未分配副本;如果 recovery 为空且状态长期不恢复,应继续查 _cluster/allocation/explain,而不是只等待健康颜色变化。
让告警天然带着排障方向
每条告警至少应携带四类上下文:受影响的集群或索引、触发窗口内的原始数值、相关节点或分片、对应 runbook。这样值班人员收到“写入 429 上升”时,可以同时看到 indexing pressure、write/write_coordination rejection、磁盘余量和 JVM 压力,而不是再从零拼接证据。
还要处理抑制关系。例如集群已经 red 时,可以抑制由同一故障派生的大量索引级错误告警;计划滚动重启期间,短暂 yellow 可以进入维护窗口,但未分配主分片和用户错误率仍不应被静默。告警去重的依据应是同一根因,而不是简单按名称合并。
验收一条告警是否可行动
上线前用三个问题验收:它是否描述了用户影响或明确风险;值班人员是否能从告警直接知道先查什么;故障恢复后是否能自动关闭且不会残留。若一条告警只能说明“某指标很高”,却不能指向容量扩展、流量削峰、分片恢复或节点修复中的某个动作,它更适合放在仪表盘,而不是进入分页通道。