
NoSQL 与搜索 / 系统课时
看懂请求路由与分布式执行
看懂请求路由与分布式执行
本课解决“一个请求到底落到哪些节点和分片”这个问题。你会沿着协调节点、目标分片、副本与结果归并追踪读写路径,并用路由 API 验证一次查询实际会触达的分片范围。
学习目标
- 解释协调节点在读写请求中的职责,而不是把它误认为固定的专用节点。
- 区分写请求的主分片复制链路与搜索请求的分散、归并链路。
- 使用
_search_shards判断routing是否有效缩小搜索分片范围。
协调节点如何决定请求去向
客户端可以把请求发给任意能够接收 HTTP 请求的节点。收到请求的节点会充当本次请求的协调节点,根据本地持有的集群状态解析索引、分片位置和可用副本,再把子请求直接转发到相关数据节点;普通搜索和写入并不需要先经过当前主节点转发。
这里要区分“节点角色”和“请求角色”:每个节点都具备协调能力,专用 coordinating-only 节点只是移除了其他主要角色。协调搜索尤其消耗 CPU 与堆内存,因为它要收集多个分片的候选结果、排序或聚合并生成最终响应。
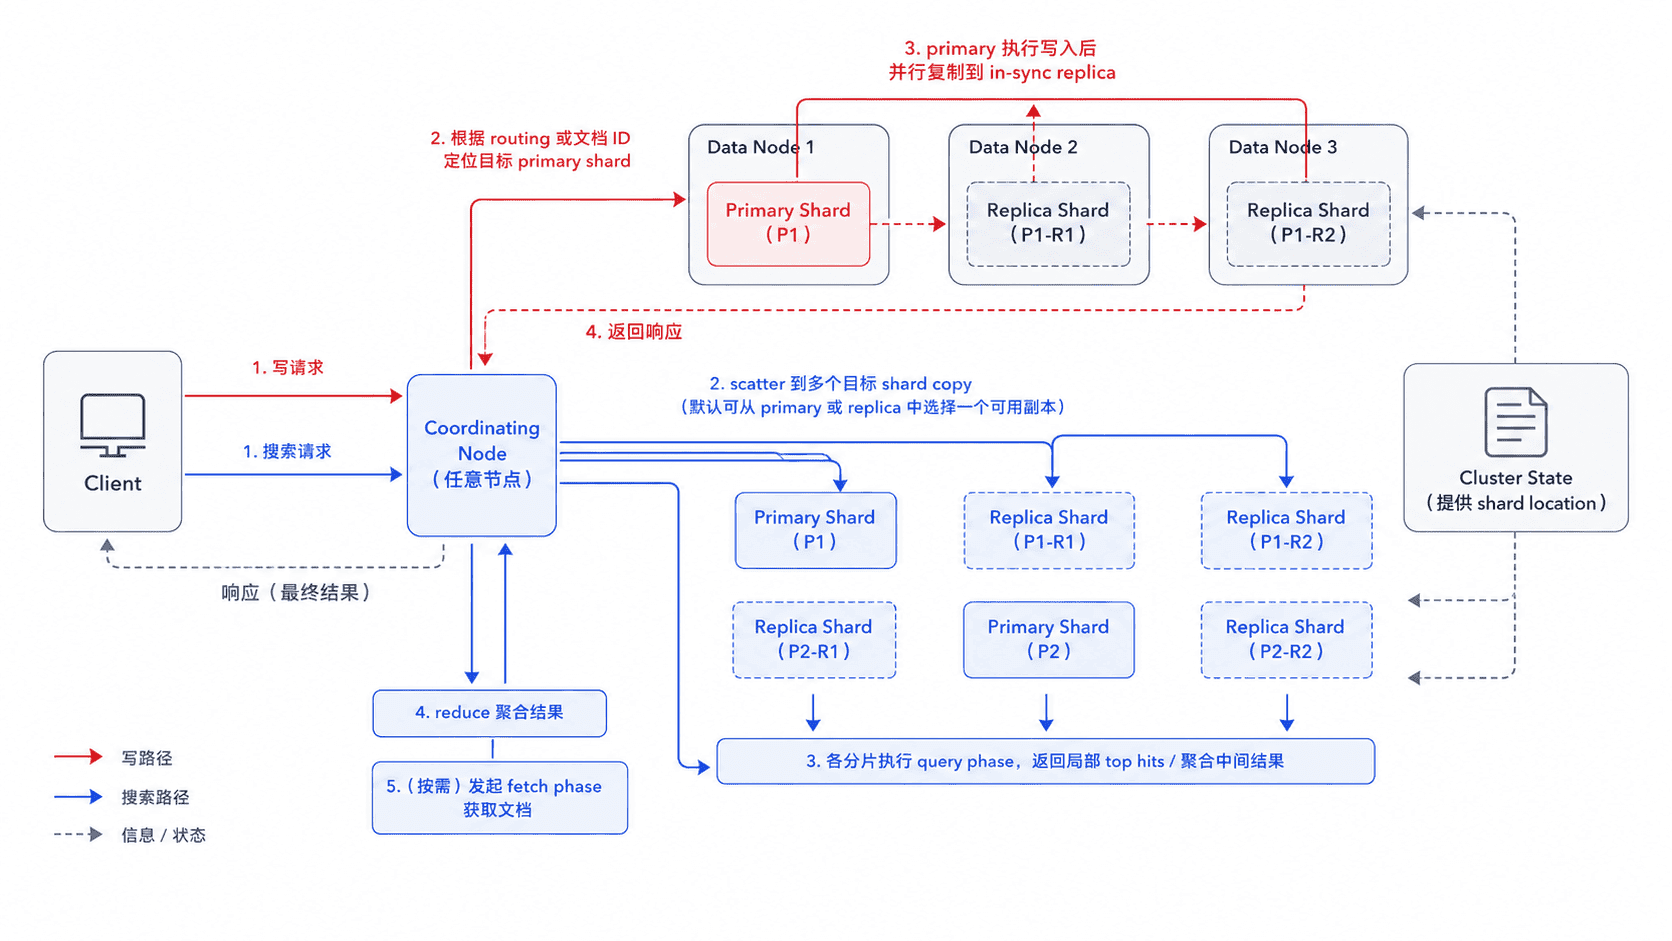
写请求先找到主分片
索引、更新和删除最终都针对一个主分片。协调节点根据 _routing 计算目标分片;未显式提供时,通常使用文档 _id 参与路由。请求先到该分片的 primary,primary 完成本地操作后把同一操作转发给当前 in-sync replicas,最后由协调节点把结果返回客户端。
因此,增加副本不会把一次写入分散到多个主分片并行完成,反而会增加复制工作量。自定义 routing 能让同一租户或实体稳定落在确定分片,但如果 routing 值分布不均,也会制造热点分片。
搜索经历分散与归并
普通搜索可能同时命中多个主分片。协调节点会为每个目标分片选择一个可用副本执行查询,默认会结合自适应副本选择来避开响应慢或队列较长的候选节点,而不是固定只读 primary。
搜索可以理解为两个核心阶段:先把查询分散到目标分片,各分片返回局部候选结果或聚合中间值;协调节点完成全局归并后,再向持有命中文档的分片获取需要返回的文档内容。分页越深、排序候选越多,协调节点需要持有和归并的数据通常也越多。
用 routing 验证目标分片
下面在一个三主分片测试索引上比较默认搜索与指定 routing 后的分片范围。示例假设本机 Elasticsearch 无认证;生产环境请改用实际地址与认证方式。
ES_URL="${ES_URL:-http://localhost:9200}"

curl -sS -X PUT "$ES_URL/route-demo" -H 'Content-Type: application/json' -d '{"settings":{"number_of_shards":3,"number_of_replicas":0}}'

curl -sS "$ES_URL/route-demo/_search_shards?filter_path=shards.index,shards.shard,shards.primary,shards.state"

curl -sS "$ES_URL/route-demo/_search_shards?routing=tenant-a&filter_path=shards.index,shards.shard,shards.primary,shards.state"
预期结果
第一个请求:acknowledged=true,索引 route-demo 创建成功。
第二个请求:shards 包含 3 个分片组,对应 3 个主分片。
第三个请求:shards 只包含 1 个分片组;实际 shard 编号取决于 routing 哈希结果,state 应为 STARTED。
_search_shards 只告诉你“这次搜索会去哪些分片”,不会执行真正查询。看到自定义 routing 把三个分片缩成一个,只能证明路由范围变小;是否值得使用,还要继续检查 routing 基数、热点风险以及业务查询是否始终携带同一 routing 值。